


WASHINGTON, DISTRICT OF COLUMBIA / LONDON (IT BOLTWISE) – DVIDS veröffentlicht ein Foto vom „Great American State Fair Military Appreciation Day“ mit konkreten Metadaten wie Date Taken (06.28.2026), Photo ID und VIRIN. Für Unternehmen und Behörden ist das mehr als Archivmaterial: KI-gestützte Katalogisierung kann dabei helfen, Inhalte automatisch zu klassifizieren, Copyright- und Nutzungsregeln nachvollziehbar zu machen und Auffindbarkeit per Suche zu verbessern. Entscheidend ist dabei ein auditierbarer Workflow, der Metadaten nicht „vermutet“, sondern prüfbar ausliest. Genau hier trennt sich automatisierte Verwaltung von unsicherer Magie.
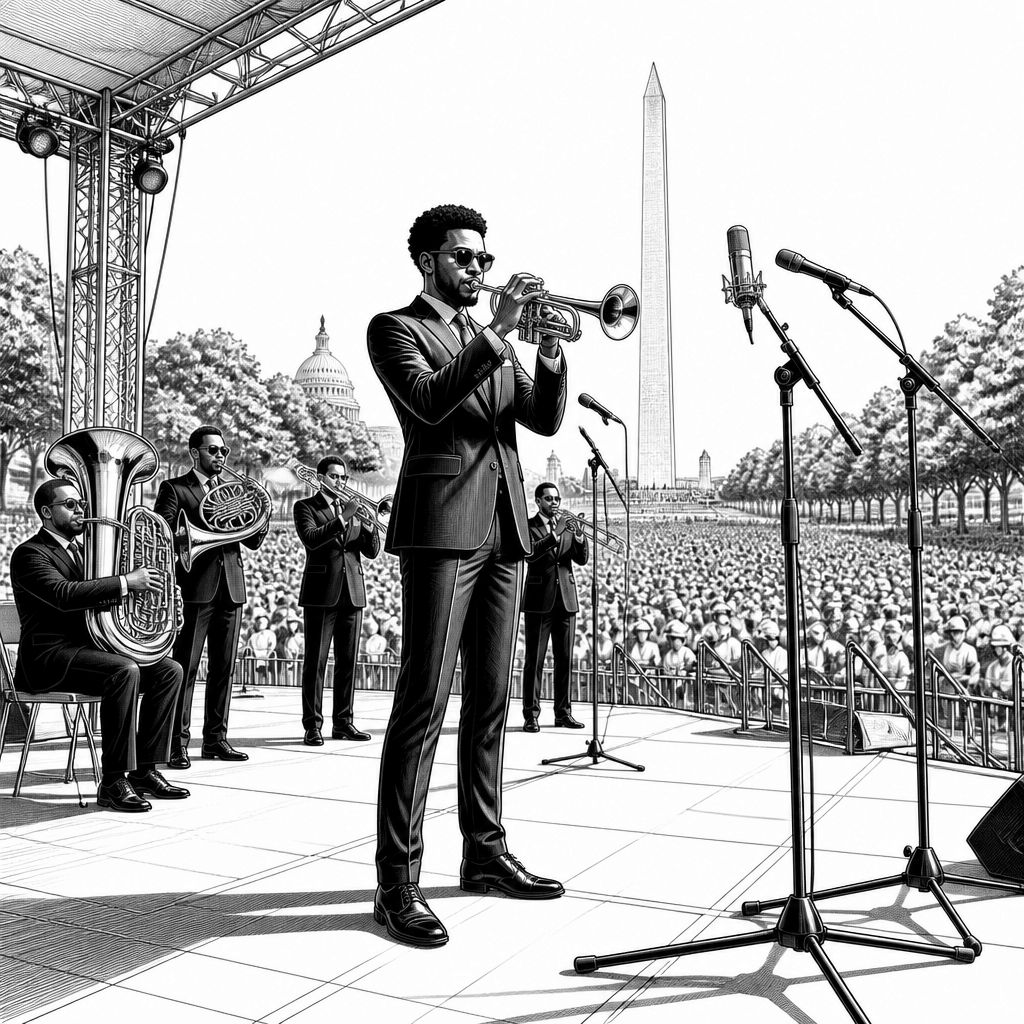
Auf den ersten Blick wirkt die Meldung wie das, was man in Medienarchiven oft nur kurz scannt: „Great American State Fair Military Appreciation Day“ am National Mall in Washington, D.C., aufgenommen am 28.06.2026. Die DVIDS-Beschreibung liefert aber typische technische Bausteine eines modernen Asset-Managements: Photo ID 9780750, VIRIN 260628-A-JM103-1093, Auflösung 6720×4480 und sogar den Hinweis „PUBLIC DOMAIN“ plus die Verpflichtung, die Copyright-Richtlinien auf der DVIDS-Plattform einzuhalten. Genau solche strukturierten Metadaten sind der Stoff, aus dem Künstliche Intelligenz später verlässliche Prozesse bauen kann, statt nur „Tags“ zu raten.
Technisch gesehen beginnt der Mehrwert häufig bereits beim Ingest: Metadaten-Parser extrahieren Felder aus Text und HTML, normalisieren Datumsformate und validieren, ob die Kombination aus VIRIN, Auflösung und Date Posted plausibel ist. Ergänzend kann OCR bei Bildunterschriften oder eingebetteten Texten helfen, falls zusätzliche Informationen in Dateianhängen oder Vorschaubildern stecken. Für die Qualitätssicherung nutzt man dann Regeln und Heuristiken, um Widersprüche zu erkennen: Wenn eine Quelle etwa eine „PUBLIC DOMAIN“-Kennzeichnung trägt, sollte der Compliance-Status im System nicht nur gesetzt, sondern auch mit der jeweiligen Richtlinie verknüpft werden. Ein gutes KI-System lernt hier aus dem Schema, nicht aus Zufall.
Beim Vergleich mit gängigen Wettbewerbsansätzen sieht man schnell, warum Architektur entscheidend ist. Viele Teams starten mit Cloud-Services wie Google Cloud Vision oder AWS Rekognition, um Bildinhalte automatisch zu klassifizieren. In der Praxis reicht das aber selten, weil Veranstaltungs- und Medienarchive oft proprietäre Metadatenmodelle verwenden und zusätzlich rechtliche Einschränkungen abbilden müssen. Branchenexperten empfehlen deshalb einen zweistufigen Stack: Erstens Content-Understanding (Objekte, Personen, Text) für Suche und Navigation, zweitens ein Governance-Layer, der Nutzungsrechte, Quellenhinweise und „audit trails“ strikt aus den Primärfeldern ableitet. KI wird dadurch zum Assistenzsystem, nicht zum Rechtsgutachten.
Der Markt für KI-gestützte Asset-Workflows wächst gerade dort besonders schnell, wo Medienvolumen und Compliance-Risiko zusammenkommen: Öffentlich-rechtliche Institutionen, Verteidigungs- und Sicherheitsbehörden, aber auch PR-Abteilungen großer Unternehmen mit internationaler Ausspielung. In der Ausgangsmeldung sind keine „KI“-Claims enthalten, aber sie zeigt ein realistisches Problem: Man muss tausende Einträge mit ähnlichem Aufbau konsistent verwalten. Wenn Web Views (hier: 6) und Downloads (hier: 0) zusammen mit Identifikatoren wie Photo ID und VIRIN gespeichert werden, lässt sich später auch Metrik-gestützte Qualität messen, etwa welche Klassifikationen zu auffindbaren Ergebnissen führen. Die eigentliche Marktfrage lautet dann: Wie schnell macht das System bessere Suche, ohne neue rechtliche Risiken einzuführen?
Historisch war Medienkatalogisierung lange stark regelbasiert: Menschen haben VIRINs manuell geprüft, Copyright-Labels in Datenbanken gepflegt und Suchindizes aufgebaut. Mit dem Aufkommen von Deep-Learning-Modellen (Vision-Transformer, Transformer-basierte OCR und Embedding-Modelle für semantische Suche) wurde der nächste Schritt möglich: Inhalte lassen sich nicht nur nach Metadaten, sondern auch nach Bedeutung durchsuchen. Der Haken ist die „Stille“ der Fehler: Ein falsches Tag wirkt zunächst harmlos, kann aber in späteren Workflows zu falscher Wiederverwendung führen. Genau deshalb setzen reife Teams auf Kombinationen aus deterministischen Regeln (z.B. „PUBLIC DOMAIN“ erfordert Link zur Richtlinie) und KI-gestützten Vorschlägen mit expliziter Unsicherheitsbewertung. Nur wenn der Confidence-Score hoch ist und die Metadatenprüfung besteht, wird automatisiert freigegeben.
Regulatorisch ist das für Unternehmen spätestens dann relevant, wenn Medien nicht isoliert bleiben, sondern in Marketingkanälen, internen Wissensdatenbanken oder sogar Kundenportalen landen. Auch wenn der konkrete Eintrag „PUBLIC DOMAIN“ nennt, muss die Nutzungsfähigkeit praktisch nachgewiesen werden: Wer den Content weiterverwendet, braucht Transparenz, wie das System zu seinem Ergebnis kam. In einem auditierbaren Setup protokolliert ein Compliance-Service pro Asset, welche Felder extrahiert wurden, welche Textstellen aus der Quelle verwendet wurden und welche Richtlinienreferenzen gespeichert sind. Gleichzeitig adressiert man Datenschutzfragen, wenn Bildinhalte personenbezogene Daten enthalten könnten; selbst in öffentlichen Archiven sollte man daher eine klare Policy für Gesichts-/Personenerkennung definieren und soweit möglich auf organisatorische Freigaben ausrichten.
Aus Enterprise-Sicht ist die technische Vergleichsfrage dabei weniger „Welche KI ist am besten?“, sondern „Welche KI ist am kontrolliertesten?“. Bei klassischen Ansätzen wird eine Klassifikation einmal ausgeführt und als Ergebnis gespeichert. Besser ist ein Modell, das kontinuierlich überwacht: Drift-Detection vergleicht die Verteilung neuer Metadaten gegen historische Muster, und ein Schema-Validator stellt sicher, dass Pflichtfelder wie Photo ID, VIRIN oder Resolution nie leer bleiben. Für die Suche arbeitet man häufig mit Vektorindexen (Embeddings) und kombiniert sie mit Volltextsuche über Metadaten. So kann ein Nutzer nach „National Mall“ oder nach einem VIRIN suchen und erhält konsistente Treffer. KI liefert Relevanz, die Datenbank liefert Wahrheit.
Für die Zukunft ergibt sich eine klare Roadmap: Erstens verbessern viele Teams die Extraktionstiefe, indem sie Bildunterschriften strukturierter erfassen und mehr Felder in ein einheitliches Metadatenmodell mappen. Zweitens wird „Policy-Aware AI“ wichtiger: Modelle schlagen nicht nur Tags vor, sondern prüfen direkt gegen Richtlinien, z.B. ob ein „PUBLIC DOMAIN“-Status mit den jeweils referenzierten Bedingungen kompatibel ist. Drittens wächst der Bedarf an schnelleren Freigabezyklen. Besonders spannend wird das, wenn KI automatisch „Ähnlichkeitsclustering“ für Serienbilder macht—etwa mehrere Aufnahmen desselben Events—und so Redundanz reduziert. Für Entwickler öffnet das konkrete Möglichkeiten in MLOps: Observability für KI-Schritte, versionierte Datenpipelines und wiederholbare Audits.
Damit bleibt als Kernbotschaft: Selbst eine scheinbar harmlose Fotomeldung enthält ein Muster, das KI-gestützte Medienverwaltung effizienter und gleichzeitig verantwortbarer machen kann. Entscheidend ist, dass aus Metadaten wie Date Taken, Photo ID, VIRIN und Auflösung ein technisches „Vertragsobjekt“ wird, das Governance auf die gleiche Datenbasis stützt wie Suche und Katalogisierung. Wenn Unternehmen diesen Weg gehen, profitieren sie von besserer Wiederauffindbarkeit, geringerer manueller Pflege und sauber dokumentierten Compliance-Entscheidungen—ohne dass Künstliche Intelligenz die rechtliche Verantwortung „übernimmt“. Genau solche Systeme werden in der Praxis den Unterschied zwischen schnellerem Archiv und belastbarem, enterprise-tauglichem Medienbetrieb ausmachen.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- NIEDLICHER BEGLEITER: Eilik ist der ideale Begleiter für Kinder und Erwachsene, die Haustiere, Spiele und intelligente Roboter lieben. Mit vielen Emotionen, Bewegungen und interaktiven Funktionen.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "KI für Medien-Compliance: DVIDS-Fotometadaten auswerten und sicher katalogisieren" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "KI für Medien-Compliance: DVIDS-Fotometadaten auswerten und sicher katalogisieren" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »KI für Medien-Compliance: DVIDS-Fotometadaten auswerten und sicher katalogisieren« bei Google Deutschland suchen, bei Bing oder Google News!