


LONDON (IT BOLTWISE) – Google DeepMind stellt mit EmbeddingGemma 2 ein kompaktes Open-Weight-Embedding-Modell mit 740 Millionen Parametern vor. Das Modell übersetzt Text, Bilder, Videoframes und Audio in einen gemeinsamen Vektorraum direkt auf Endgeräten. Damit lassen sich multimodale lokale Suchfunktionen mit deutlich geringerer Latenz und ohne Cloud-Anbindung umsetzen. Ergänzend kommt eine experimentelle macOS-App namens Google AI Edge Foresight, die ein lokales Meeting-Wissen aufbaut und offline hilft.
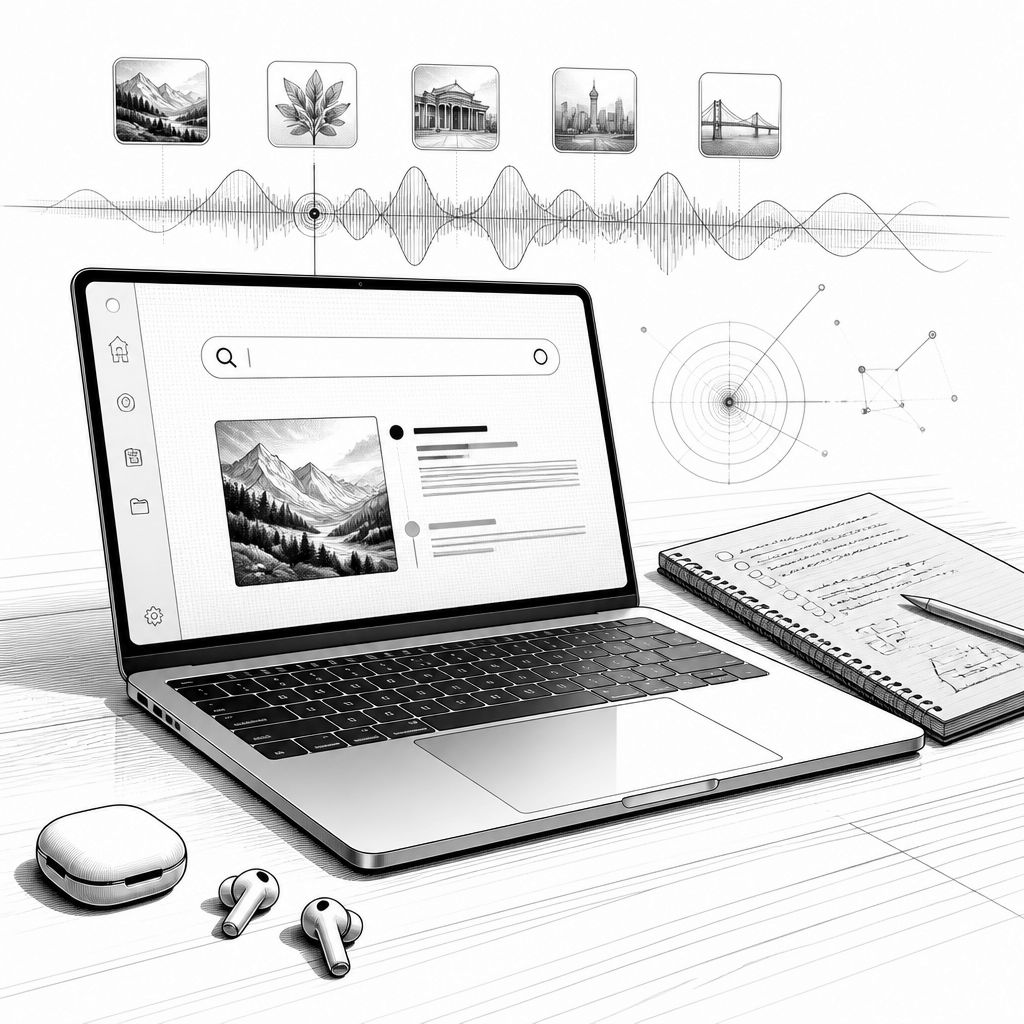
Google DeepMind macht „lokale Suche“ auf einmal deutlich breiter anschlussfähig: Mit EmbeddingGemma 2 präsentiert das Team ein kompaktes Open-Weight-Modell, das unterschiedliche Medienarten in einen gemeinsamen Vektorraum überführen soll. Konkret geht es um Text, Bilder, Videoframes und Audio, die nicht erst an einen entfernten Dienst übergeben werden müssen, sondern auf dem Gerät verarbeitet werden können. Für Entwickler ist das vor allem deshalb spannend, weil multimodale Anwendungen bisher oft auf einer Kette aus spezialisierten Modellen beruhten: erst eine Bildbeschreibung, dann eine Spracherkennung und schließlich separate Text-Embeddings, die am Ende wieder zusammengesetzt werden mussten. EmbeddingGemma 2 soll diesen Workflow am Stück vereinfachen und so die Latenz sowie die Integrationskomplexität im Produkt senken.
Technisch setzt das Modell laut Google auf modulare Encoder. Für Entwickler liefert das vor allem eine greifbare Dimensionierung: Das reine Textmodell soll rund 191 MB Arbeitsspeicher benötigen, während die vollständige multimodale Variante etwa 567 MB RAM beansprucht. Diese Aufteilung ist für die Praxis entscheidend, weil sie unterschiedliche Produktprofile erlaubt. Wer etwa zunächst nur Dokumente, Notizen und Transkripte durchsuchen will, kann mit dem Textpfad starten und später um Bild- oder Audio-Interpretation erweitern. Wer hingegen von Beginn an Videoframes und Audio als Suchgrundlage nutzen will, kann auf die volle multimodale Konfiguration gehen. In beiden Fällen zielt die Beschreibung klar darauf, dass die Verarbeitung rein lokal abläuft, keine Cloud-Anbindung benötigt wird und Daten den Rechner nicht verlassen.
In der Anwendungsebene wird der Vorteil dieser Architektur besonders greifbar: Niedrige Latenzen und Offline-Fähigkeit sind in Szenarien wie Meetings oder Live-Assistenz oft der Unterschied zwischen „nice to have“ und „tatsächlich nutzbar“. Genau dort setzt Google mit der experimentellen Anwendung „Google AI Edge Foresight“ für macOS an. Die App greift direkt auf Systemaudio sowie das Mikrofon zu, wodurch sie unabhängig von konkreten Konferenz-Tools funktionieren soll. Damit kann ein Meeting-Assistant Beiträge aus dem aktuellen Gesprächstranskript ableiten und diese Informationen als lokale Wissensbasis nutzen – ohne dass die Daten den Mac verlassen. Google betont zudem den Offline-Betrieb und stellt die App als kostenlos zum Ausprobieren in Aussicht; Abo-Kosten werden in der Beschreibung explizit ausgeschlossen.
Unter der Haube kombiniert Foresight laut der Meldung EmbeddingGemma 2 mit Gemma-4-Modellen. Daraus ergeben sich mehrere Funktionen, die sich weniger wie ein einzelnes Feature anfühlen, sondern wie ein lokaler Wissens- und Suchworkflow. So soll die App eigene kurze Notizen während eines Meetings live mit zusätzlichen Details anreichern, indem sie das laufende Gesprächstranskript nutzt. Daneben steht eine kontextuelle Wissenssuche im Vordergrund: Das Tool soll private Dokumente, Notizen, Transkripte und Bilder direkt auf dem Rechner über natürliche Spracheingaben durchsuchen. Im selben Moment kann auch eine Live-Hilfe reagieren, also Fragen beantworten, die während der Besprechung entstehen, und zwar aus der eigenen lokalen Wissensbasis heraus. Genau diese Kopplung von „aktuellem Gespräch“ und „privatem Unternehmenswissen“ ist in der Praxis oft der Engpass bei herkömmlichen Lösungen, weil sie eine nahtlose Zuordnung zwischen Datenquellen braucht.
Für den Markt ist dabei weniger die reine Existenz eines Embedding-Modells neu, sondern die Kombination aus Open-Weight-Ansatz, multimodaler Einbettung und Edge-freundlichen Speicherangaben. Entwickler können damit Prototypen schneller von der Cloud in Richtung Endgerät schieben, weil sie nicht zwingend mehrere teure oder schwer integrierbare Modellkomponenten orchestral zusammenführen müssen. Gleichzeitig bleibt das Thema Speicher und Laufzeit ein Wettbewerbsfaktor: 191 MB für den Textpfad ermöglichen frühe Erfahrungen auf vielen Systemen, während der Sprung auf etwa 567 MB RAM bei vollständiger multimodaler Nutzung die Hardwareanforderungen klarer macht. Für Unternehmen heißt das: Der Schritt zu datenschutzfreundlicher lokaler Verarbeitung lässt sich besser planen, wenn Pfade wie „nur Text“ oder „Text plus Medien“ als klare Stufen gedacht werden.
Auch die Entwickler-Story rund um das Ökosystem wirkt strategisch: Google verweist darauf, dass vorgefertigte Modell-Bundles auf Hugging Face verfügbar sein sollen. Parallel kündigt das Unternehmen an, die Schnittstellen in den kommenden Wochen tiefer in ML Kit für Android sowie MediaPipe Tasks integrieren zu wollen. Damit steigt die Chance, dass Embeddings aus diesem Ansatz nicht nur in spezialisierten Desktop-Setups landen, sondern als Baustein in mobile oder eingebettete Anwendungen fließen. Für Produktteams bedeutet das: Lokale Suche wird realistischer als Feature, das nicht erst später als „Privacy-Option“ nachgerüstet wird, sondern von Beginn an in Architektur und UX einfließen kann.
Unterm Strich verschiebt EmbeddingGemma 2 die praktische Schwelle für multimodale lokale KI. Wer bislang vor allem textbasierte Suche offline abbilden konnte, erhält nun eine Grundlage, um auch Bilder, Videoframes und Audio in denselben semantischen Raum zu bringen. Die macOS-App zeigt dabei als konkretes Beispiel, wie sich Meeting-Transkripte, Dokumente und Bilder zu einer nutzbaren Wissensoberfläche verdichten lassen – mit der Betonung auf Offline-Betrieb, niedrige Latenz und ohne zusätzliche Abogebühren. Wie gut sich das im Alltag gegen unterschiedliche Mikrofonqualitäten, Konferenz-Setups und Medienlängen durchsetzt, wird vor allem davon abhängen, wie robust Transkripte und die multimodale Einbettung in echten Nutzerflows arbeiten. Für die nächsten Wochen dürfte daher besonders spannend sein, wie schnell die Edge-Integration in mobile Pipelines tatsächlich verfügbar ist und welche Workloads Teams damit lokal abdecken können.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "EmbeddingGemma 2: Google bringt ein kompaktes Open-Weight-Modell für lokale KI-Suche" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "EmbeddingGemma 2: Google bringt ein kompaktes Open-Weight-Modell für lokale KI-Suche" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »EmbeddingGemma 2: Google bringt ein kompaktes Open-Weight-Modell für lokale KI-Suche« bei Google Deutschland suchen, bei Bing oder Google News!