
LONDON (IT BOLTWISE) – Microsoft ordnet den Ausfall von Outlook und Teams als technisches Problem ein. Demnach lag es zunächst an einer fehlerhaft vorgenommenen Kapazitätserweiterung, die später nach einer Netzwerkänderung auffällig wurde. Der Konzern hat die Dienste inzwischen schrittweise wiederhergestellt und dabei jede Phase auf Stabilität geprüft. Eine detaillierte Fehleranalyse soll nach Abschluss der internen Überprüfung folgen.
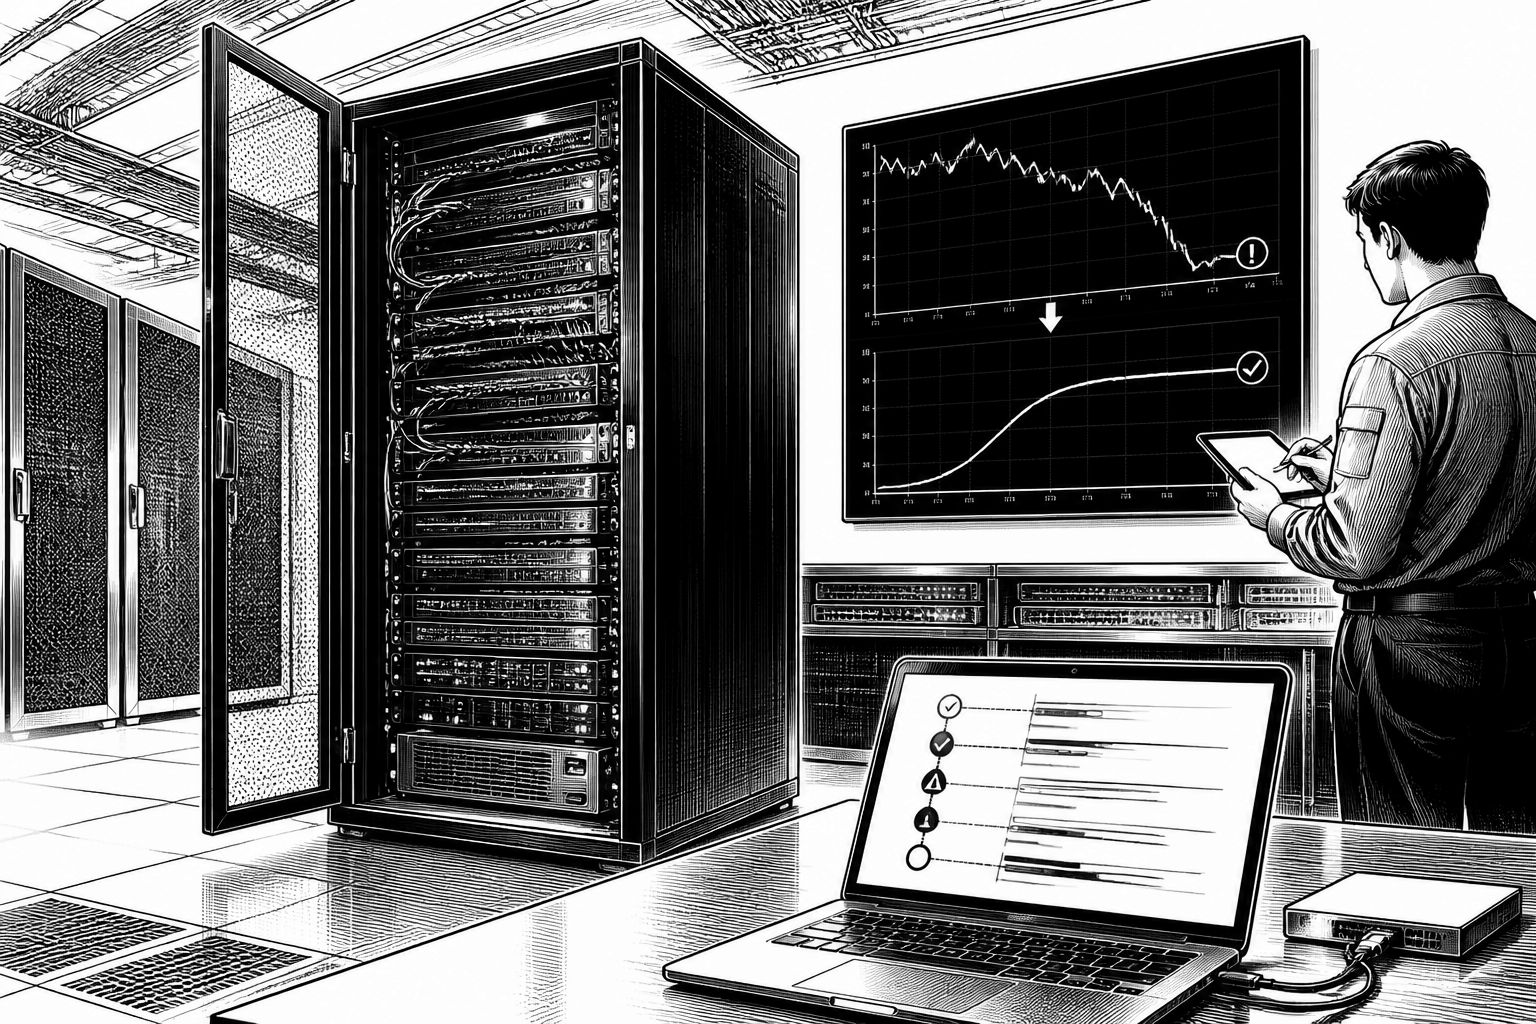
Der weltweite Ausfall von Microsoft-Diensten wie Outlook und Teams hat im November 2026 vor allem eines gezeigt: Selbst in hochautomatisierten Cloud-Ökosystemen können vermeintlich kleine Änderungen an Kapazitäten oder Netzpfaden die Gesamtstabilität spürbar aus dem Takt bringen. Microsoft erklärte den stundenlangen Vorfall zunächst ohne Hinweise auf Cyberangriffe. Stattdessen verwies der Konzern auf eine fehlerhaft vorgenommene Kapazitätserweiterung, die offenbar erst in Kombination mit späteren Netzwerkänderungen sichtbar wurde. Für Unternehmen ist das mehr als ein kurzfristiges Ärgernis, denn E-Mail und Kollaboration sind in vielen Organisationen eng in Prozesse, Compliance-Workflows und Ticketing-Frontends eingebettet.
Technisch betrachtet beschreibt Microsoft eine Abfolge, die in Betriebsteams häufiger vorkommt, als man nach außen wahrnimmt: Kapazitäten werden erweitert, um Lastspitzen oder Wachstum aufzufangen; parallel ändern sich Netzwerkparameter, Routingregeln oder Topologie-Annahmen. Laut Microsoft trat das Problem „erst nach einer kürzlich vorgenommenen Netzwerkänderung“ auf. Diese zeitliche Klammer ist wichtig, weil sie die Ursache weniger als „ein kaputtes System“ und mehr als „ungünstige Wechselwirkung“ zwischen zwei Anpassungen erscheinen lässt. Gerade in verteilten Systemen können neue Routen beispielsweise zu anderen Pfaden für Datenströme führen, wodurch Ressourcen anders ausgelastet werden als ursprünglich angenommen.
Der konkrete Rahmen des Vorfalls: Der Ausfall begann am Abend des 12. November 2026 und zog sich bis in den nächsten Tag hinein. Weltweit konnten Firmen zeitweise nicht auf ihre E-Mails zugreifen; die Microsoft-365-Dienste funktionierten laut den Angaben nur eingeschränkt, wobei insbesondere Teams nicht durchgängig zuverlässig lief. In solchen Szenarien wird schnell deutlich, warum eine „Korrektur“ nicht einfach nur bedeutet, einen Dienst neu zu starten. Abhängig von der Architektur können Abhängigkeiten zwischen Mail-Backend, Authentifizierung, Verzeichnisdiensten und Kollaborationskomponenten dafür sorgen, dass Wiederherstellungsschritte erst nach einer Stabilisierungskontrolle wirklich greifen.
Microsoft berichtet zudem, dass das zugrundeliegende Problem inzwischen behoben sei und der Dienst für die verbleibenden Kunden und Regionen wiederhergestellt werde. Der Konzern fuhr die Dienste angesichts hoher Serverbelastung schrittweise hoch und überprüfte dabei in jeder Phase die Stabilität. Diese Vorgehensweise ist operativ ein Standard, aber sie wird hier besonders relevant, weil die Last während eines Vorfalls selten „normal“ ist: Nutzer wechseln Workarounds, Wiederanfragen stauen sich, und Monitoring-Teams müssen gleichzeitig Risiko und Nutzen gegeneinander abwägen. Dass Microsoft die Wiederherstellung bewusst phasenweise steuern wollte („Stabilität überprüft“), spricht dafür, dass nicht jede Wiederherstellung sofort in einen echten End-to-End-Betrieb überging, sondern zunächst Grenzbereiche getestet wurden.
Interessant ist auch der kommunikative Teil der Meldung: Der Konzern stellte ausdrücklich klar, dass es sich um ein technisches Problem handle, das weder mit Cyberangriffen noch mit KI oder Agenten in Zusammenhang stehe. Damit versucht Microsoft, mehrere Spekulationsrichtungen abzuschneiden, die bei größeren Plattformstörungen typischerweise schnell aufkommen. Aus Sicht der KI-Entwicklung ist das besonders relevant, weil viele Organisationen inzwischen KI-gestützte Assistenzfunktionen, automatisierte Posteingangsverarbeitung oder produktivitätsnahe Features an Microsoft-365 ankoppeln. Auch wenn der Ausfall laut Microsoft nicht KI-ursächlich war, zeigt die Erfahrung, wie stark die Wahrnehmung im Markt von „intelligenter Automatisierung“ auf die Betriebsstabilität projiziert wird.
Für Betreiber und IT-Entscheider außerhalb von Microsoft liefert der Vorfall mehrere praktische Lehren. Erstens macht die beschriebene Kausalität deutlich, wie kritisch kontrollierte Change-Prozesse sind, wenn Kapazitätserweiterungen und Netzwerkänderungen zeitlich überlappen. Zweitens zeigt der Ablauf, dass „Wiederherstellung“ bei globalen Diensten häufig eine Sequenz aus teilweiser Aktivierung, Verkehrslenkung und Stabilitätschecks ist, nicht ein einzelner Schalter. Drittens unterstreicht das Ereignis, wie wichtig Redundanz auf Anwendungsebene ist: Wo Unternehmen Workflows, die auf E-Mail und Team-Kommunikation angewiesen sind, nicht flexibel umplanen können, werden Ausfälle unmittelbar zum Produktivitäts- und Risikothema.
Der nächste Schritt ist laut Microsoft eine ausführliche Fehleranalyse nach Abschluss der internen Überprüfung. Für die Bewertung des Vorfalls wird entscheidend sein, ob Microsoft nur den unmittelbaren technischen Trigger beschreibt oder auch Hinweise zur Architektur liefert, etwa welche Kapazitätsannahmen verletzt wurden und warum die Netzwerkänderung genau in diesem Moment die Kette in Gang setzte. Unabhängig davon dürfte die Meldung bereits jetzt als Signal in vielen Betriebs- und SRE-Teams ankommen: Änderungen an Kapazität und Netzwerktopologie müssen nicht nur jeweils „für sich“ getestet werden, sondern auch hinsichtlich ihrer Wechselwirkungen über Time-to-Detect- und Time-to-Restore-Zeiträume hinweg. Genau diese Lücke entscheidet im Ernstfall darüber, ob eine Störung kontrolliert bleibt oder sich in Minuten in eine globale Unterbrechung verwandelt.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Microsoft-Outlook- und Teams-Ausfall: Kapazitätserweiterung als Ursache" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Microsoft-Outlook- und Teams-Ausfall: Kapazitätserweiterung als Ursache" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Microsoft-Outlook- und Teams-Ausfall: Kapazitätserweiterung als Ursache« bei Google Deutschland suchen, bei Bing oder Google News!