




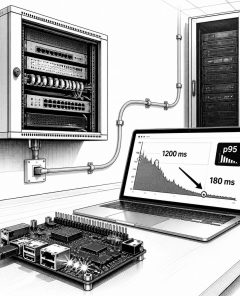
Lokale KI-Systeme: 6,7-fache Geschwindigkeit durch p95-Latenz-Optimierung
LONDON (IT BOLTWISE) – Lokale KI-Verarbeitung per Endgerät oder im lokalen Netzwerk bringt messbar niedrigere Latenzen: lokale RAG-Pipelines erreichen laut den vorliegenden Benchmarks p95-Werte von 180 Millisekunden. Cloud-basierte Alternativen liegen im Schnitt bei 1200 Millisekunden und damit deutlich langsamer. Das spiegelt sich in konkreten Use Cases wie KI-gestützter Layout-Erstellung in Sekunden statt Minuten wider. Gleichzeitig […]
 #Sophos
 #AmazonPrime
 #Bestseller

