


LONDON (IT BOLTWISE) – PrismML zeigt mit „Bonsai 2 27B“ einen neuen Kompressionsansatz für Reasoning-KI: Das Modell schrumpft von rund 27 Milliarden Parametern auf eine Speichergröße von nur 5,9 GB. Damit soll es auf PCs und potenziell auch auf High-End-Smartphones laufen. Gleichzeitig behauptet das Startup, nur etwa 2% Leistung gegenüber dem Ausgangsmodell zu verlieren und so in Benchmarks bei 98% zu landen. Der Fokus verschiebt sich damit spürbar von Cloud-Setups hin zu KI, die lokal, schneller verfügbar und privater nutzbar sein soll.
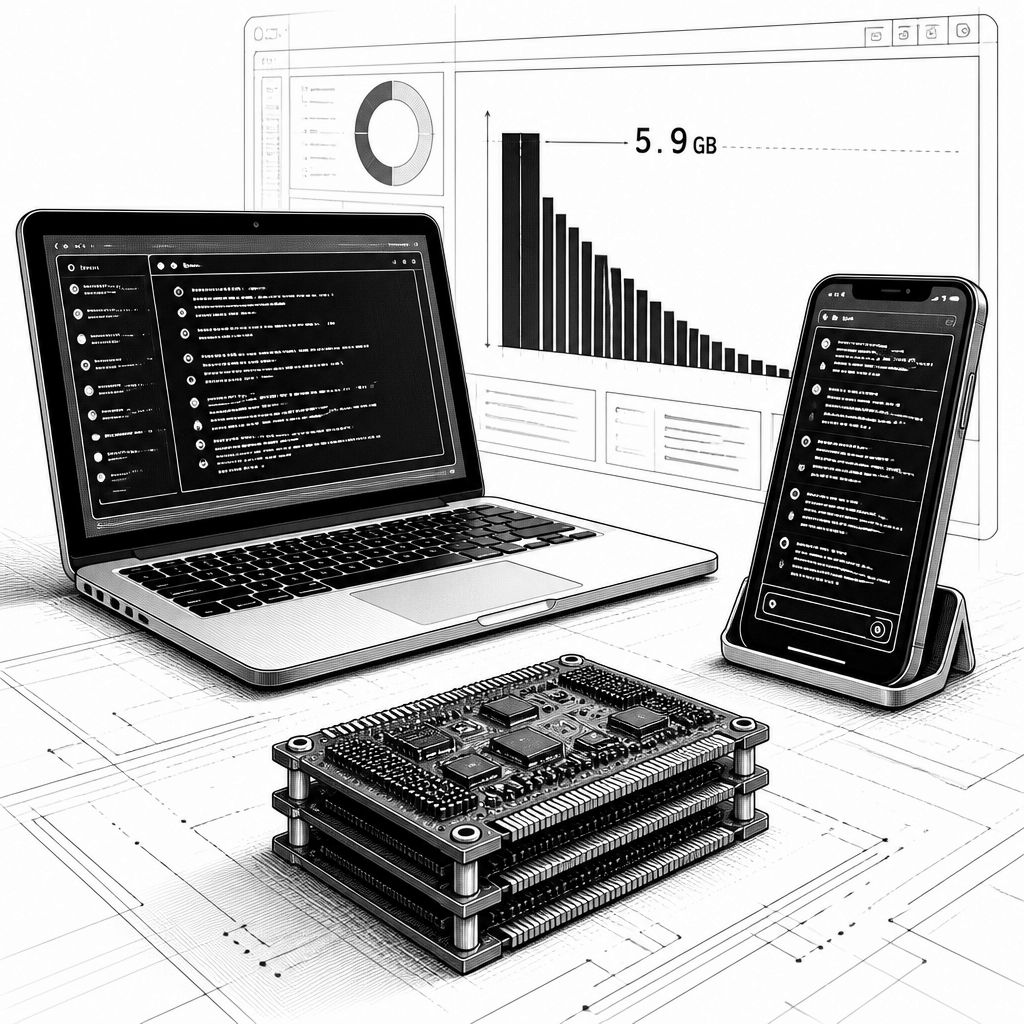
Die Debatte um Künstliche Intelligenz wird gerade an einer Stelle neu sortiert: nicht über noch größere Modelle, sondern über deren „Bepackung“. PrismML, ein Startup aus der akademisch geprägten Kompressionsszene, stellt mit „Bonsai 2 27B“ ein Modell vor, das bewusst so klein gehalten ist, dass es ohne Cloud-Server-Routine auf normalen Endgeräten Platz findet. Der technische Kern ist dabei bemerkenswert schlicht: Reasoning-Modelle müssen nach Ansicht des Teams nicht zwangsläufig riesig sein, wenn man sie beim Speichern ihrer gelernten Parameter clever komprimiert. In der Praxis bedeutet das, dass die Hürde von GPU-Memory und teuren Infrastrukturbetrieben sinkt, obwohl die Modelle weiterhin als „Reasoning“-LLM-Familie positioniert werden.
Konkreter wird es beim Vergleich zur Referenz: „Bonsai 2 27B“ soll ein 27B-Modell komprimieren, das auf Qwen3.8 27B basiert. Laut den Angaben des Unternehmens reduziert sich der Speicherbedarf auf 5,9 GB. Das ist ein Faktor von etwa 9x bis 10x weniger Speicher gegenüber dem Ausgangsmodell und damit ein entscheidender Schritt, weil viele produktive Setups weniger an Rechenleistung als an der Daten- und Gewichtsübertragung scheitern. Für Entwickler verändert das die Architektur: Wer vorher mehrere spezialisierte Dienste oder Offloading-Pipelines brauchte, kann unter Umständen Inferenz direkt in Anwendungen einbetten. Für den Endanwender ist der Unterschied ebenfalls spürbar, denn lokale Modelle versprechen kürzere Interaktionspfade und weniger Abhängigkeit von netzwerklastigen Latenzpfaden.
Der eigentliche Streitpunkt bei jeder Kompression ist jedoch die „Qualitätsschere“ zwischen schlankem Modell und Original. PrismML behauptet, dass der Leistungsabfall in Benchmarks so gering ausfällt, dass „Bonsai 2“ 98% der aggregierten Benchmark-Scores des Ausgangsmodells erreicht. Das ist nicht nur ein einzelner Wert: Schon die erste „Bonsai“-Generation, die wenige Monate zuvor im März veröffentlicht wurde, habe demnach 95% erreicht. Zusätzlich nennt das Startup Downloadzahlen, die den Momentum-Effekt illustrieren sollen: Die erste, noch größere bzw. weniger stark komprimierte Variante wurde über 11 Millionen Mal heruntergeladen, die weiteren, noch kleineren Modelle zusätzlich etwa 2,6 Millionen Mal. Damit wird die Kompression nicht nur als Forschungsidee präsentiert, sondern als Technologie, die sich für die Community messbar „in Reichweite“ bewegt.
Technisch landet PrismML bei einem Ansatz, der aus Sicht der Modellarchitektur weniger am „wie“ der Berechnung, sondern mehr am „womit“ der Parameterhaltung ansetzt. Das Unternehmen nennt „ternary weights“: Statt Gewichten, die typischerweise 16 Bit pro Gewicht benötigen, werden die Werte auf drei Zustände vereinfacht – +1, -1 oder 0. Dadurch lässt sich pro Gewicht deutlich weniger Information speichern; das reduziert den Footprint massiv und macht das Modell transport- und ladbar für Geräte mit begrenztem RAM. Genau hier liegt die historische Logik: Quantisierung und Kompression verfolgen seit Jahren das Ziel, die Inferenzkosten zu senken, aber jede zusätzliche Ersetzung von Genauigkeit stößt früher oder später an Grenzen, etwa wenn feine Signalunterschiede in den Gewichten für Tasks wichtig werden. PrismML argumentiert, dass bei „Bonsai 2“ diese Grenzen im aktuellen Entwicklungsstand weit genug nach hinten verschoben wurden, ohne die Modellintelligenz spürbar zu beschädigen.
Ein realistischer Blick bleibt trotzdem notwendig. Der CEO Babak Hassibi weist darauf hin, dass Kompression zwar vermutlich immer einen Einfluss auf die Modellgüte haben werde, vollständige Parität bei 100% daher möglicherweise dauerhaft unerreichbar bleibt. In diesem Zusammenhang ist auch ein methodischer Punkt relevant: Benchmarks sind nur eine Annäherung, während reale Anwendungen häufig durch zusätzliche Software-Schichten geprägt werden, etwa durch das „Harness“, also das Laufzeitsystem, in dem das Modell arbeitet. Wenn ein Model-Setup sauber optimiert ist, kann ein 2%-Abfall in einem Test-Suite-Summenwert im Alltag geringer wirken; umgekehrt kann schon ein kleiner Bewertungsunterschied in bestimmten Text- oder Tool-Use-Szenarien groß erscheinen. Für Unternehmen heißt das: Sie sollten Kompression nicht allein über Aggregat-Scores einkaufen, sondern kontrolliert die eigenen Workloads testen.
Für den Markt ist der Ansatz gleich aus mehreren Richtungen interessant. Erstens verschiebt sich der Use-Case von reiner Cloud-Nutzung hin zu „Edge“- und On-Device-Inferenz: Stoica hebt als Motivation hervor, dass fortgeschrittene Modelle dadurch direkt auf den Nutzergeräten verfügbar werden könnten, ohne dass Daten in die Cloud wandern müssen. Das adressiert zwei praktische Engpässe gleichzeitig: Datenschutzanforderungen und Betriebskosten, die bei Cloud-Laufzeiten und Datenübertragung schnell steigen können. Zweitens konkurriert PrismML nicht im luftleeren Raum; auch andere Teams arbeiten an LLM-Kompression. Genannt wird etwa Multiverse Computing als weiteres Unternehmen in diesem Feld, das sich ebenfalls auf Effizienzgewinne konzentriert. Gerade weil es mehrere Player gibt, wird die Differenzierung über Messwerte wie Speichergröße, erreichbare Parität und den tatsächlichen „Throughput“ auf typischen Zielgeräten erfolgen.
PrismML skizziert zudem eine klare Roadmap: Als nächstes Ziel will man die gleiche Kompressionstechnik auf deutlich größere Modelle übertragen, mit einer erwarteten Größenordnung „several-hundred-billion-parameter“. Hassibi stellt dabei in Aussicht, dass es mit wachsendem Modellumfang künftig einfacher werden könnte, die Leistung bei Kompression näher an 100% heranzuführen, weil es mehr „Raum“ für verlustfreie bzw. verlustarme Reduktion gebe. Wenn diese Annahme stimmt, hätten solche Modelle zwei strategische Konsequenzen: Sie könnten Plattformen entlasten, die heute durch Modellgröße wachsen statt durch Tooling zu skalieren, und sie könnten gleichzeitig neue Produktkategorien ermöglichen, etwa privat laufende Assistenzfunktionen in Endnutzer-Apps. Unterm Strich ist PrismMLs Botschaft damit weniger „klein statt intelligent“, sondern „intelligent, weil passend komprimiert“ – und genau diese Verschiebung dürfte in der KI-Infrastruktur für Bewegung sorgen.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "PrismMLs Bonsai 2: winziges KI-Modell mit 98% Benchmark-Parität" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "PrismMLs Bonsai 2: winziges KI-Modell mit 98% Benchmark-Parität" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »PrismMLs Bonsai 2: winziges KI-Modell mit 98% Benchmark-Parität« bei Google Deutschland suchen, bei Bing oder Google News!