


LONDON (IT BOLTWISE) – Eine Studie der New York University zeigt, dass moderne Bilderkennungs-KI bei einfachen Silhouetten häufiger aus dem Tritt gerät als Menschen. Das Team um Biyu He testete 240 Abbildungen aus 48 Alltagskategorien gegen über 200 tiefe neuronale Netze. In den Versuchen bevorzugten die KI-Modelle lokale Details und Muster statt der Gesamtform. Das kann besonders in Robotik, autonomem Fahren und Assistenzsystemen relevant werden, wenn Sichtbedingungen unvollständig sind.
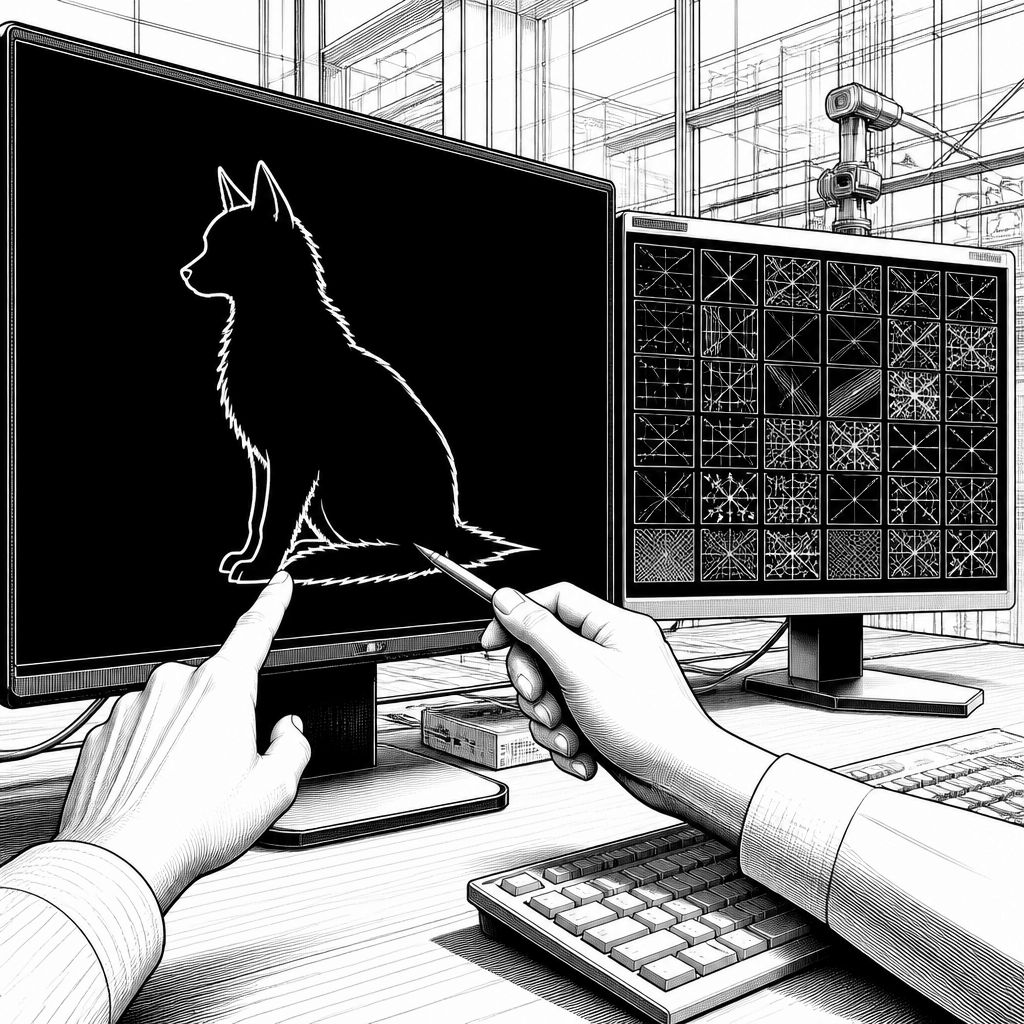
Wie gut eine KI „sieht“, zeigt sich selten in idealen Laborbildern, sondern dort, wo die Daten unvollständig sind: Nebel, schlechte Beleuchtung, teilweise verdeckte Objekte oder stark reduzierte Darstellungen. Genau an dieser Stelle setzt die aktuelle Untersuchung an, die am Beispiel von Form- und Silhouetten-Erkennung eine harte Grenze moderner Bilderkennungsmodelle sichtbar macht. Laut dem Forschungsteam um Biyu He bleiben Algorithmen beim Erfassen übergeordneter Strukturen deutlich hinter menschlichen Betrachtern zurück, selbst wenn sie mit sehr großen Foto-Korpora trainiert wurden.
Im Kern vergleicht die Studie die Sehleistung von Testpersonen mit der Klassifikationserfahrung von mehr als 200 tiefen neuronalen Netzen unterschiedlicher Bauart und Trainingsstrategie. Für den Belastungstest veränderte das Team insgesamt 240 Abbildungen aus 48 Alltagskategorien systematisch, etwa indem es reine schwarze Silhouetten ohne Innenstruktur erzeugte oder einzelne Muster wie Felltexturen zeigte, ohne dass eine klare Kontur im Bild blieb. Zusätzlich wurden Szenen so manipuliert, dass sich viele kleine Objekte bildfüllend aneinanderreihen und dadurch der typische Umriss nahezu zerstört wird. In dieser Versuchslogik liegt die Botschaft: Nicht jede KI scheitert grundsätzlich an Bildern, aber sie bricht, sobald die Information, die Menschen intuitiv als Gesamtgestalt verarbeiten, für das Modell weniger „einfach erkennbar“ wird.
Die Unterschiede lassen sich auch technisch interpretieren: Während Menschen die Gesamtform priorisieren, konzentrieren sich die getesteten Modelle in solchen Settings stärker auf lokale Details, Oberflächenmuster und Texturen. Schon geringe Bildverzerrungen oder das Fehlen typischer Merkmale führten dazu, dass die Systeme die Motive nicht mehr korrekt zuordnen konnten. Besonders deutlich wird das bei Szenarien, in denen die Identifikation allein über die Erfassung der Gesamtsilhouette laufen muss: Dann lagen die Algorithmen durchweg hinter den menschlichen Probanden, und zwar über alle Versuchsbedingungen hinweg, für die kein einziges der über 200 Modelle das menschliche Erkennungsmuster konsistent nachbilden konnte.
Ein Folgeexperiment trennte die Information „Gesamtform“ weiter von „lokalen Details“: Die Umrisse von Gegenständen und Tieren wurden dazu mit vielen kleinen Kreuzchen gefüllt. Menschen konnten die Motive weiterhin anhand der äußeren Kontur benennen – eine Katze oder ein Schmetterling blieb erkennbar. Viele KI-Modelle dagegen übersetzten die dominante Kreuzstruktur in falsche Kategorien und ordneten die Silhouetten etwa Begriffen wie „Kreuzworträtsel“, „Fenstergitter“, „Kettenhemd“ oder „Fadenwurm“ zu. In dieser Konstellation wird die Schwäche besonders greifbar: Wenn das Modell die „falschen“ Bildsignale als entscheidend gewichtet, verschwimmt die Bedeutung der Gesamtgestalt – und Fehlklassifikationen werden plausibel, obwohl die Forminformation eigentlich da ist.
Auch die Diskussion um „menschenähnliche“ KI bekommt hier eine nuance: Das Team um Biyu He betont, dass heutige Bilderkennungsmodelle nicht so menschenähnlich sind, wie es in der Praxis manchmal angenommen wird. Die Studie zeigt zwar, dass Systeme, die zugleich mit Bildern und begleitenden Texten trainiert werden, in der Summe menschenähnlichere Trefferquoten erreichen können als klassische Netze. Sobald jedoch die Gesamtgestalt gestört oder isoliert bewertet wird, verlieren diese multimodalen Modelle ihren Vorteil. Damit wird ein wichtiger Punkt der KI-Forschung berührt: Selbst leistungsfähige neuronale Netze können fundamentale Unterschiede zur menschlichen Wahrnehmung aufweisen – insbesondere bei der Verarbeitung von Formen und Silhouetten.
Für reale Produkte ist diese Erkenntnis nicht akademisch, sondern konkret: Das Team sieht eine Konsequenz für den Einsatz von KI in Robotik, autonomem Fahren sowie in Sehprothesen und Gehirn-Computer-Schnittstellen für sehbehinderte Menschen. Gerade in Nebel- oder Dämmerungssituationen müssen technische Systeme verlässliche Urteile treffen, obwohl die Bilddaten unvollständig oder verzerrt sind. Menschen greifen dort instinktiv häufig auf die grobe Silhouette zurück; die Studie liefert Hinweise, wie Algorithmen künftig trainiert werden müssten, um ein ganzheitlicheres, robusteres Sehvermögen aufzubauen. Für Unternehmen bedeutet das zugleich: Gute Ergebnisse auf Standard-Datensätzen reichen als Sicherheitsargument nicht aus, wenn die kritischen Testbedingungen im Feld eher „formarm“ sind als detailreich.
Ein nächster Schritt liegt damit weniger in „mehr Daten“ als in „anders geformten Trainingsreizen“. Die Forschenden weisen darauf hin, dass der Trainingsprozess gezielt neu gedacht werden muss: Modelle sollten konfrontativ mit veränderten Silhouetten, Schattenrissen und reduzierten Darstellungen lernen, statt vor allem an detailreichen, texturbetonten Bildern zu optimieren. Für Entwickler verschiebt sich damit der Fokus von reiner Skalierung auf Robustheit gegen Bildstörungen. Für Nutzerinnen und Nutzer ist die Studie ein Signal, KI-Bildanalyse trotz beeindruckender Fortschritte weiter kritisch zu bewerten – insbesondere dort, wo Fehlentscheidungen teuer werden könnten.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Studie zeigt: Bilderkennungs-KI scheitert oft an Silhouetten – und lernt anders als Menschen" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Studie zeigt: Bilderkennungs-KI scheitert oft an Silhouetten – und lernt anders als Menschen" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Studie zeigt: Bilderkennungs-KI scheitert oft an Silhouetten – und lernt anders als Menschen« bei Google Deutschland suchen, bei Bing oder Google News!