


LONDON (IT BOLTWISE) – Musubi stellt mit PolicyLM-1.7B ein leichtgewichtiges Entscheidungmodell für Content-Moderation vor. Es soll Richtlinien in Klartextform auf Nachrichten anwenden und dabei laut Ankündigung unter 50 Millisekunden pro Anfrage bleiben. Das Modell wird mit offenen Gewichten veröffentlicht und soll bei Richtlinienänderungen ohne neues Training auskommen. Damit zielt der Ansatz auf eine skalierbare, von Produktteams steuerbare Proaktiv-Moderation ab.
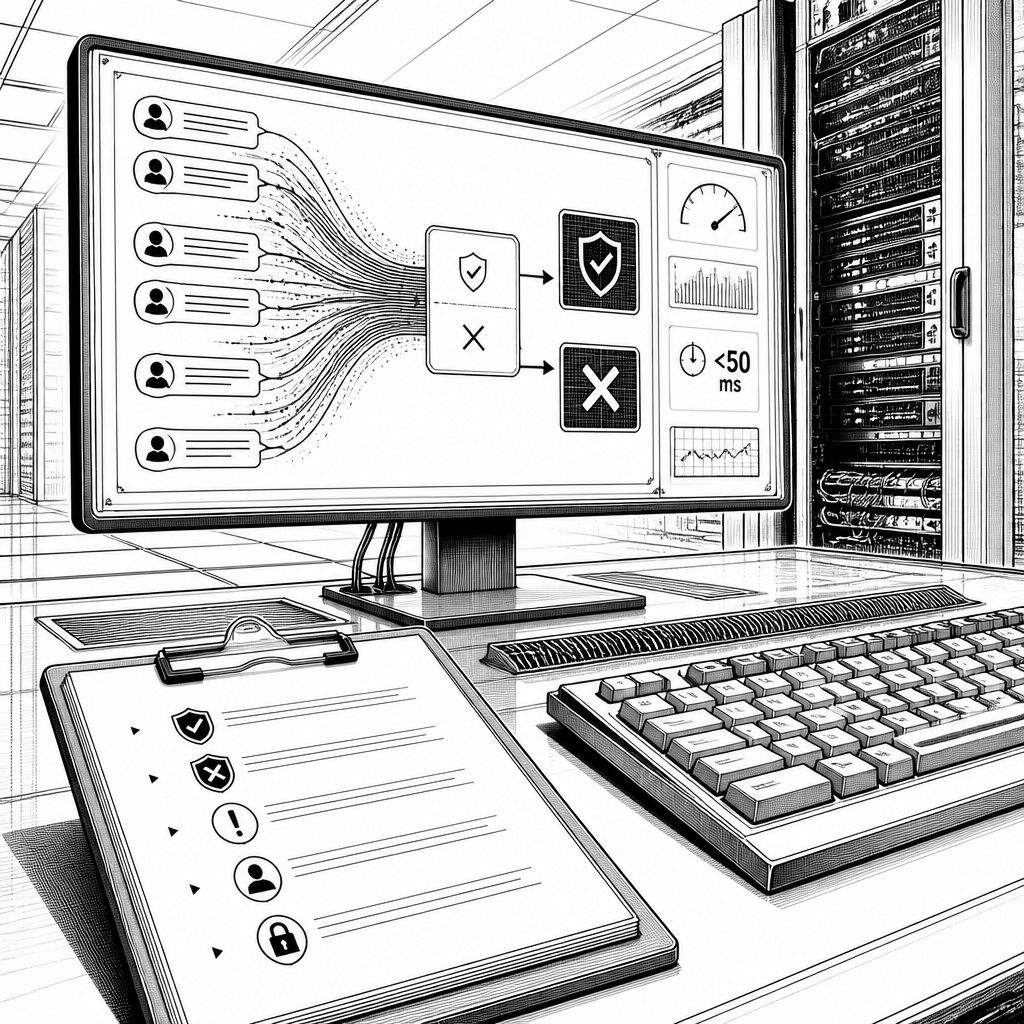
Content-Moderation wird aktuell weniger durch einzelne “Regeln” als durch die Frage bestimmt, wie schnell und flexibel sich Richtlinien in technische Entscheidungen übersetzen lassen. Genau an dieser Schnittstelle setzt Musubi mit PolicyLM-1.7B an: Das Unternehmen positioniert das neue Modell als Decision Model, das nicht Text generiert, sondern eine binäre Entscheidung trifft, also ob ein Beitrag in eine vorgegebene Kategorie fällt oder nicht. Entscheidend ist dabei die Ausrichtung auf Echtzeit, denn laut Ankündigung soll die Policy-Anwendung auf eine Nachricht in weniger als 50 Millisekunden erfolgen. Für Plattformen bedeutet das weniger Interpretationsspielraum am Rand der Moderationslogik und mehr Durchsatz bei gleichzeitiger Prozessierbarkeit in automatisierten Pipelines.
Technisch betrachtet folgt der Ansatz dem Grundprinzip von Entscheidungmodellen: Durch die Beschränkung der Modellausgabe auf vorbestimmte Optionen lassen sich Latenz und Rechenkosten typischerweise reduzieren, weil das System nicht erst natürliche Sprache “ausführen” muss. Musubi argumentiert, dass PolicyLM-1.7B zwar kostenseitig und geschwindigkeitsmäßig in der Nähe der KI-Klassifikatoren bleiben soll, die auf den meisten Plattformen bereits für Moderationsentscheidungen im Einsatz sind, aber dennoch die Flexibilität einer modernen Transformer-Architektur mitbringt. Diese Kombination ist für Produktteams relevant, weil Richtlinien oft komplex sind (z. B. mehrstufige Kriterien oder Ausnahmen), die man mit rein starren Regeln oder sehr engen Klassifikatoren nur schwer abbildet.
Der Kernvorteil wird in der Art beschrieben, wie Richtlinien in das System gelangen: PolicyLM-1.7B soll eine Content-Policy verarbeiten, die in “plain English” formuliert ist, und sie dann auf Nachrichten anwenden. Noch wichtiger: Bei Änderungen der Policy soll kein zusätzliches Training nötig sein. In der Praxis heißt das, dass Moderationsverantwortliche die Regeln iterativ anpassen können, ohne jedes Mal eine komplette Modellneuberechnung planen zu müssen. Gerade bei Plattformen, die auf neue Missbrauchsmuster reagieren, ist das ein substanzieller Unterschied gegenüber Ansätzen, bei denen jede inhaltliche Änderung eine aufwendige Datenerhebung, Labeling-Runden und Re-Training nach sich zieht.
Die Positionierung erfolgt auch vor dem Hintergrund einer breiteren “Decision-Model”-Welle: In der Quelle wird der Trend seit der Veröffentlichung von Typesafe AI’s Jev im September beschrieben und unmittelbar danach mit weiteren konkurrierenden Entscheidungssystemen von OpenAI und Amazon verknüpft. Der Vergleich liegt nahe, weil Jev-ähnliche Modelle ebenfalls nicht auf Textausgabe setzen, sondern Wahrscheinlichkeiten oder Klassifikationen liefern. Musubi will diese Aufmerksamkeit jedoch für den Moderationsbereich “umlenken” und betont, dass PolicyLM-1.7B gezielt für Content-Moderation trainiert wurde und als Open-Weights-Modell so laufen kann, dass sich Plattformbetreiber nicht zwingend auf einen reinen Closed-API-Betrieb verlassen müssen. Damit rückt auch die Frage der Portabilität in den Fokus: Wer das Modell selbst hostet, kann Moderationsentscheidungen eher in bestehende Governance- und Betriebsprozesse integrieren.
Im Gespräch wird außerdem deutlich gemacht, dass Musubis Interesse an Entscheidungmodellen nicht erst mit dem aktuellen Hype entstanden sein soll. Als früheres Projekt nennt das Unternehmen ein 2024er Vorhaben namens GLiNER (Generalist Model for Named Entity Recognition), das bereits viele der genannten Techniken eingesetzt habe. Diese Einordnung ist relevant, weil sie erklärt, warum PolicyLM-1.7B nicht als “rein zufällige” Moderationsspielerei wirkt, sondern als Ableitung eines technisch verwandten Modell-Setups. Für Entscheider in Produkt und Engineering zählt dabei vor allem, dass das Modell laut Darstellung human policy-setters als Iterationsinstanz stärken will: Richtlinienänderungen sollen vor allem ein Prozess für das Policy-Team sein – weniger ein Modell-Mini-Projekt für Datenpipeline, Training und Deployment.
Ein weiterer Anwendungsanker kommt aus der Logik, die in der Quelle ausdrücklich genannt wird: Decision Models werden als geeignet beschrieben, um Fehlverhalten von KI-Agenten zu begrenzen, also Aufgaben- oder Handlungsrahmen durch binäre Einschätzungen zu “kappen”. Übertragen auf menschliches Verhalten liegt der Gedanke nahe, weil Moderation im Kern ebenfalls entscheidet, ob ein Inhalt in einen verbotenen bzw. zulässigen Bereich fällt. Praktisch bedeutet das: Wenn Agenten künftig stärker mit User-Interaktionen und automatisierten Workflows verknüpft werden, kann die gleiche Entscheidungsschicht als gemeinsames Sicherheits- und Qualitätsraster dienen – etwa, um riskante Aktionen früh zu blockieren oder die weitere Bearbeitung an eine strengere Prüfung weiterzugeben.
Für die Branche ist dabei weniger die einzelne Modellnummer entscheidend als das Betriebsversprechen: Open Weights, niedrige Latenz und Policy-Aktualisierung ohne neues Training adressieren genau die drei Engpässe, die Moderationssysteme in der Realität oft treffen – Kosten, Antwortzeit und organisatorische Geschwindigkeit. Ob PolicyLM-1.7B diese Ziele in unterschiedlichen Sprachräumen und Kategorien gleichermaßen erreicht, hängt selbstverständlich von Evaluationen im jeweiligen Produktionskontext ab. Trotzdem verschiebt der Ansatz den Erwartungsrahmen: Statt Moderation als “statische Modellentscheidung” zu behandeln, rückt sie als dynamisch steuerbare Entscheidungsschicht in den Mittelpunkt, die eng mit Produkt- und Policy-Zyklen zusammenarbeitet.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "PolicyLM-1,7B: Entscheidungsmodule für KI-Moderation in Echtzeit" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "PolicyLM-1,7B: Entscheidungsmodule für KI-Moderation in Echtzeit" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »PolicyLM-1,7B: Entscheidungsmodule für KI-Moderation in Echtzeit« bei Google Deutschland suchen, bei Bing oder Google News!