
SAN FRANCISCO / LONDON (IT BOLTWISE) – Nvidia nennt die NPU in der RTX Spark öffentlich nur in Andeutungen. Eine technische Analyse zeigt, dass die Einheit als eigenständiger DLA-/NPU-Baustein mit eigener Clock- und Power-Domäne arbeitet. In Tests lädt das System echte neuronale Netze auf die NPU, während die GPU im Leerlauf bleibt. Gleichzeitig bleibt die Effizienz hinter Erwartungen zurück, weil INT8 zwar nutzbar ist, aber im aktuellen Softwarepfad kaum schneller läuft.
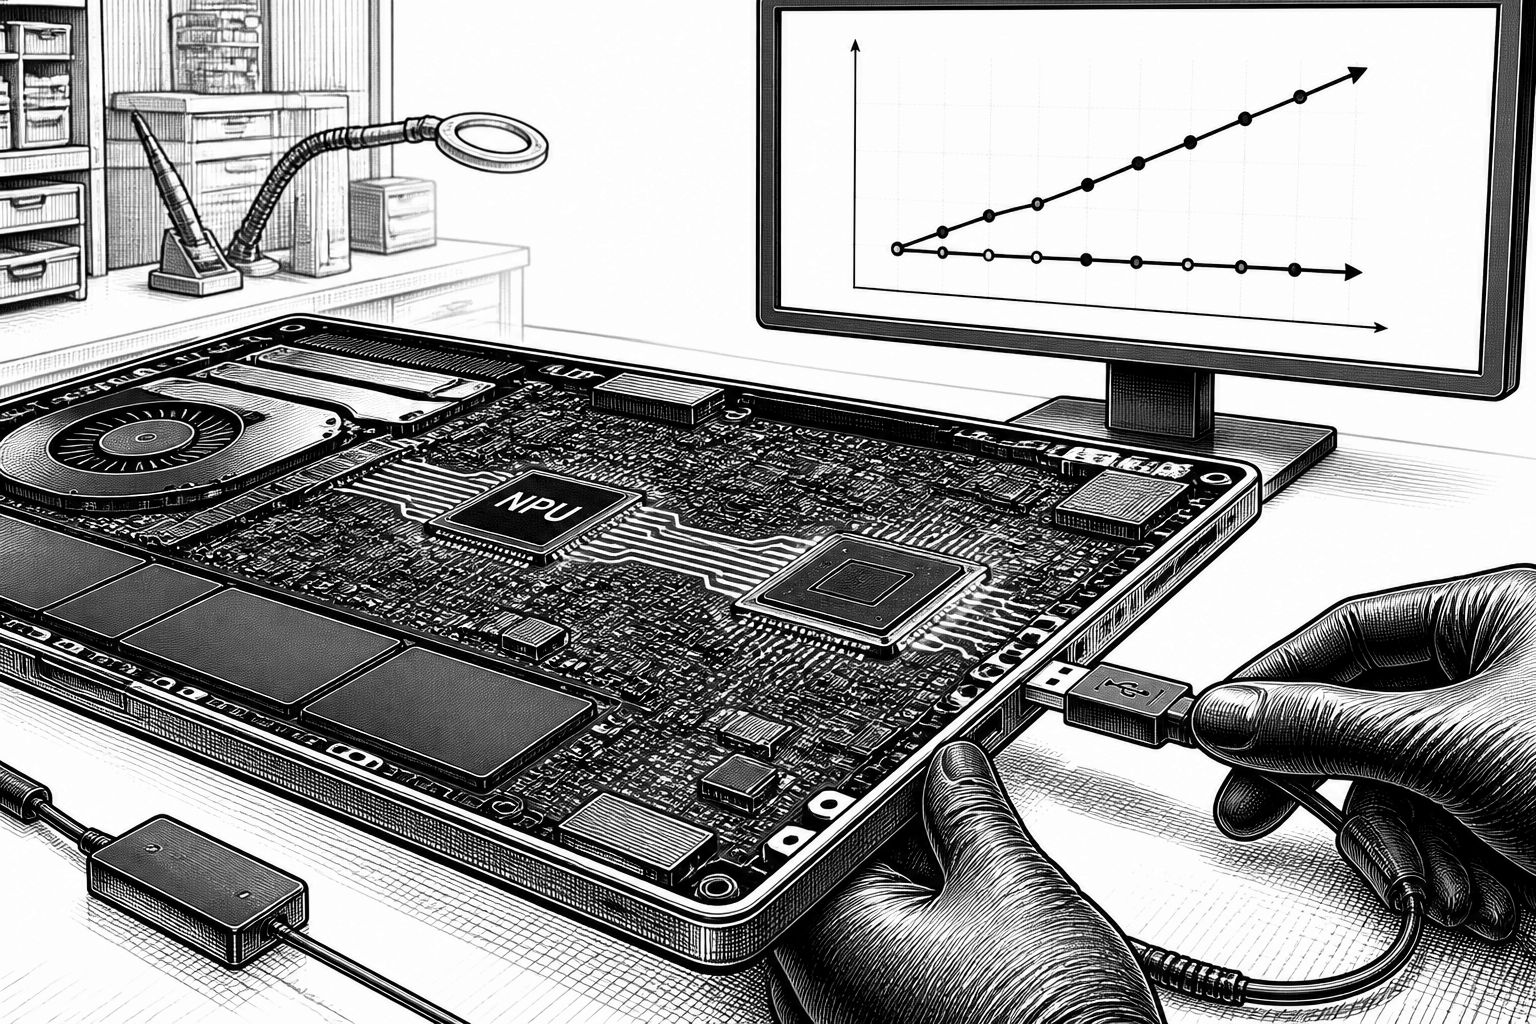
Die RTX Spark ist für viele zuerst ein Name im Kontext von Copilot+ PCs – doch die spannendste Frage lautet, was im Inneren tatsächlich beschleunigt wird. Während die GPU-Identifikation in Windows relativ klar bleibt, behandelt das Betriebssystem die NPU wie einen separaten Adapter und kapselt sie zugleich stärker als klassische Grafikpfade. Genau dieses Zusammenspiel aus Hardware-Sichtbarkeit, Firmware-„Hiding“ und Windows-Treibern hat in den letzten Wochen für Verwirrung gesorgt, weil Nvidia die NPU im offiziellen Material nur sehr reduziert beschreibt. In einer praxisnahen Untersuchung wird deutlich: Das NPU-Design wirkt weniger wie ein generischer NPU-Ersatz, sondern eher wie ein gezielt für bestimmte KI-Workloads zugeschnittenes DLA-Subsystem.
Startpunkt war ein etabliertes Szenario: Auf einem ThinkStation-Setup mit entsprechender NVIDIA-GB10-Plattform hatte der Autor zunächst angenommen, es handele sich im Kern um dasselbe GB10-Hardwareprofil wie bei einem DGX-Spark-Varianteinsatz – nur mit Windows-Oberfläche. Das ändert sich, sobald ein HP OmniBook Ultra 16 mit der RTX Spark ins Spiel kommt. Zwar taucht im Geräte-Manager ein „NVIDIA NPU“-Eintrag gemeinsam mit der RTX-Spark-GPU auf und beide nutzen denselben nvlddmkm-Treiber, aber unter der Haube arbeitet ein eigener Verwaltungsweg. Entscheidende Hinweise liefern ACPI-Tabellen und Firmware-Logik: HP definiert für die DLA/NPU ein eigenes Gerät (DLA0) mit separaten Memory-Mapped-Registerfenstern, eigenen Interrupts und einer Logik, die die NPU über ACPI gezielt vor Windows „versteckt“, bis bestimmte Bedingungen greifen. Laut Treiber und internen Labels nutzt die NPU eigene Registerräume und berichtet eigene Architekturkennungen – unter anderem eine interne Bezeichnung mit „DLA-“ Präfix – und zeigt eine eigenständige Clock-Domäne, die im Leerlauf deutlich niedriger liegt als im Betrieb.
Der nächste Teil der Analyse war weniger „reverse engineering“ im Abstrakten, sondern ein harter Beweis durch Messung. Um auszuschließen, dass die NPU nur als Frontend fungiert und am Ende doch die GPU die Berechnungen erledigt, wurde die Nutzung von GPU und NPU während einer DLA-Schleife parallel beobachtet. Dabei zeigt sich: Die NPU_0 erreicht in den Tests hohe Auslastungen, während die GPU komplett untätig bleibt. Auch die Interpretation durch Windows wirkt zunächst irreführend: Im Task-Manager springt die 3D-Auslastung hoch, obwohl die GPU shaderseitig nicht die DLA-Convolutionen ausführt. Der Grund ist „hybrid mode“ – der GPU-Pfad bleibt nicht zwangsläufig rechenaktiv, sondern liefert vor allem die Scheduling- und Wartelogik, während die DLA wirklich rechnet. Ergänzend dazu weist ein CUDA-Scheduler-Test, dass kurze CUDA-Kernel-Iterationen mit sehr geringer Latenz weiterlaufen, obwohl die DLA den Hauptteil der Arbeit übernimmt. Das Muster bleibt auch dann konsistent, als der Autor einen Tensor-Core-Matrixmultiplikations-Loop mit dem DLA-Load in einem gemeinsamen Kontext ausführt: Beide Workloads beeinflussen sich kaum in der Durchsatzrichtung, was auf eine getrennte Compute-Hardware hindeutet.
Technisch interessant wird es bei der Leistungs- und Effizienzaussage, weil sie das Marketingbild von TOPS und der Realität des aktuellen Softwarepfads teilweise auseinanderzieht. In synthetischen Benchmarks erreicht die DLA bei FP16 eine im Bereich mehrerer TFLOPS liegende Leistung, abhängig davon, wie „viel Arbeit pro Task“ in die DLA-Berechnung gepackt wird. Das ist ein wichtiges Detail: Wenn nur eine einzelne Convolution pro Task läuft, liegt der Durchsatz deutlich niedriger als bei längeren Task-Ketten, etwa wenn viele 3×3-Convolutions in einem Rutsch zusammengefasst werden. Dennoch fällt das Überraschungsmoment auf der Effizienzseite: Verglichen mit FP16 auf der GPU ist die NPU nicht automatisch die effizientere Lösung, insbesondere weil hybrid mode die GPU in Betrieb hält, selbst wenn sie nicht rechnet. Bei INT8 folgt zwar die Hardware einem gewissen INT8-fähigen Verhalten – der Compiler kann passende Loadables erzeugen und die Ergebnisse stimmen – aber die erhoffte Beschleunigung bleibt in den gemessenen Szenarien aus oder fällt nur gering aus. In den Messreihen sinkt der DLA-Durchsatz bei parallelem GPU-Handling nicht, jedoch steigt die kombinierte Systemlast so, dass das Effizienzbild bei genauer Betrachtung eher zugunsten der GPU kippt.
Ein weiterer Kernpunkt der Untersuchung betrifft die Frage, wie weit die NPU über gängige Windows-APIs überhaupt „normal“ nutzbar ist. DirectML kann die NPU nicht adressieren; auch ein direktes Erstellen entsprechender Direct3D-12-Device-Konfigurationen scheitert systematisch mit Unsupported-Fehlern. Windows ML besitzt zwar grundsätzlich eine Architektur für Ausführungsanbieter, doch in der öffentlich verfügbaren Providerliste taucht der NPU-Weg für Nvidia vorerst nicht als vollwertiger Pfad auf. Der eigentlich entscheidende Engpass ist der Softwarestack: Zwar kann TensorRT für Windows on Arm DLA-Engine-Builds vorbereiten, doch die aktuellen Einschränkungen zwingen Modelle in spezielle Formen. Dazu gehören statische Shapes, ein Batch von 1 und eine Rechenstrategie, die laut Dokumentationslage im Kern auf FP16-Ausführung hinausläuft, selbst wenn INT8-Modelle als Speicherformat akzeptiert werden. Die Analyse zeigt zugleich: INT8 „geht“, wenn man aus dem TensorRT-Pfad ausbricht und direkt über den DLA-Compiler mit einer passenden C-Schnittstellen-Umgebung lädt – allerdings bleibt die Performance trotz INT8-Last weitgehend auf FP16-Niveau, was zur Enttäuschung vieler Erwartungen führt.
Warum verhält sich das so? Der Artikel legt nahe, dass das NPU-/DLA-Subsystem zwar eine Architektur aus dem „DLA“-Kosmos nutzt, aber in der aktuellen Produktgeneration in erster Linie für genau definierte Workloads und Softwarepfade optimiert ist. Indizien dafür finden sich in den Treiberständen und den enthaltenen Architekturhinweisen: Es gibt Hinweise auf eine RISC-V-basierte DLA-Entwicklung, inklusive eigener Firmware, Vektoranteilen und dedizierten Einheiten für Datenumformung. Dazu kommt ein Abgleich mit bekannten Jetson-Orin-Konzepten aus früheren DLA-Generationen: Dort ist die DLA klar als Teil eines definierten Beschleunigerlayouts beschrieben und zudem mit spezifischen „DLA“-Versionen und Pfaden in Software abgebildet. Auf der RTX-Spark-Plattform wirkt es dagegen so, als sei die NPU nicht nur vorhanden, sondern systemseitig in einem Konfigurationsmodus, der Teile der DLA-Elemente für Windows sichtbar macht, während andere Plattformen (etwa ein DGX-Spark-Einsatz) auf Linux-Seite keine DLA-Geräte „sehen“. Der Artikel stützt diese Sicht durch Firmware- und Boot-Log-Einträge, die DLA explizit als deaktiviert beschreiben.
Für Unternehmen und Entwickler ist daraus vor allem eine praktische Konsequenz abzuleiten: „TOPS“ allein ist hier kein belastbarer Leistungsindikator. Entscheidend ist, welche Modellfamilien und Operatoren im aktuellen Compiler- und Runtime-Pfad wirklich auf der DLA landen, wie viele Convolutionen pro Task verschachtelt werden können und ob die hybride Scheduling-Strategie zusätzliche GPU-Power-Lücken erzeugt. Gleichzeitig zeigt die Untersuchung, dass Transformer-nahe Operatoren (zum Beispiel Layer-Norm-, Softmax- und bestimmte GELU-Varianten) prinzipiell in der unterstützten Landschaft auftauchen können – aber nicht jede INT8-Strategie oder jede geplante Optimierung greift. So werden INT4/TopK-Pfade teils nur in eingeschränkten Achsenvarianten oder über spezielle Vektor-/RVV-Mechanismen sichtbar, während reine „Hardwareversprechen“ ohne passenden Softwarepfad im Alltag nicht automatisch Performance liefern.
Am Ende bleibt das Gesamtbild zweigeteilt: Auf der einen Seite ist das NPU-Design real, messbar und in der Lage, vollständige neuronale Netze eigenständig auszuführen, ohne dass die GPU versteckt die Rechenarbeit übernimmt. Auf der anderen Seite wirkt die aktuelle Umsetzung wie eine bewusst minimale, stark Copilot+-orientierte Integrationsschicht – mit Beta-Charakter bei den relevanten APIs und einer Softwareführung, die häufig auf FP16 statt auf echtes INT8-Throughput-Optimieren hinausläuft. Der Autor argumentiert, dass der Zeitpunkt der Softwarearbeit und die Beteiligung verschiedener Komponenten (inklusive öffentlicher Integrationsbausteine in ONNX Runtime/TensorRT-Supportpfaden) eher darauf hindeuten, dass das NPU-Subsystem im Kern bereitgestellt wurde, um eine Microsoft-seitige Anforderung zu erfüllen, statt als voll entfaltetes NVIDIA-Fokusprodukt für universelle PC-NPU-Workloads. Damit rückt die Frage nach der Zukunft in den Vordergrund: Erst wenn der Compiler- und Runtime-Pfad INT8-Durchsatzgewinne wirklich in die Ausführung übersetzt, wird aus der vorhandenen Hardwarepotenz auch eine belastbare Produktivitätskennzahl.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Nvidia RTX Spark: So funktioniert das wenig dokumentierte NPU-Design" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Nvidia RTX Spark: So funktioniert das wenig dokumentierte NPU-Design" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Nvidia RTX Spark: So funktioniert das wenig dokumentierte NPU-Design« bei Google Deutschland suchen, bei Bing oder Google News!