
LONDON (IT BOLTWISE) – Modder heben unter Linux angeblich eine softwareseitige Drosselung bei GeForce RTX-Karten auf. Für eine GeForce RTX 4090 werden im FP16-Pfad Messwerte von 165,6 auf 331,6 TFLOPS genannt. Gleichzeitig bleibt der Effekt laut Tests bei INT8-Workloads nahezu aus und bei der Token-Generierung großer Sprachmodelle stark begrenzt. Als Voraussetzung gilt unter anderem, dass Secure Boot deaktiviert ist.
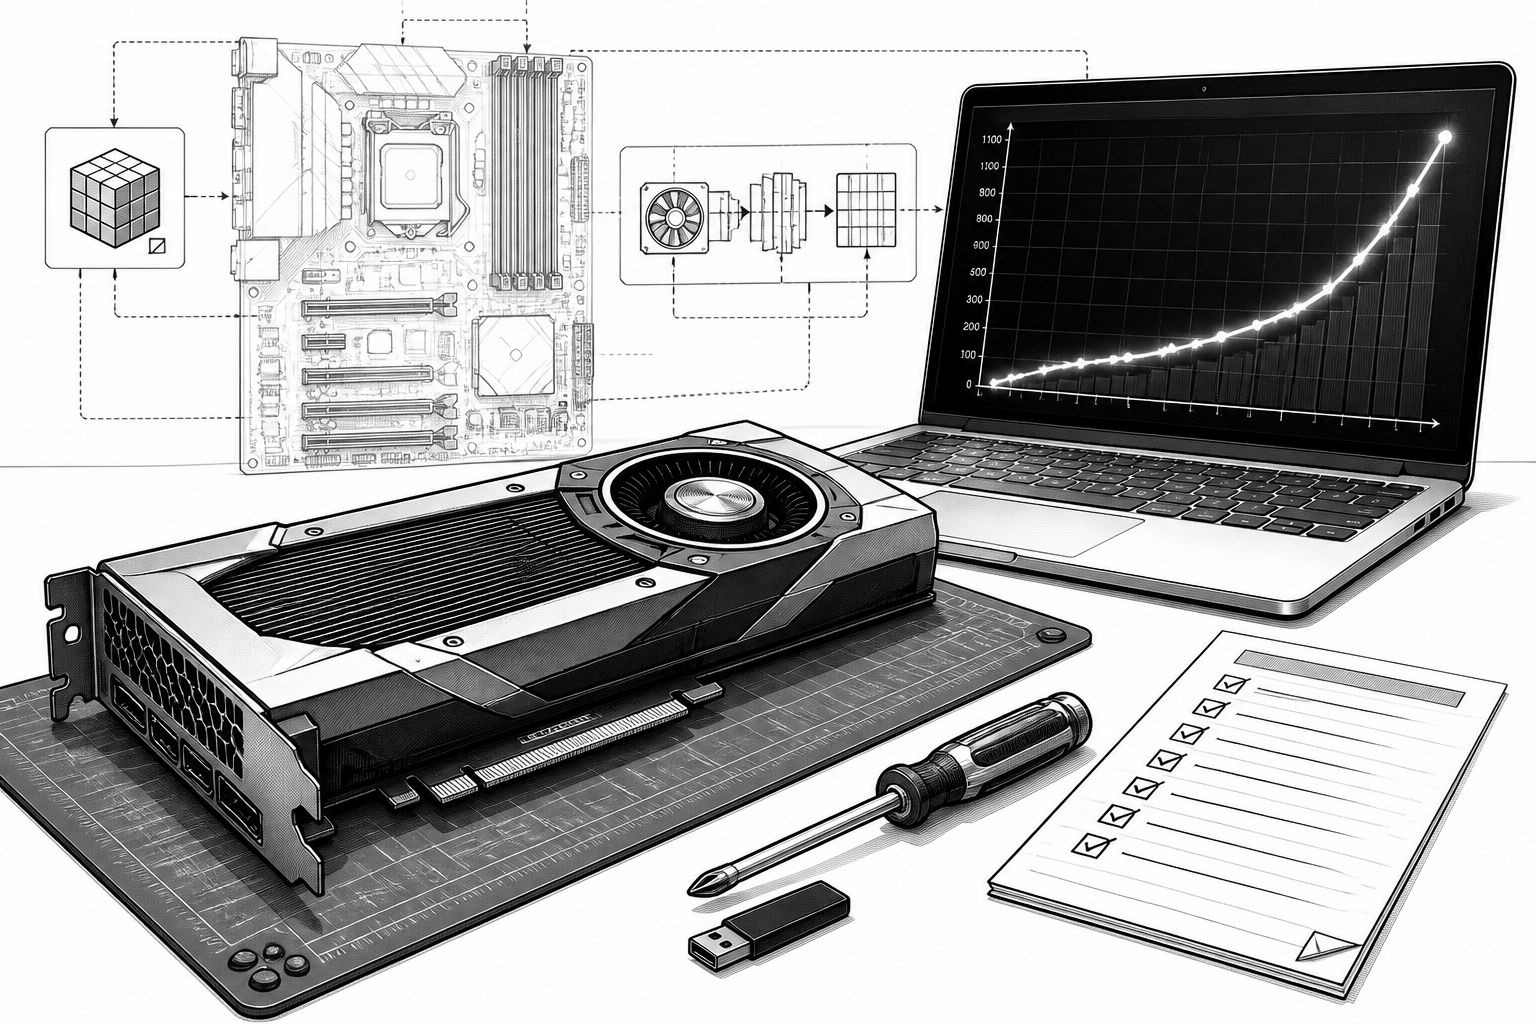
Unter Linux scheint eine ganze Klasse von Leistungsbremsen bei NVIDIA-GPUs nicht im Treiber oder im BIOS zu liegen, sondern eher in vorher definierten Registerwerten, die der Kernel-Ladepfad anlegt. Genau hier setzt die Modder-Community an: Statt das VBIOS umzuschreiben oder Grafiktreiber zu patchen, verändern Projekte wie „gpu-unlock“ per Linux-Kernel-Modul bestimmte GPU-Register kurzzeitig, bevor das eigentliche Treibersystem übernimmt. Laut den beschriebenen Arbeiten betrifft das nicht nur eine einzelne Generation, sondern die Architekturen RTX 20 (Turing), RTX 30 (Ampere) und RTX 40 (Ada). Der entscheidende Punkt: Die Anpassung soll temporär bleiben und nach einem Stromverlust oder Neustart automatisch zurückgesetzt werden.
Technisch macht diese Art des Eingriffs das Ganze für Linux-Nutzer besonders interessant, weil der Stack ohnehin aus modularen Komponenten besteht: Kernel-Modul, anschließende Treiberinitialisierung und erst danach der Zugriff auf Rechenpfade wie Tensor Cores. Das Projekt „gpu-unlock“ des Nutzers Zagitta setzt dabei auf quelloffene Entwicklungen und nennt als Durchführungsmechanismus einen Kernel-Modul-Ansatz, der Register vor dem Laden des Treibers manipuliert. Parallel dazu zielt „gpu-unlock-ada“ gezielt auf Ada-Karten und soll den Durchsatz der Tensor-Cores unter Linux verdoppeln, ebenfalls ohne BIOS-Intervention. Als Validierung werden je ein Exemplar der GeForce RTX 4090 und experimentell eine RTX 4070 Ti SUPER genannt. Für Windows-Systeme ist das Angebot der Quelle zufolge hingegen deutlich eingeschränkt; genannt wird eine TOTORONG-Variante, die sich auf eine modifizierte RTX 4080 mit 32 Gigabyte Speicher bezieht.
Besonders auffällig sind die genannten synthetischen Benchmark-Ergebnisse im FP16- und BF16-Umfeld. Bei einer GeForce RTX 4090 steigt demnach der FP16-Pfad von 165,6 auf 331,6 TFLOPS. Für die experimentelle RTX 4070 Ti SUPER wird ein Anstieg von rund 95 auf etwa 190 TFLOPS beschrieben. Auch auf anderen Modellen tauchen vergleichbare Muster auf: Eine modifizierte RTX 2080 Ti mit 22 Gigabyte zeigt für FP16 mit FP32-Akkumulation einen Sprung von 59,9 auf 111,0 TFLOPS (plus 85,3 Prozent). Gleichzeitig sollen MAMF von 57,71 auf 88,24 TFLOPS zulegen, während reine FP16-zu-FP16-Rechnungen angeblich unverändert bleiben. Das deutet darauf hin, dass der Eingriff nicht einfach „mehr Takt“ erzwingt, sondern eher eine konkrete Rechenpfad- oder Akkumulationslogik innerhalb der Tensor-Core-Ausführung adressiert.
Dass sich die Effekte nicht auf alle Rechentypen gleichmäßig verteilen, wird auch durch die Unterscheidung zwischen reinen Integer-Workloads und dem Floating-Point-Kern der Tensor-Engines unterstrichen. INT8-Workloads in realen Matrix-Berechnungen bleiben demnach ohne messbare Änderung, und bei ComfyUI wird lediglich ein Minimalplus von 0,3 Prozent berichtet. Diese Trennung ist für die Praxis wichtig: Viele Workloads nutzen zwar gemischte Präzision, aber die tatsächliche Training- oder Inferenz-Charakteristik bestimmt, welcher Pfad im GPU-Inneren dominiert. Bei großen Sprachmodellen wird für den PreFill-Schritt (Prompt-Verarbeitung) eine Beschleunigung um 14 bis 36 Prozent genannt; beim Framework vLLM wird eine Messung von 33 Prozent erwähnt. Die anschließende Token-Generierung profitiert dagegen kaum oder gar nicht, weil dieser Schritt laut Quelle vor allem durch die Speicherbandbreite limitiert wird – ein Hinweis darauf, dass selbst ein schnellerer Tensor-Core-Pfad nicht automatisch jede Latenzkomponente im Inferenzverlauf beseitigt.
Für Bildgenerierung zeigt die Quelle deutlichere Verbesserungen in bestimmten numerischen Formaten. Bei ComfyUI auf einer RTX 3090 Ti werden unter BF16 Gewinne berichtet: Modelle wie MOSS-Image SFT, Qwen-Image 2.1 Turbo, Z-Image Turbo und MiniMax H3 sollen zwischen 56,1 und 60,2 Prozent schneller laufen. Gleichzeitig sind Auswirkungen auf Bildwiederholraten in Videospielen angeblich nicht bestätigt. Das passt zu dem beobachteten Gesamtbild: Die größten Veränderungen treten dort auf, wo auch wirklich FP16/BF16- und teilweise TF32- oder FP8-ähnliche mathematische Pfade das dominante Zeitbudget bestimmen. Neben dem Leistungsversprechen zeigt sich also auch eine klare Grenze der Übertragbarkeit auf „gefühlte“ Performance im Spielebetrieb.
Wichtig bleibt der Status: Die Verfahren werden als experimentell und derzeit im Wesentlichen auf Linux beschränkt beschrieben. Für Windows existieren zwar Ansätze, darunter eine UEFI-Portierung, bei der für eine RTX 3090 ein BF16-Zuwachs von 82,5 Prozent berichtet wird. Gleichzeitig nennt die Quelle harte Voraussetzungen und Risiken. Als Voraussetzung gilt, dass Secure Boot deaktiviert sein muss; zudem liegt für die RTX-50-Serie (Blackwell) bisher offenbar kein bestätigter Unlock vor. Neben dem Verlust der Herstellergarantie werden Bootfehler, Datenverluste oder potenzielle Hardware-Schäden als mögliche Folgen genannt. Für Unternehmen, die KI-Workloads mit GPUs betreiben, ist damit weniger die reine Zahl an TFLOPS entscheidend als die Frage, wie gut sich so ein Eingriff in ein kontrolliertes Betriebs- und Update-Management einbetten lässt.
Aus Branchenperspektive lässt sich die Relevanz dennoch gut begründen: Wenn sich ein Teil der Rechenleistung über Linux-seitige Kernel-Modifikationen freischalten lässt, verschiebt das den Fokus vom „Black Box“-Gefühl rund um Fertigtreiber hin zu reproduzierbaren, quelloffenen Mechanismen. Für Entwicklerteams bedeutet das konkret, dass sie bei der Präzisionsauswahl (FP16, BF16, TF32), beim Batch- und PreFill-Design sowie bei der Messstrategie stärker in die Tiefe gehen müssen, statt nur auf generische Benchmark-Scores zu schauen. Gleichzeitig unterstreicht der Befund, dass die Token-Generierung oft an Speicherbandbreite hängt: Selbst ein frei geschalteter Tensor-Core-Pfad macht nicht automatisch den gesamten Inferenzprozess schneller, wenn der Engpass woanders liegt. Wer diese Erkenntnis praktisch nutzt, kann seine Optimierungen gezielter planen – aber eben nur, wenn die Risiken des Eingriffs im eigenen Betrieb akzeptabel bleiben.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "RTX 4090 unter Linux: Modder verdoppeln FP16-Durchsatz auf 331,6 TFLOPS" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "RTX 4090 unter Linux: Modder verdoppeln FP16-Durchsatz auf 331,6 TFLOPS" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »RTX 4090 unter Linux: Modder verdoppeln FP16-Durchsatz auf 331,6 TFLOPS« bei Google Deutschland suchen, bei Bing oder Google News!