
LONDON (IT BOLTWISE) – Der KI-Boom trifft auf ein ökonomisches Grundproblem: Tokens werden zwar stärker nachgefragt, aber gleichzeitig sinken die Preise pro Recheneinheit. Gleichzeitig steigen Strom-, Chip- und Kapazitätskosten für Rechenzentren, sodass die Margen unter Druck geraten. Besonders riskant ist das für Geschäftsmodelle, die Erlöse direkt an den Token-Preis koppeln. Damit verschiebt sich die Bewertung vieler Anbieter weg von Wachstumserzählungen hin zu Kapitalkosten und Preissetzung.
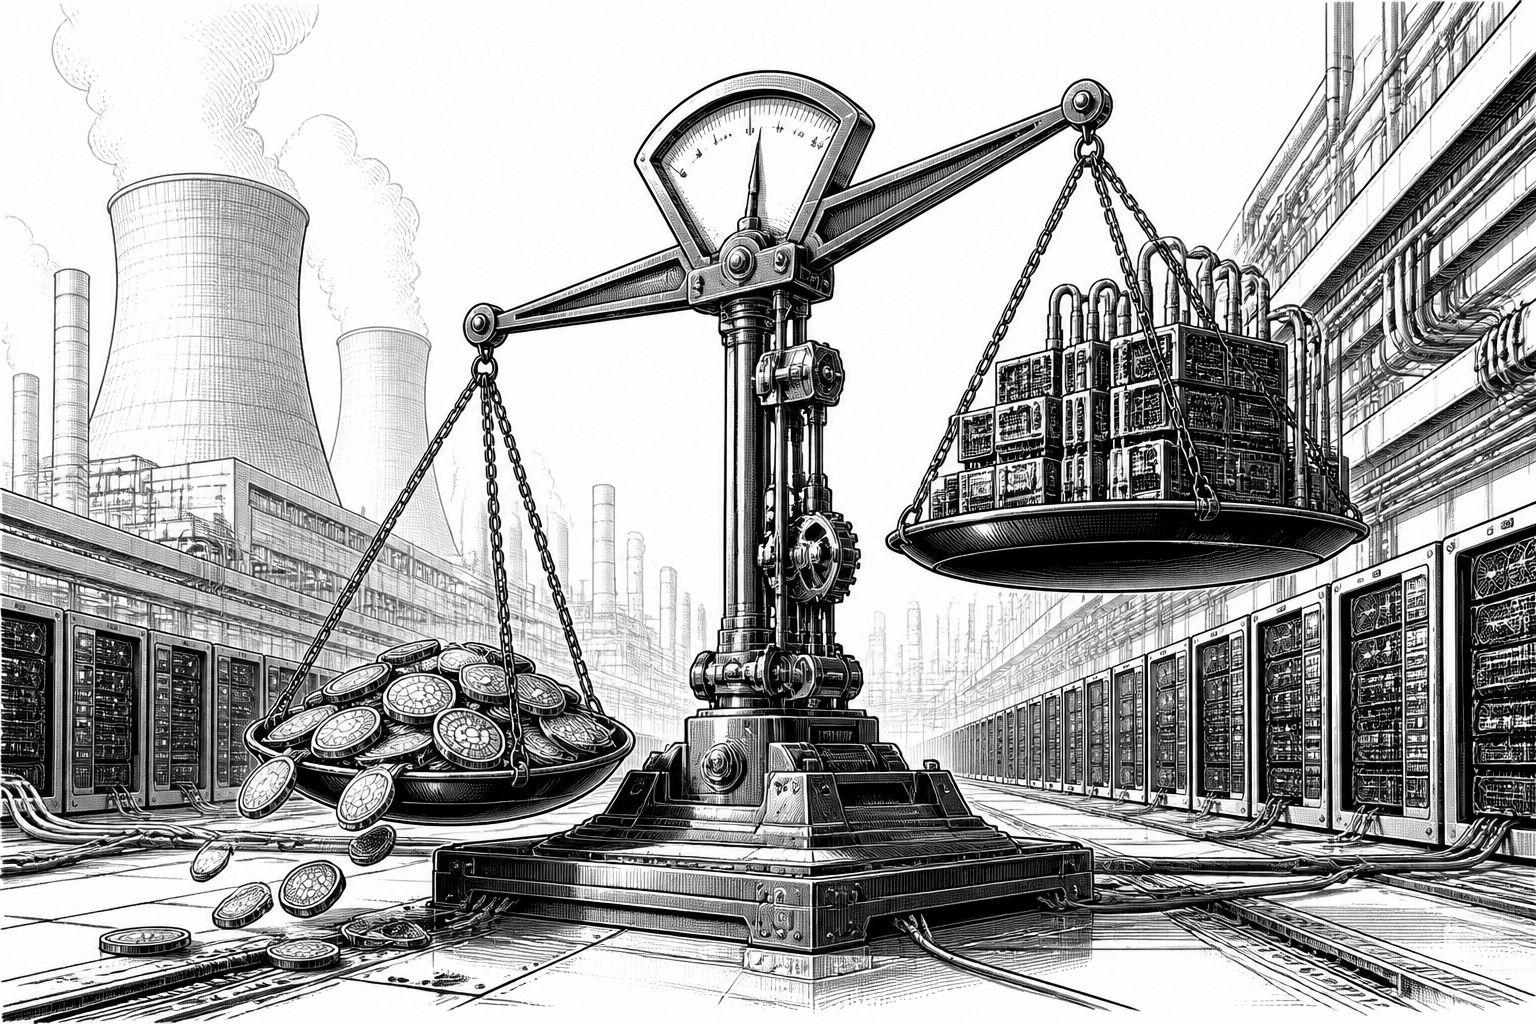
Der KI-Hype wirkt nach außen oft wie eine geradlinige Erfolgsstory: Mehr Nutzer, mehr Anfragen, mehr Umsatz. Intern entsteht jedoch ein Spannungsfeld, das viele Unternehmen erst dann vollständig spüren, wenn sie ihre Einheitsökonomie sauber durchrechnen. Im Kern geht es um die „Token-Ökonomie“: Wenn der Preis für die Bereitstellung von KI-Output sinkt, während die direkten Kosten pro Anfrage steigen, rutscht die Marge unter die Schwelle, ab der Skalierung automatisch profitabel wird. Gerade weil Künstliche Intelligenz heute sehr eng mit nutzungsbasierten Abrechnungsmodellen verknüpft ist, wird aus einer technologischen Entwicklung schnell eine Preis- und Kostenfrage.
Technisch betrachtet ist diese Verschiebung plausibel, denn die Kosten entstehen nicht nur im Modelltraining, sondern vor allem im Betrieb. Für jede Anfrage fallen Inferenzkosten an: Rechenzeit auf Beschleunigern, Speicherzugriffe, Netzwerk-Overhead und der Energiebedarf der Rechenzentrumsinfrastruktur. Gleichzeitig erhöhen sich in vielen Regionen die Kostenblöcke, die lange als „tendenziell planbar“ galten – Strompreise, die Verfügbarkeit von Chips sowie die Investitionen in neue Rack- und Kühlinfrastruktur. Wenn dann die Marktpreise für Tokens unter Abwärtsdruck geraten, kippt das Verhältnis. Entscheidend ist dabei nicht nur das absolute Kostenniveau, sondern die Frage, ob ein Anbieter seine Grenzkosten durch Engineering – beispielsweise effizientere Serving-Pipelines, bessere Batch-Strategien oder optimierte Modellvarianten – so senken kann, wie es der Preiswettbewerb tut.
Aus Marktsicht verstärkt sich dieser Effekt durch den Wettbewerb um „Intelligenz pro Euro“. In der Quelle wird OpenAI und Anthropic als vordergründiger Brandherd genannt, weil ihre Umsatzlogik stark am Verkauf von Tokens hängt und weil sie gleichzeitig in großem Umfang Kapital für Kapazität und Forschung binden müssen. Das Problem ist weniger, dass Wachstum per se verlustreich wäre, sondern dass der Markt zunehmend eine schnellere Preiskorrektur einpreist als viele Annahmen im Business-Plan abbilden. Wenn mehrere Wettbewerber Agenten-Workflows in ähnlicher Qualität relativ zügig bereitstellen können, verschiebt sich der Differenzierungsraum: Funktionen und Automatisierungsgrade werden schneller vergleichbar, und damit wird der Preis zum dominanten Faktor. In solchen Phasen sterben Margen typischerweise nicht im „Line-of-sight“-Marketing, sondern im Betrieb – also dort, wo jeder zusätzliche Nutzer direkt auf die Kostenrechnung durchschlägt.
Besonders gefährlich wird es, wenn Investitionen und Nachfrageerwartungen zeitlich auseinanderlaufen. Hyperscaler und deren Zulieferer investieren in großem Umfang in neue Rechenzentrums- und Netzwerk-Kapazitäten – oft mit der Prämisse, dass die Nachfrage nicht abreißt und das Wachstum die Skaleneffekte verstärkt. Genau an diesem Punkt greift das Konzept der stranding assets: Anlagen, die zwar gebaut wurden, aber nicht in dem erwarteten Umfang ausgelastet werden können und dadurch wertmindernd wirken. In der Praxis hängt die Auslastung nicht allein von der Anzahl der Modelle ab, sondern von der Mischung aus Workloads (kurze Chats vs. lange Kontexte, batchfähige Aufgaben vs. interaktive Latenzanforderungen), von Vertragsstrukturen (Commitments vs. rein nutzungsbasiert) sowie von der Preiselastizität auf Kundenseite. Wenn sich also die Token-Ökonomie schneller verschlechtert als das Volumen steigt, bleibt weniger Spielraum, um zusätzliche Kapazität wirtschaftlich zu verwerten – und genau das kann zu einem Teufelskreis aus Preisdruck und ineffizienter Auslastung führen.
Historisch betrachtet folgt der Markt damit einem bekannten Muster, nur dass diesmal Künstliche Intelligenz der Beschleuniger ist: Neue Rechenplattformen, neue Ökosysteme und sinkende „Kosten pro Leistung“ lösen zunächst Investitionswellen aus. Später kommt es häufig zu einer Marktbereinigung, weil die Preise schneller sinken als die Kostenstrukturen im Betrieb nachziehen. Bei KI ist dieser Zyklus besonders sichtbar, weil Inferenz wie eine durchgerechnete Dienstleistung behandelt werden kann: Man misst, wie viele Tokens produziert werden, welche Antwortlatenz erreicht wird und wie hoch die direkten Kosten sind. Dadurch werden ökonomische Annahmen harten Benchmarks unterworfen, die früher eher in klassischen Cloud-Services üblich waren – nur dass hier die „Leistungseinheit“ nicht CPU-Zeit ist, sondern Modelloutput, der wiederum in viele Produkte und Prozesse eingebettet ist.
Für Unternehmen bedeutet das eine deutlich nüchternere Planungslogik. Wer eine KI-Anwendung kauft oder baut, sollte nicht nur auf Modellqualität schauen, sondern auf die gesamte Preis-Kosten-Kette: Welche Preisstaffeln gelten bei steigender Nutzung? Wie entwickeln sich die Energie- und Betriebskosten im jeweiligen Datacenter-Cluster? Welche Rolle spielen Effizienzmaßnahmen wie Quantisierung, bessere Caching-Strategien, dynamische Batchings oder der Einsatz spezialisierter Inferenzpfade? Und vor allem: Gibt es Preissetzungsmacht oder nur eine „Durchreichung“ von Tokenkosten? Wenn Anbieter keine Möglichkeit haben, den Preis pro Output entlang ihrer eigenen Grenzkosten stabil zu halten, dann werden Bewertungen stärker von Kapitalkosten, Auslastungsrisiken und Operating Leverage geprägt – also davon, wie robust das Modell im ungünstigen Szenario bleibt.
Der strategische Hebel liegt daher weniger in der Hoffnung auf unersättliche Nachfrage als in der Fähigkeit, Kostenkurven schneller zu drücken als Wettbewerber. Dazu gehört auch, Angebote so zu gestalten, dass der Wert nicht ausschließlich am Tokenpreis hängt – etwa über Ergebnisorientierung, Modellwahl je nach Risiko und Genauigkeitsanforderung oder über Produktfeatures, die Kunden in eine langfristige Nutzung bringen. Daneben zeigt der Markt, dass Infrastrukturentscheidungen immer stärker mit der Produktökonomie verknüpft werden: Wer Rechenleistung als Ware einkauft, importiert Preisschwankungen direkt in die eigene Kostenbasis. Genau deshalb verschiebt sich die Diskussion rund um Künstliche Intelligenz zunehmend von „Welche Modelle gewinnen?“ zu „Welche Geschäftsmodelle überleben Preiskorrekturen?“
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "KI-Boom unter Margendruck: Tokenpreise fallen, Rechenkosten steigen" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "KI-Boom unter Margendruck: Tokenpreise fallen, Rechenkosten steigen" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »KI-Boom unter Margendruck: Tokenpreise fallen, Rechenkosten steigen« bei Google Deutschland suchen, bei Bing oder Google News!