
LONDON (IT BOLTWISE) – Ein internationales Replikationsprojekt kommt zu einem nüchternen Ergebnis: Nur rund die Hälfte der überprüften wissenschaftlichen Aussagen hält sich beim erneuten Test. In den Nachfolgestudien sinkt die gemessene Effektstärke im Mittel deutlich, von einem Median von 0,25 auf 0,10. Die Arbeit deckt diese Muster über mehrere Disziplinen hinweg auf, von Psychologie bis Bildung. Damit verschiebt sich die Aufmerksamkeit weg von Einzelfunden hin zu systematischer Unsicherheitsbewertung.
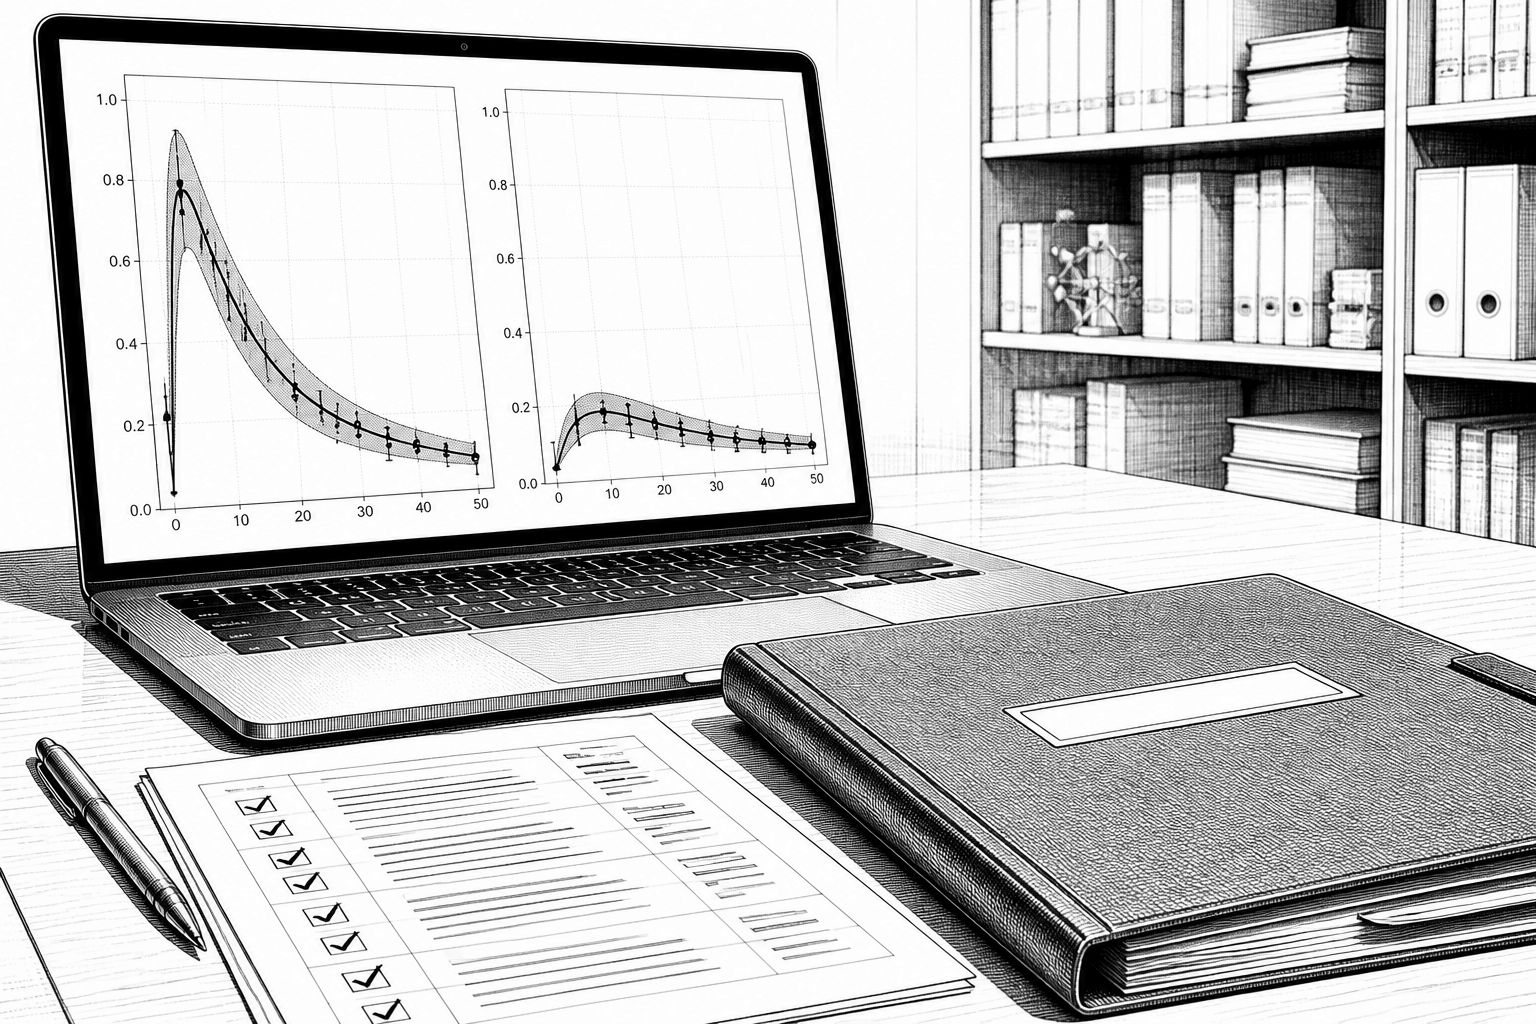
Sozial- und Verhaltenswissenschaften stehen selten im gleichen Atemzug mit Messgenauigkeit wie etwa bei der Physik. Umso bemerkenswerter ist deshalb das Ergebnis eines großen, länderübergreifenden Replikationsprojekts: Von 274 einzeln getesteten wissenschaftlichen Aussagen aus 164 quantitativen Papern zeigte im Durchschnitt nur etwa die Hälfte das erwartete statistische Muster in die gleiche Richtung wie in der Ausgangsarbeit. Noch klarer wird das Bild, wenn man nicht nur „Signifikanz ja oder nein“ betrachtet, sondern die Größe des Effekts. Die Studien berichten, dass die beobachteten Zusammenhänge in den Replikationen deutlich kleiner ausfallen – im Median von 0,25 auf 0,10, was eine massive Abschwächung der Erklärungskraft nahelegt.
Zur Einordnung hilft ein Blick darauf, was bei Replikationen tatsächlich geprüft wird: In der Forschung bedeutet ein Replikationsversuch, dass eine frühere Fragestellung anhand möglichst gleicher Logik erneut untersucht wird – mit unabhängigen Daten oder einer unabhängigen Datengrundlage –, um zu sehen, ob die ursprüngliche Schlussfolgerung stabil bleibt. Für die Praxis ist das relevant, weil viele Entscheidungen außerhalb der Laborwelt auf publizierten Resultaten beruhen: etwa bei der Entwicklung von Bildungsmaßnahmen oder bei politischen Interventionen. Wenn ein Befund nur in der Originalstudie „funktioniert“, aber im erneuten Test schrumpft oder ausbleibt, verschiebt sich der Informationsgehalt erheblich. Das Projekt betont damit nicht nur methodische Details, sondern auch den Kern der wissenschaftlichen Selbstkorrektur: Verlässlichkeit entsteht nicht durch einmalige Veröffentlichung, sondern durch wiederholte Prüfung.
Historisch war die Frage nach der Wiederholbarkeit schon früher ein Thema, etwa nachdem 2015 ein großes Replikationsvorhaben in der Psychologie getestet hatte, dass nur rund ein Drittel der überprüften Studien die Originalergebnisse traf. Auch spätere Arbeiten in der Ökonomie und darüber hinaus deuteten auf ähnliche Muster hin: In einem Labor-Experiment-Set in der Ökonomie waren es 11 von 18 Studien, die in die gleiche Richtung ein statistisch signifikanter Effekt zeigten; eine breiter angelegte Untersuchung von Sozialwissenschaftsexperimenten kam zudem auf etwa 62 Prozent erfolgreicher Wiederholungen, allerdings mit halbierter Effektstärke. Das hier betrachtete Projekt nimmt diese Hinweise nun als Ausgangspunkt, aber erweitert den Blick systematisch über Disziplingrenzen hinweg. Die Autoren wählen dafür nicht nur einzelne Fachrichtungen aus, sondern ziehen einen repräsentativen Querschnitt aus sechs großen Bereichen: Business, Ökonomie, Bildung, Politikwissenschaft, Psychologie und Soziologie.
Technisch-organisatorisch setzt das Projekt auf eine methodisch straffe Replikationsarchitektur. Aus einer zufälligen Stichprobe von 3.900 quantitativen Papern, die zwischen 2009 und 2018 erschienen waren, wurden in 62 Journals fundierte, testbare Ansprüche identifiziert; insgesamt fanden schließlich 296 Replikationsversuche mit 274 einzigartigen Aussagen statt. Für 98 Paper sammelten die Teams neue Daten, während sie bei 66 Papern bereits existierende Sekundärdatensätze erneut auswerteten. Damit wird ein weiterer Faktor adressiert, der häufig übersehen wird: Replikationen sind nicht automatisch gleich, nur weil man „dasselbe“ testet. Unterschiedliche Stichproben, Messkonzepte und Kontextbedingungen verändern die Wahrscheinlichkeit, reale Effekte sichtbar zu machen. Gleichzeitig nutzen die Teams hohe statistische Power – im Bericht wird eine mediane Chance von 99,6 Prozent genannt, Effekte in der Größenordnung des Originalbefunds zu entdecken. Um „Hindsight“ zu verhindern, wurden Designs und Analysepläne intern vorab begutachtet und öffentlich registriert, bevor die Daten erhoben oder ausgewertet wurden.
Bei der Ergebnisbewertung zeigt sich dann, wie stark das Bild von der gewählten Messlogik abhängt. In der klassischen Bewertung, ob eine Replikation ein statistisch signifikantes Ergebnis in derselben Richtung erzielt, lagen die Erfolgsraten gewichtet nach Paper bei 49,3 Prozent und ungewichtet nach einzelnen Aussagen bei 55,1 Prozent. Null-Effekte machten einen großen Block aus, während ein kleinerer, aber nicht vernachlässigbarer Anteil sogar in die entgegengesetzte Richtung ging. Entscheidend ist aber der zweite Blick: Als standardisierte Korrelation (Pearsons r) operationalisiert, sinkt der mediane Effekt von 0,25 auf 0,10; zudem berichten die Autoren, dass große Teile der Replikationen kleinere Effektgrößen liefern. Ein Teil dieser „Schrumpfung“ lässt sich statistisch erwarten, weil positive Publikationspfade bereits natürliche Übertreibungen durch Zufallsmuster begünstigen können – ein Effekt, der in der Diskussion als Regression zum Mittelwert beschrieben wird. Das Projekt bleibt dabei jedoch nicht bei der einfachen Erklärung, sondern untersucht auch zusätzliche Kriterien: Je nach Bewertungsmodus reicht die geschätzte Erfolgsquote von 28,6 Prozent bis 74,8 Prozent, mit einem Median von 49,3 Prozent. Der niedrigste Bereich entsteht dabei tendenziell bei Methoden, die Replikationen für Abweichungen gegenüber dem Original empfindlich bestrafen, während kombinierte Metaanalysen stärker in Richtung Erfolg „ziehen“ können.
Für die Bewertung der Breitenwirkung ist spannend, dass die Erfolgsraten zwischen den sechs Disziplinen nur moderat variieren und statistisch keine großen Unterschiede zeigen. So berichten die Autoren bei gewichteter Betrachtung Erfolgsquoten von 42,5 Prozent in der Ökonomie bis 63,1 Prozent in der Bildung; Psychologie liegt bei 49,0 Prozent, Soziologie bei 51,1 Prozent, Politikwissenschaft bei 52,0 Prozent und Business bei 47,2 Prozent. Allerdings weisen die Zahlen auch auf ein praktisches Problem hin: Manche Felder tragen nur relativ wenige Paper bei, wodurch einzelne Teilbereiche stärker schwanken können. Der Jahrgang zwischen 2009 und 2018 scheint dagegen keinen statistisch signifikanten Zusammenhang mit dem Replikationserfolg zu haben. Außerdem zeigen Vergleiche zwischen „neue Daten“ und „Sekundärdaten“ ein differenziertes Bild: Signifikanzbasierte Erfolgsraten liegen ähnlich, aber bei Effektgrößen fällt der Rückgang bei neuen Daten stärker aus. Genau hier wird deutlich, dass Replikation nicht nur eine Qualitätsprüfung ist, sondern auch ein Werkzeug, um zu verstehen, wie robust Hypothesen gegenüber Stichproben- und Kontextwechseln sind.
Unterm Strich formuliert das Projekt eine unbequeme, aber für Entscheidungsträger nützliche Botschaft: Die Replizierbarkeit von Publikationen lässt sich nicht als selbstverständlich behandeln. „The basic finding is that establishing the replicability of published results cannot be taken for granted, “ lautet eine Kernaussage von Brian A. Nosek. Darin steckt auch die praktische Konsequenz, dass die Unsicherheit in der Literatur oft größer ist, als man im Alltag wahrnimmt. Auch Stephanie Zellers, eine Postdoktorandin an der Universität Helsinki, ordnet die Ergebnisse ein: „Replication is not inherently a positive thing and lack of replication is not inherently a problem.“ In der Logik ihrer Argumentation verschiebt sich der Fokus auf das gesamte Evidenzpaket, nicht auf einzelne Treffer oder Fehlversuche. Das ist zugleich ein Plädoyer für „Metaresearch“ als integralen Bestandteil der Wissenschaft, denn nur so lassen sich Systemmuster wie Publikationsbias und statistische Überoptimierung sichtbarer machen. Für Unternehmen und Institutionen, die aus Forschung Handlungsleitlinien ableiten, folgt daraus: Frühere Paper sind als Hinweise wertvoll, aber die Belastbarkeit sollte gezielt über mehrere Evidenzquellen und robuste Replikationsmuster abgesichert werden.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Replikation in den Sozialwissenschaften: Nur etwa die Hälfte hält Stand" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Replikation in den Sozialwissenschaften: Nur etwa die Hälfte hält Stand" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Replikation in den Sozialwissenschaften: Nur etwa die Hälfte hält Stand« bei Google Deutschland suchen, bei Bing oder Google News!