
LONDON (IT BOLTWISE) – In einer mehrstufigen Agenten-Pipeline verursachten Polling-Schleifen im „Lead“ rund 55 nutzlose Warteschritte, bevor sichtbar etwas voranging. Die Wartephasen verlängerten nicht nur Laufzeiten, sondern blähten auch die Token-Kosten spürbar auf. Ein Grund war ein Fehler im Design: Der Lead wusste nicht, wann die Arbeit wirklich fertig war und prüfte deshalb immer wieder denselben Status. Nach einer Umstellung auf eine flachere Struktur und verbindliche Wartelogik sanken die verschwendeten Sleeps im Betrieb praktisch auf null.
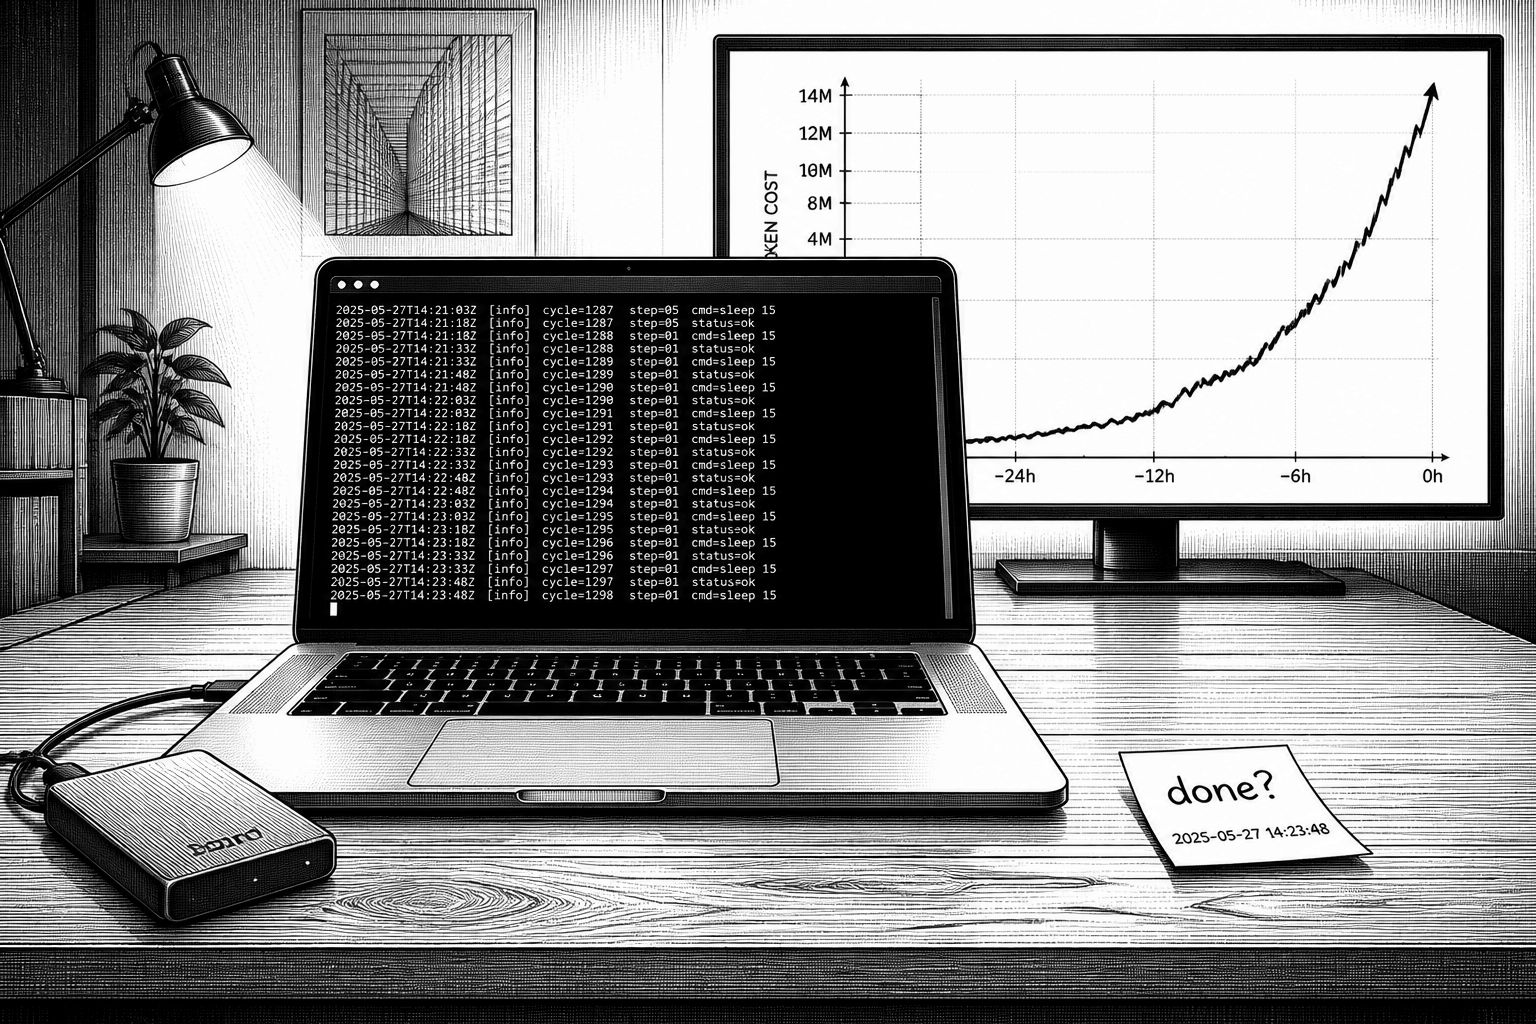
Wenn ein KI-„Agent“ auf einen anderen wartet, braucht er eine Signalquelle dafür, dass die Arbeit abgeschlossen ist. In klassischer Backend-Programmierung löst man das mit Statusübergängen, Event-Listenern oder sauberem Job-Tracking. In Agenten-Setups verschiebt sich die Verantwortung jedoch in Richtung der Modelle: Der wartende Teil entscheidet selbst, ob er aktiv nachfragt, pausiert oder wiederholt den Status abruft. Genau diese Autonomie wurde in einer produktionsnahen Multi-Agent-Delivery-Pipeline zum Kostenproblem, weil „warten und dann noch einmal schauen“ im Zweifel zur Gewohnheit wird und aus einem vermeintlich harmlosen Check eine teure Token-Schleife macht.
Der beobachtete Aufbau bestand aus drei Ebenen: einem Orchestrator, der ein „Lead“-Objekt anstößt, und darunter Teams von Worker-Agenten, die Code schreiben und ihn über Tests absichern mussten, bevor ein Ticket als erledigt gilt. Der Lead führte dabei ein Ticketboard, das als Dateien auf dem Datenträger repräsentiert war; das erneute Prüfen war für ihn daher immer nur einen Shell-Aufruf entfernt. Die strukturelle Konsequenz einer Hierarchie mit Tiefe: Zwischen dem, was der Entwickler direkt beobachtet, und dem tatsächlichen Wartelogik-Entscheidungsprozess lagen mehrere Schichten. Dort, wo niemand standardmäßig hinsieht, sammelten sich die Probleme – und im konkreten Fall entpuppte sich der Lead als schwache Stelle, weil er „Fertig“-Information nicht zuverlässig erhielt.
Die ersten Indikatoren waren weniger dramatisch als die finale Erkenntnis, aber eindeutig: Runs dauerten spürbar länger als zuvor, während die Kosten pro Durchlauf parallel anstiegen. Zusätzlich verlor der Lead zeitweise die Reaktionsfähigkeit auf Korrekturen und Pokes – für etwa einen halben Tag ignorierte er Eingaben, obwohl der Nutzer sie absendete. Hintergrund war, dass die laufenden Aufgaben den Kontext, in dem die Korrekturen eingeordnet worden wären, „überdeckten“. Auf der Detailspur zeigte sich dann ein konkretes Muster in den Logs: Sehr viele Tool-Calls waren „Sleeps“ von mehreren Minuten gefolgt von kurzen Statuschecks oder Greps auf dem Board, ohne dass diese Prüfungen tatsächlich neue Informationen lieferten. In der Auswertung wurden „wasted sleeps“ über eine Schwelle definiert (Sleep länger als 100 Sekunden und danach ein Status-/Board-Check), und bei dieser Kategorie stellte sich heraus, dass von insgesamt 303 Tool-Calls 55 davon genau in dieses Muster fielen – also fast ein Fünftel.
Technisch erklärt sich der Effekt schnell, sobald man den Mechanismus sieht. Der Lead hatte zwar Arbeit an Worker delegiert, aber keine zuverlässige Möglichkeit, von außen zu erfahren, dass das Ergebnis wirklich vorliegt. Also schlief er, weckte sich später, las den aktuellen Zustand vom Ticketboard und begann wieder von vorn. Dabei waren die Sleeps nicht nur zahlreich, sondern auch lang: Der Median lag bei 235 Sekunden; einige Warteschleifen wurden zudem „abgebrochen“ und lösten unmittelbar eine weitere Scan- und Sleep-Runde aus. Dass zusätzlich manche Checks als Pipe mit „tail“ umgesetzt waren, erklärt, warum der Prozess zeitweise blockierte: In solchen Varianten produziert das Kommando erst dann Output, wenn die vorgelagerte Operation fertig ist. Addiert man die Zeit, die der Lead in diesen Sleep-Phasen verbrachte, kam er innerhalb einer 19,3-stündigen Strecke auf 3,66 Stunden reines Warten – und genau in dieser Zeit konnte er weder Korrekturen verarbeiten noch zeitnah einen Ping oder Fix des Nutzers integrieren.
Die nächste Frage lautete: Rechnen diese Wartezyklen nicht nur Laufzeit „kaputt“, sondern verbrennen sie auch Budget? Die Token-Analyse führte in eine Richtung, die besonders für Unternehmen mit kostenpflichtigem Modellzugriff relevant ist: Prompt-Caching senkt zwar den Preis für Cache-Reads, aber es ändert nichts daran, dass jeder „Wake-up“-Turn Kontext erneut in den Prompt-Kontext überführt. Im konkreten Setup wurde der Effekt zuerst am Cache plausibilisiert: Alle Turns senden einen großen Teil des Lead-Kontexts an das Modell; solange der Cache warm ist, bleiben die Reads relativ günstig, doch Cache-Timeouts können gerade bei „gerade so langen“ Sleeps dazu führen, dass Schreib-/Lesephasen preislich aus dem Rahmen fallen. Im untersuchten Zeitfenster erwies sich der Cache als „fast stabil“: Nach dem Sleep las der Lead im Schnitt etwa 231k Tokens aus dem Cache und schrieb nur rund 13k Tokens zurück. Dennoch wurde die Rechnung am Ende nicht über „Cache-Costs“ gewonnen, sondern über die Anzahl der Zyklen. Die 55 Turns nach „wasted sleeps“ führten in Summe zu ungefähr 13,5 Millionen verarbeiteten Tokens, also über 25% dessen, was der Lead zuvor insgesamt verarbeitet hatte. Wäre das System stattdessen nur einige Male in sinnvoller Frequenz geprüft worden, läge der Token-Verbrauch für dieselbe Logik im Bereich von rund 1,2 Millionen statt der beobachteten Größenordnung – also ein Mehrfaches.
Die Korrektur bestand aus zwei Bausteinen: erst eine strukturelle Umstellung, dann ein Werkzeug-/Regelwerk. Der erste Schritt war das Entfernen der Orchestrator-Ebene und eine flachere Form, bei der der Nutzer bzw. das beobachtende System direkt mit dem Lead arbeitet. Das ist nicht „universell“ als Empfehlung gemeint, aber im Bericht wird es als bewusstes Handwerks-Setup beschrieben: Näher am eigentlichen Agenten bleiben Beobachtung und Debugging direkter, und problematische Schichten werden weniger leicht übersehen. Der zweite Schritt war die Logik für Wartetätigkeiten selbst. Künftig durfte ein Sleep nur dann auftreten, wenn der Agent dafür einen nachvollziehbaren Grund im Trace angab; alternativ wurde eine cron-ähnliche Reminder-Strategie genutzt, die zu festen Zeitpunkten auf Änderungen prüfen kann. Implementer-Agenten sollten dagegen weiter warten, aber nur auf Dinge, die tatsächlich „von selbst“ enden, etwa wenn ein Testlauf abgeschlossen oder ein Statusbericht durch ein Skript ausgegeben wird. Zusätzlich erhielt die Pipeline für kleinere Korrekturen eine Art „Fast Lane“, damit eine vierte Übersetzungsanpassung nicht erst durch dieselbe Ticket-Zeremonie für große Features muss.
Nach der Umstellung zeigte sich im Betrieb schnell ein Musterwechsel. In den folgenden zwei Wochen versuchte der Lead zwar weiterhin zu schlafen, aber die Versuche wurden jedes Mal abgelehnt, sobald die Wartelogik ohne ausreichende Begründung blieb. Der verbleibende Wartemodus bestand nur noch aus erlaubten Fällen: längere Timeouts für potenziell „tote“ Runs und eine kurze Wartezeit von 8 Sekunden, bis ein Service hochgekommen war. Die Messwerte passten zu dieser Designidee: Der Lead erzeugte 75 zusätzliche Tool-Calls, aber darunter befand sich kein einziger „wasted sleep“. Auch die nachfolgenden zehn Leads, die später liefen, zeigten keine entsprechenden verschwendeten Sleeps. Gleichzeitig wurde der Reparaturfluss spürbar schneller: Für kleine Tooling-Fixes sank die Median-Dauer von 23,2 Minuten auf 5,6 Minuten; der Anteil, der innerhalb von 15 Minuten landete, stieg von 27% auf 71%. Der Bericht betont außerdem, dass eine nachgelagerte Reflexionsstufe die Feedback-Schleife verkürzte – die Iterationen wirkten „agiler“ als vorher.
Was daran über den Einzelfall hinaus relevant ist, lässt sich in zwei Prinzipien verdichten. Erstens: Wenn Warteschleifen nicht als „kontrollierte“ Ausnahme behandelt werden, verbirgt sich ein erheblicher Anteil der Kosten in Turns, die formal stattfinden, aber faktisch keine Arbeit leisten. Entscheidend ist dabei, dass ein Entwickler den Mechanismus nicht nur qualitativ („das dauert halt“) wahrnimmt, sondern die Zahl der No-Work-Zyklen in Transcripts zählt und mit einer klaren Definition abgleicht. Zweitens: Die Tiefe einer Agentenhierarchie verlagert Sichtbarkeit. Jede zusätzliche Ebene zwischen Beobachter und Ausführungslogik ist auch eine Ebene, die man nur dann erkennt, wenn man aktiv nachschaut. In der Praxis kann eine tiefere Architektur weiterhin sinnvoll sein – aber dann braucht es jemanden oder etwas, das genau die Schicht überwacht, die warten muss. Wer Agenten betreibt, sollte darum Sleeps konsequent an Zweck und Auslöser koppeln und die Wartestrategie mit der Token-Ökonomie und den Cache-Lifetimes synchronisieren, denn innerhalb der „Caching“-Fenster wirkt das System oft günstiger, während außerhalb davon jede zusätzliche Aufwachphase die Kosten deutlich eskalieren lässt.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Agenten-Pipelines: Warum 55 Polling-Zyklen ohne Fortschritt teuer werden" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Agenten-Pipelines: Warum 55 Polling-Zyklen ohne Fortschritt teuer werden" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Agenten-Pipelines: Warum 55 Polling-Zyklen ohne Fortschritt teuer werden« bei Google Deutschland suchen, bei Bing oder Google News!