
BRÜSSEL / LONDON (IT BOLTWISE) – Eine kombinierte CARLA-SUMO-Co-Simulation reduziert den Spurhaltefehler in Tests deutlich auf 0,18 Meter. Das Ergebnis entsteht durch verteiltes Imitationslernen mit adversarialem Training gegenüber etablierten KI-Ansätzen wie PPO und Behavior Cloning. Gleichzeitig bleibt die Studie an einem zentralen Punkt vorsichtig: Eine Validierung an realen Fahrzeugen wurde bislang nicht durchgeführt. Für Entwickler bedeutet das vor allem, dass Simulationsdaten zwar helfen, die Fidelity-Lücke aber weiter kritisch bleibt.
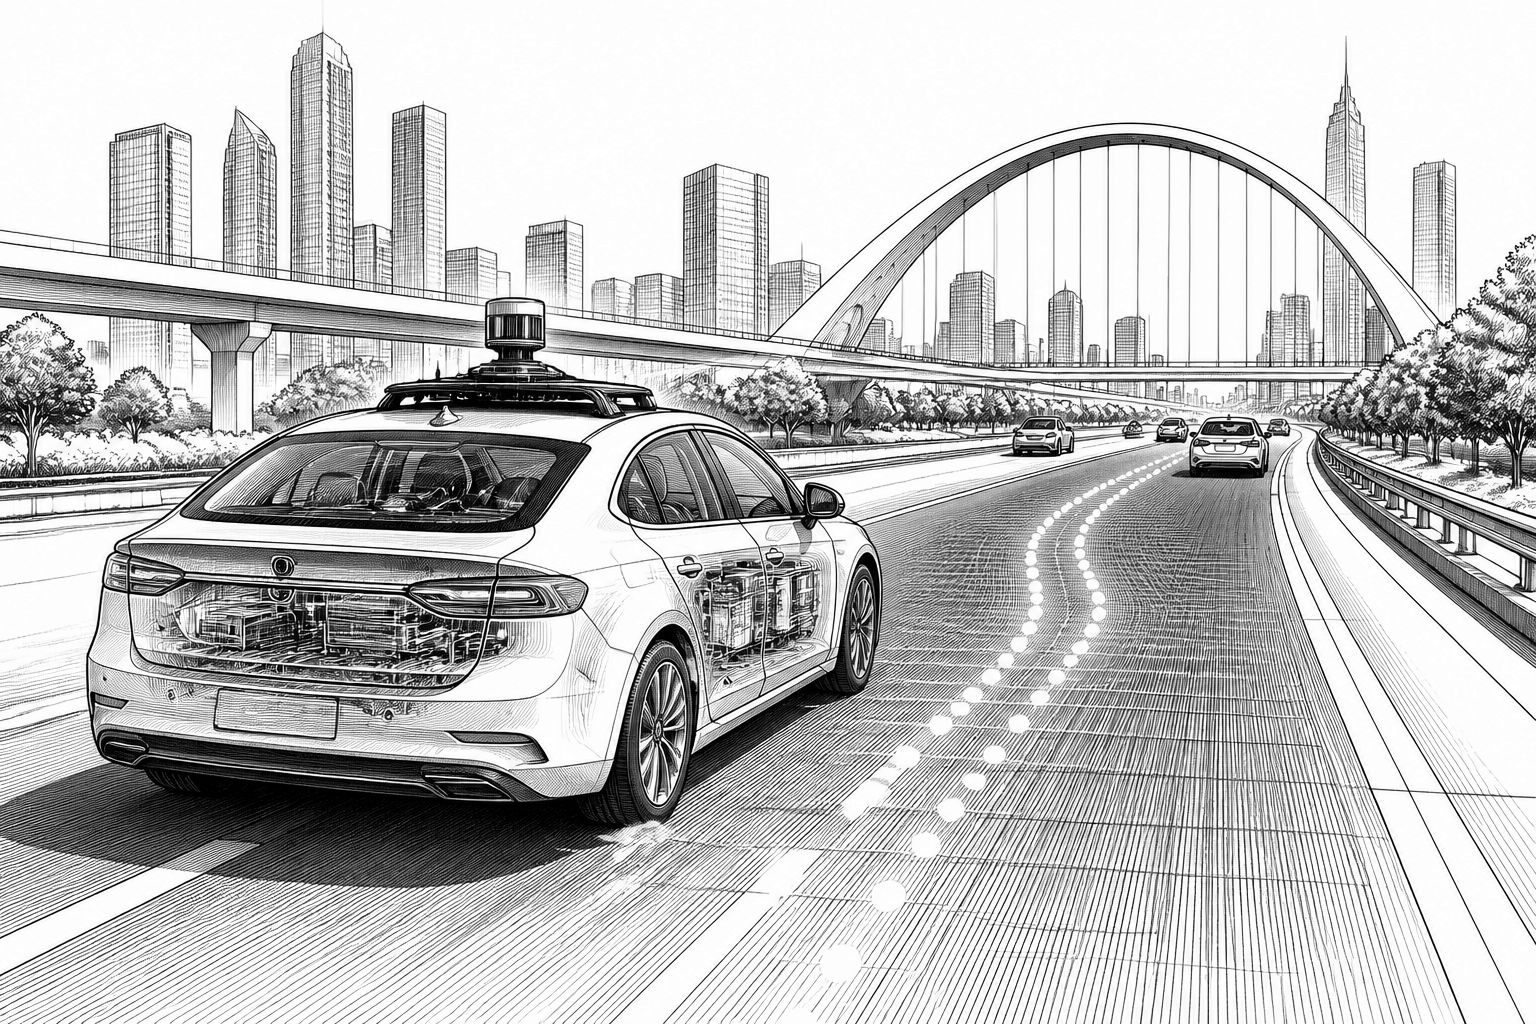
Wenn KI-Systeme in virtuellen Welten trainiert und anschließend in der echten Welt bewertet werden, entscheidet oft nicht die Modellarchitektur allein über die Qualität der Ergebnisse. Im Zentrum steht die sogenannte Fidelity-Lücke: Virtuelle Umgebungen bilden reale Dynamik und Interaktionen nur begrenzt ab, und genau diese Abweichungen können dazu führen, dass ein Agent in Trainingsläufen im Grunde auf die falsche Aufgabe optimiert. Eine von Google aufgebaute Simulationsumgebung für KI-Agenten wird in Medienberichten dabei gerade wegen einer unzureichend genauen simulierten Physik kritisiert. Der entscheidende Punkt: Gehen die Fehler aus der Simulation in die erlernte Verhaltensstrategie ein, wirkt die Performance in der Simulation wie ein internes Signal, das sich nicht ohne Weiteres in eine verlässliche externe Aussage übersetzen lässt.
Technisch betrachtet hängt diese Lücke weniger an der visuellen Darstellung als an den Modellannahmen, etwa bei Kontaktmechaniken, Reibung und dynamischen Effekten. Für Entwickler ist das besonders relevant, weil viele Trainingspipelines versuchen, reale Szenarien über Simulationen zu skalieren. Nvidia adressiert mit seinen Isaac-Werkzeugen zwar die Automatisierung von Agenten-Pipelines für Robotik und Lokomotion in Simulation, aber auch dort bleibt die Qualität von Kontakt- und Dynamiksimulationen ein Engpass. Das führt zu einer grundlegenden Messfrage: Solange unklar ist, wie Fidelity-Lücken systematisch quantifiziert werden, bleibt das Vergleichsmaß zwischen Trainings- und Einsatzumgebung unscharf. Genau diese Unsicherheit wirkt sich in der Praxis aus, wenn Teams aus dem Simulator klare Leistungsversprechen ableiten sollen.
Auch über Physikmodelle hinaus verschiebt sich die Herausforderung in Richtung Datenintegrität. In einem Fachbeitrag für SAE Europe ordnet Dr. Ebada die Abbildung virtueller Umwelten in vier Stufen ein: von der einfachen Simulation mit festen Annahmen über ein digitales Modell ohne Rückkopplung bis hin zum digitalen Schatten mit Einweg-Livedaten und schließlich dem echten digitalen Zwilling, der Abweichungen über einen geschlossenen Lernkreislauf erkennt. Als Haupthindernis sieht Ebada dabei nicht nur die Modelltreue, sondern vor allem die Integrität der Daten, die in die digitalen Abbilder fließen. Verrauschte Signale, driftende Komponenten und Inkonsistenzen können sich laut dieser Sicht über den Lebenszyklus von Fahrzeugen fortpflanzen, sodass ein KI-Modell in späteren Phasen auf eine verzerrte Realität trifft. Gerade bei der Elektrifizierung wird das Risiko noch konkreter: Hochvolt-Batteriedaten zur Zellherkunft, CO2-Bilanzen, Rückverfolgbarkeit, regionale Regulierung und thermische Modelle hängen eng mit dem Bild zusammen, das ein System über seine Umwelt lernt.
Wie sich diese Diskrepanz reduzieren lässt, zeigt ein Trend zu gekoppelten Simulationsansätzen. PTV Group und rFpro integrieren dafür die Verkehrsflusssimulation PTV Vissim mit der Fahrzeugumgebung von rFpro und decken damit Anwendungen rund um Fahrerassistenz, autonomes Fahren sowie Hardware- und Driver-in-the-Loop-Tests ab. Über ein gemeinsames Straßennetz nach ASAM OpenDrive und das Driving Simulator Interface von PTV Vissim tauschen die Systeme Daten zu Position, Geschwindigkeit und Orientierung in einem geschlossenen Regelkreis aus. Laut einem Vertreter von rFpro lassen sich so Verhaltensweisen wie aggressives Einscheren oder der Fußgängerverkehr vor Straßentests skalierbar erproben, während eine weitere Stimme aus der Branche betont, dass Testumgebungen die reale Komplexität des Verkehrs widerspiegeln müssen. Parallel dazu setzt Laplace Intelligence auf automatisierte maschinelle Stresstests: Das aus der University of Michigan hervorgegangene Unternehmen nutzt ein nachtrainiertes Nvidia Cosmos, bildet reale Umgebungen maßstabsgetreu nach und integriert Echtzeit-Verkehrsdaten unter anderem von TomTom.
Vor diesem Hintergrund ist die konkrete Studie zu CARLA und SUMO besonders aufschlussreich, weil sie nicht nur eine Trainingsstrategie beschreibt, sondern auch messbare Verbesserungen in der Regelung liefert. In der kombinierten CARLA-SUMO-Simulation wurden 50.000 Trajektorien in einem Verhältnis von 8:2 eingesetzt und 120 Testszenarien bei Geschwindigkeiten von 0 bis 15 m/s betrachtet. Beim verteilten Imitationslernen mit adversarialem Training sank der Spurhaltefehler auf 0,18 m. Gegenüber Proximal Policy Optimization (PPO) entspricht das einem Rückgang um 47,1 Prozent, gegenüber Behavior Cloning um 65,4 Prozent. Interessant ist zudem die Verkehrseffizienz: Bei 120 Fahrzeugen pro Kilometer erreichte das Modell rund 82 Prozent statt etwa 65 Prozent bei Behavior Cloning; die Kollisionsrate lag unter 3 Prozent. Trotzdem bleibt eine Einschränkung klar: Eine Validierung an realen Fahrzeugen fand im Rahmen der Studie noch nicht statt.
Für Unternehmen und Entwickler ist daraus eine zweigeteilte Schlussfolgerung ableitbar. Erstens können Co-Simulationen und KI-Trainingsverfahren die Lücke zwischen virtueller und realer Handlungsfähigkeit spürbar verkleinern, wenn sie Fidelity-Probleme aktiv adressieren und nicht nur Datenmengen erhöhen. Zweitens darf die Übertragbarkeit nicht als Selbstverständlichkeit behandelt werden, denn die Studie zeigt zwar Fortschritte in der simulierten Metrik, liefert aber noch keinen Beleg, dass sich der Nutzen eins zu eins im Feld fortsetzt. Genau deshalb gewinnt die Frage nach Test-Ökosystemen an Bedeutung: Teams brauchen nicht nur Simulatoren, sondern auch Messmethoden, die Dynamik- und Interaktionsabweichungen operationalisieren. Ergänzend deuten Initiativen wie das EU-Projekt BERTHA darauf hin, dass ein weiterer Schritt in Richtung ganzheitlicherer Modelle führt, in denen Wahrnehmung, Aufmerksamkeit, Entscheidungsfindung und emotionale Reaktionen mit abgebildet werden. Ob sich dadurch auch quantitative Verbesserungen in der Verkehrssicherheit belegen lassen, bleibt aber offen, weil die Resultate laut Quellenlage nicht als vollständige Reproduktion menschlicher Fähigkeiten verstanden werden dürfen.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "CARLA und SUMO: Studie senkt Spurhaltefehler dank KI-Co-Simulation auf 0,18 Meter" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "CARLA und SUMO: Studie senkt Spurhaltefehler dank KI-Co-Simulation auf 0,18 Meter" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »CARLA und SUMO: Studie senkt Spurhaltefehler dank KI-Co-Simulation auf 0,18 Meter« bei Google Deutschland suchen, bei Bing oder Google News!