
LONDON (IT BOLTWISE) – Bei lokaler KI entscheidet oft nicht nur die Rechenleistung, sondern vor allem die Speicherbandbreite und die Architektur der Inferenz. Der Selbstbau mit gebrauchten Serverteilen zeigt, dass CPU-basierte MoE-Modelle trotz fehlender GPU erstaunlich schnell laufen können, wenn NUMA und Threading sauber abgestimmt sind. Gleichzeitig wird deutlich, warum selbst scheinbar naheliegende Parameter wie Huge Pages in der Praxis bremsen. Wer Agenten mit sehr langen Kontexten nutzen will, bekommt zudem einen kräftigen Schub durch Flash Attention und eine sinnvolle Aufteilung zwischen CPU und GPU.
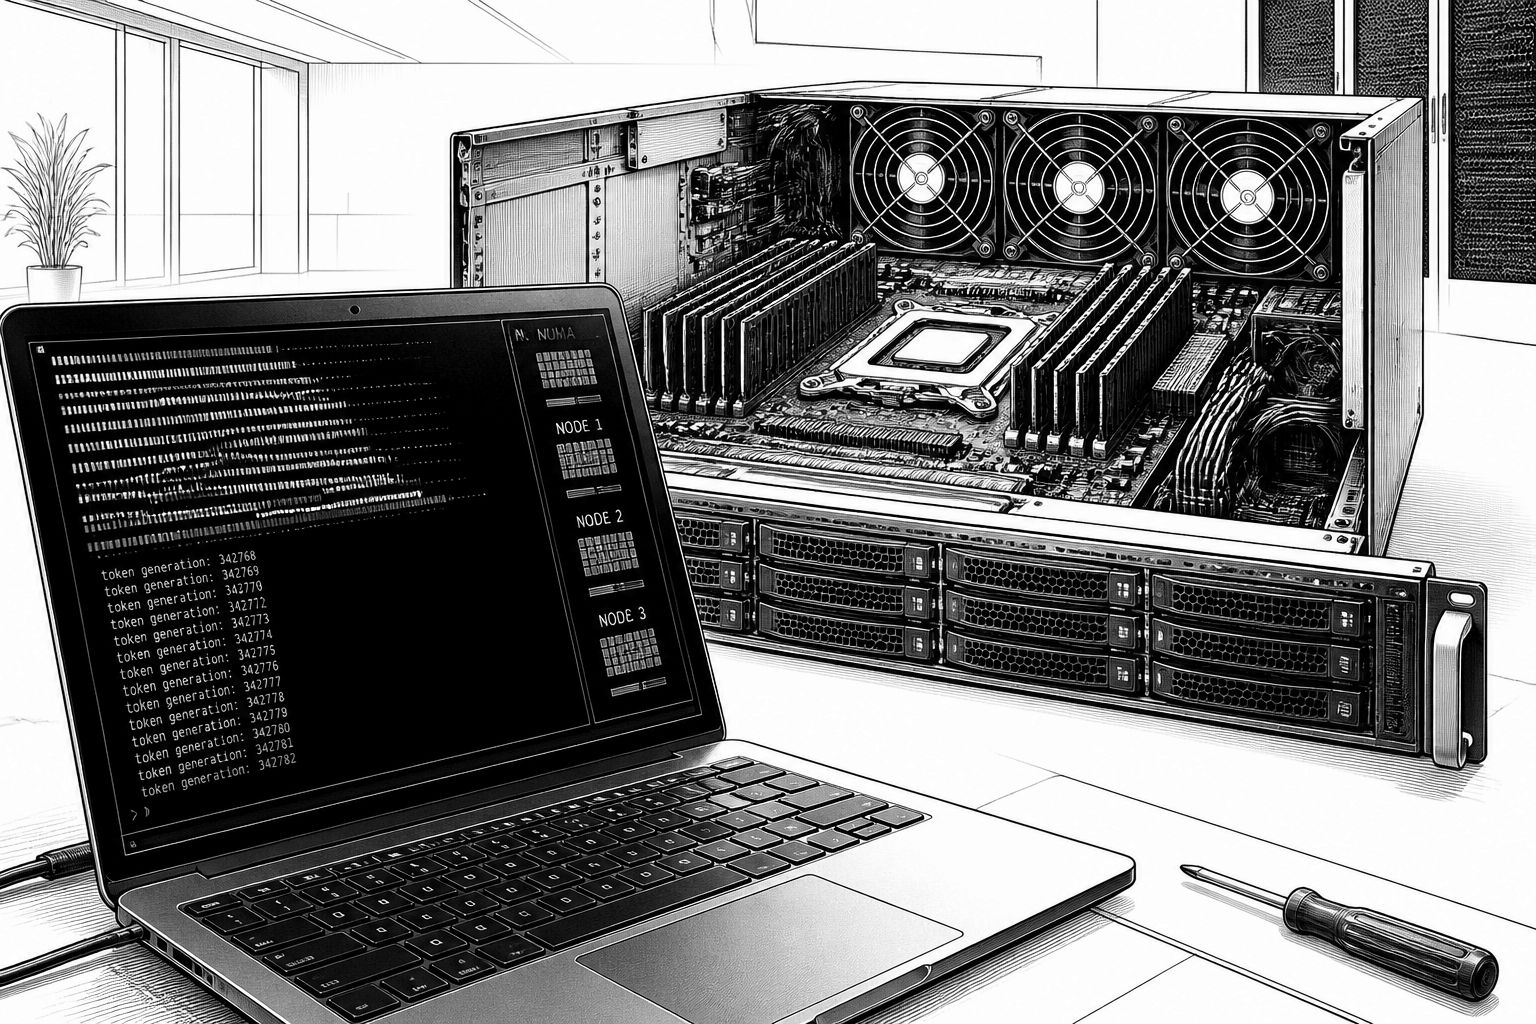
Lokale KI rückt spürbar näher an den Alltag – aber die Hardwarekosten zwingen viele Teams zu einer pragmatischen Frage: Wie viel Leistung bekommt man pro Euro, wenn man nicht von Anfang an in teure KI-Spezialsysteme investiert? In dem hier beschriebenen Aufbau geht es genau darum: Eine „KI-Workstation des armen Mannes“ soll ab einem Budgetbereich von ungefähr 900 Euro bis hin zu rund 1.500 Euro funktionieren und dabei nicht nur irgendetwas ausführen, sondern im Alltag spürbar besser sein als ein typisches Einsteiger-Setup. Entscheidend wird dabei weniger die reine Modellgröße als die Art, wie das Modell in der Inferenz verarbeitet wird – und ob die Plattform die dafür nötige Speicherbandbreite liefert.
Der Ausgangspunkt klingt zunächst simpel: Ein Modell läuft auf CPU oder GPU – solange die Daten schnell genug bereitstehen. Der Knackpunkt ist die Speicherbandbreite, weil bei der Token-Generierung in vielen Phasen ständig Daten zwischen Speicher und Recheneinheit bewegt werden. Im Selbstversuch wird deshalb ein Server mit zwei Xeon-Platinum-8380-Prozessoren als Vergleich herangezogen, inklusive insgesamt 16 DDR4-3200-Kanälen. Rechenisch landet das System bei rund 400 GByte/s Speicherbandbreite – weniger als bei manchen GPU-Referenzen wie der Titan RTX (672 GByte/s), aber deutlich genug, um auch CPU-Inferenz nicht sofort ad absurdum zu führen. Besonders interessant wird das für MoE-Modelle (Mixture-of-Experts), bei denen pro Ausgabe-Token nur ein Teil der Experten aktiviert wird. Dadurch sinkt der Bedarf, in der „Decode“-Phase ständig den kompletten Modellzustand aus dem RAM zu ziehen.
Der Vergleich kippt jedoch in der Praxis: Der Xeon-Server wird im Betrieb gemessen bis zu 680 W heiß und ist durch den Formfaktor sowie kleine, schnell drehende Lüfter so laut, dass eine Nutzung im Büro als unangenehm empfunden wird. Für ein Heim-Setup, etwa in Kombination mit einem Kellerraum, kann das dennoch funktionieren – im normalen Wohnumfeld aber nicht. Deshalb wechselt das Projekt auf eine gebrauchte Lenovo-Workstation mit AMD Epyc Threadripper Pro 3975WX und Mainboard der P620-Klasse. Die Plattform bringt acht DDR4-3200-Speicherkanäle mit und erreicht so rechnerisch bis zu 200 GByte/s. Der günstigste Weg führt hier über „refurbished“ Hardware ohne RAM: Für relativ wenig Geld wurden Registered DIMMs beschafft, sodass am Ende rund 160 GByte RAM mit 2.666 MT/s im Einsatz sind. Für die reine Speicherkapazität wirkt das wie ein Schnäppchen – doch die ersten Benchmarks zeigen, dass Leistung nicht nur aus „mehr RAM“ entsteht.
Die ersten Ergebnisse wirken wie eine Fehlinvestition: Qwen 3.8 Flash Next erreicht nur etwa 4,7 Token/s – deutlich hinter dem Xeon-Server, obwohl die Bandbreite nicht „komplett“ fehlt. Als Ursache wird das Chiplet-Design identifiziert: Bei den Zen-2-Threadrippern liegen die Speichercontroller nicht mehr direkt bei den CCDs, die CCDs hängen über das I/O-Die wiederum an die Speicheranbindung. Dadurch sinkt die effektive Bandbreite pro CCD auf Werte, die laut Beschreibung bei etwa 51,2 GByte/s (lesend) liegen. Um die volle Bandbreite zu nutzen, müssen alle vier CCDs beteiligt werden – und genau hier entstehen Risiken: Wenn Threads unkoordiniert auf Speicherbereiche zugreifen, kann zusätzlicher Traffic über das Infinity Fabric entstehen, während Schreibzugriffe unter Umständen ebenfalls langsamer werden. Eine zentrale Gegenmaßnahme ist die NUMA-Konfiguration im BIOS: Der Aufbau setzt auf NUMA-Domains per Socket (NPS4), sodass pro CCD ein passender Dual-Channel-Controller zugeordnet wird. Dazu kommt Linux-Tooling wie numactl, mit dem gezielt festgelegt wird, welche Kerne welche Speicherbereiche bevorzugen.
Auch der Software-Stack muss allerdings mitspielen. Bei ik_llama.cpp wird beim Start explizit die NUMA-Option übergeben und die Thread-Anzahl passend gesetzt; erst so werden „brauchbare“ Decode-Raten erreicht. Gleichzeitig zeigt sich eine wichtige Praxis-Erkenntnis: CPU-Inferenz funktioniert für dieses Setup vor allem mit MoE-Modellen, während „Dense-Modelle“ selbst bei vorhandenen Ressourcen oft nur wenig sinnvoll sind. Für Prompts (Prefill) liegen die Durchsätze typischerweise höher als für die eigentliche Token-Generierung; bei Qwen 3.8 Flash Next werden in der Spitze Werte um 134,4 Token/s (Prefill) und 13,5 Token/s (Decode) genannt. Für Nutzer, die lokal experimentieren wollen, ist das „nutzbar, aber geduldig“ – während die Nutzergruppe, die Agenten mit sehr langen Kontexten nutzt, davon besonders profitiert, weil sich Kontextwachstum bei diesen Workloads stark in die Prefill-Phase auswirkt.
Damit die Geschwindigkeit nicht auf der Strecke bleibt, setzt der Aufbau auf mehrere technische Hebel. Flash Attention wird als Pflichtmaßnahme beschrieben, weil es bei längeren Ein- und Ausgaben die Leistungseinbrüche abfedert; bei ik_llama.cpp ist es standardmäßig aktiv, bei llama.cpp soll es explizit eingeschaltet werden. Zusätzlich wird der KV-Cache quantisiert, um weniger Speicher zu beanspruchen; in dem Beispiel wird 8-Bit-Quantisierung für Key- und Value-Cache getrennt konfiguriert. Bei der Speicherverwaltung liefert außerdem libtcmalloc den größten „Return on Effort“: Durch ein LD_PRELOAD auf dem Debian-System werden laut Versuch knapp 10 % mehr Leistung erzielt, ohne dass der eigentliche Code stark verändert werden muss. Dagegen entpuppt sich Huge Pages in diesem Szenario als Enttäuschung – zumindest bei den getesteten Seiten-Granularitäten, wo der Decode-Durchsatz sinkt. Ein weiterer Schritt ist die strategische Aufteilung zwischen CPU und GPU: Wenn nur Teile des MoE-Modells sowie der KV-Cache auf die GPU ausgelagert werden, steigt die Effizienz, weil die CPU weniger RAM laden muss. Genau diese Hybrid-Strategie wird im Projekt über llama.cpp und ik_llama.cpp konkretisiert, inklusive weiterer Stellschrauben wie Batch- und Micro-Batch-Größe, um die Kommunikation zur GPU zu optimieren.
Für die Einsatzrealität bleibt aber ein ganz nüchterner Markt-Haken: Gebrauchtpreise ändern sich schnell. Seit dem Zusammenbau im Sommer 2026 sind die Preise für V100-Modelle mit 32 GByte laut Beschreibung deutlich gestiegen und liegen kaum noch unter 1.000 Euro; auch bei RAM und passenden Adaptern wird von engeren Angeboten berichtet. Das erklärt, warum andere Ansätze verstärkt an Bedeutung gewinnen – etwa Systeme, die stärker quantisieren oder MoE/Modell-Hosting anders aufteilen. Trotzdem lässt sich die Kernbotschaft dieses Aufbaus in die Praxis übersetzen: Wer lokale KI günstig betreiben will, sollte bei CPU-Setups nicht nur auf „mehr Speicher“ achten, sondern auf Speicherbandbreite, NUMA-Konsistenz, Flash Attention und den KV-Cache. Und wenn eine GPU dazukommt, dann nicht als „alles auf die GPU“, sondern als gezielte Ergänzung, die die schnellere Speicheranbindung dort ausnutzt, wo es beim MoE wirklich zählt.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Gebrauchte KI-Workstation: So schlagen CPU-Modelle und MoE teure Setups" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Gebrauchte KI-Workstation: So schlagen CPU-Modelle und MoE teure Setups" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Gebrauchte KI-Workstation: So schlagen CPU-Modelle und MoE teure Setups« bei Google Deutschland suchen, bei Bing oder Google News!