


SAN FRANCISCO / LONDON (IT BOLTWISE) – AMD hat auf der „Advancing AI“-Veranstaltung EPYC „Venice“ mit Zen 6 in den Vordergrund gerückt und dabei vor allem die nächste Größenordnung bei Rechenleistung betont. Der Flagship-Zielwert liegt bei bis zu 256 Kernen und einem Chiplet-Design mit vielen Compute- und getrennten I/O-Dies. Entscheidend für Rechenzentren ist zudem der Wechsel auf TSMCs 2nm-Prozesstechnik. Für Betreiber bedeutet das: mehr Durchsatz bei vergleichbarer Leistungsaufnahme und eine stärkere Taktung von HPC- und Agentic-AI-Workloads Richtung CPU-Cluster.
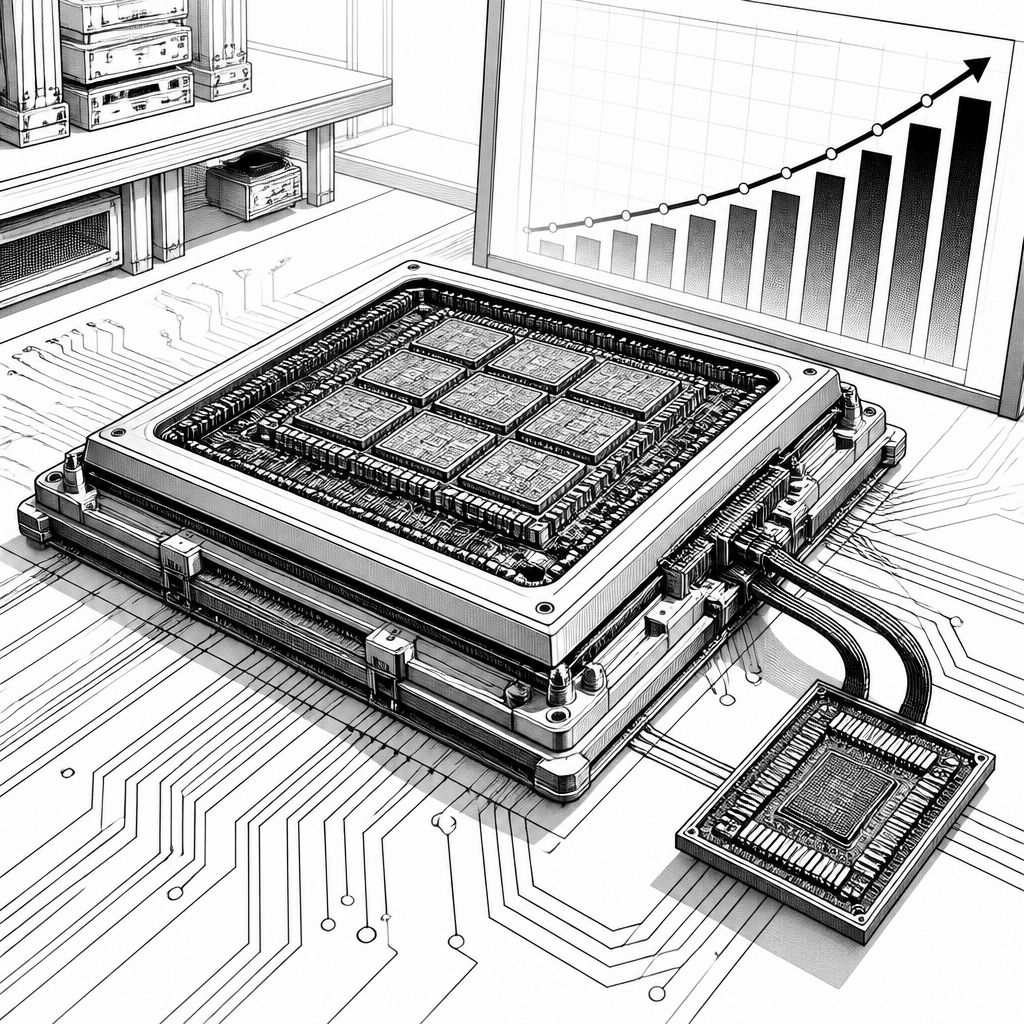
AMD positioniert EPYC „Venice“ nicht als reine Takt- oder Cache-Aktualisierung, sondern als Grundbaustein für die nächste Welle von Hochleistungs-Workloads. Im Zentrum steht dabei Zen 6 als Architekturgrundlage, die in einem skalierenden EPYC-Portfolio für Data-Center- und HPC-Szenarien eingesetzt wird. Besonders auffällig: Der Chip, der laut Sichtungen von Werbemotiven in der Halle mit dem Spitzenmodell in Verbindung gebracht wird, soll auf bis zu 256 Prozessorkerne kommen. Gerade diese Dimension ist weniger wegen „mehr Kerne“ relevant als wegen der Art, wie moderne Agenten-Workloads Rechenkapazität anfordern: nicht nur einmalige Inferenz, sondern wiederkehrendes Planen, Ausführen und Evaluieren, bei dem Parallelität, I/O-Durchsatz und effiziente Auslastung eng zusammenhängen.
Technisch betrachtet setzt AMD bei „Venice“ auf ein Chiplet-Design, das Compute und I/O bewusst entkoppelt. In der vorgestellten Konfiguration mit acht „massiven“ Compute-Dies (CCD) teilen sich die Kerne in einzelne Komplexe auf; pro CCD sind jeweils 32 Kerne vorgesehen, die wiederum in zwei 16-Core-Komplexe segmentiert werden. Die I/O-Dies sind dagegen als eigenständige Bausteine im „Middle“-Bereich gedacht und sollen viele Controller-Funktionen bündeln. In diesem Zusammenhang nennt AMD Schnittstellen- und Plattformbausteine wie PCIe 6.0, UCIe sowie DDR5. Für Rechenzentrumsbetrieb ist genau diese Trennung häufig der Unterschied zwischen einem System, das unter Last sauber skaliert, und einem, das durch Speicher- oder Interconnect-Engpässe ausgebremst wird.
Der vielleicht größte Hebel für die Effizienzstory liegt jedoch im Prozessknoten. „Venice“ soll der erste HPC-Teil aus AMDs Linie sein, der in die Volumenproduktion auf TSMCs 2nm-Prozesstechnik geht. Der Übergang von FinFET zu Nanosheet-Transistoren (GAA) wird dabei mit konkreten Zielwerten beschrieben: etwa 10–15% mehr Leistung bei gleicher Leistungsaufnahme, 25–30% weniger Energie bei vergleichbarer Leistung sowie bis zu 15% höhere Transistordichte. Solche Prozentzahlen sind für sich genommen erst einmal ein Laborversprechen, aber sie geben eine Richtung vor, wie sich die Architektur insgesamt betrachtet: Wenn Transistorgeometrie und Schaltverhalten auf dem neuen Knoten stimmen, kann man entweder die Taktfrequenz anheben oder die Spannung senken, ohne den Durchsatz zu verlieren. In beiden Fällen verbessert das die Praxiswerte für TCO-Berechnungen, denn Stromkosten und Kühlaufwand hängen direkt an Leistungsprofilen und an der Fähigkeit, Last stabil über längere Zeit zu liefern.
Für den konkreten Leistungsanspruch nennt AMD eine spürbare Steigerung bei Performance und Effizienz. In der Präsentationslinie wird eine Verbesserung von „über 70%“ bei Performance und Effizienz für EPYC „Venice“ gegenüber dem vorangehenden Generationensprung kommuniziert, während gleichzeitig eine Zunahme der Thread-Dichte von mehr als 30% im Raum steht. Dazu passt die Kern-/Thread-Beschreibung, die im selben Kontext steht: Mit bis zu 256 Kernen und bis zu 512 Threads adressiert AMD Szenarien, in denen zahlreiche parallel arbeitende Prozesse oder Simulationen dauerhaft aktiv sein müssen. Gerade im Umfeld von Agentic AI und Reinforcement-Learning-Workflows ist das wichtig, weil viele Pipelines nicht nur „einen großen Batch“ abarbeiten, sondern verteilte Entscheidungen treffen und anschließend Ergebnisse in den nächsten Schritt einspeisen. Wenn dann CPU-Kerne, Speicherbandbreite und I/O-Kapazität gemeinsam hochfahren, verschiebt sich die Engstelle weg von „GPU muss alles tragen“ hin zu „CPU-Cluster müssen den Takt der gesamten Schleife halten“.
Der Wettbewerb spielt dabei eine klarere Rolle, als es klassische Benchmarks allein zeigen. NVIDIA wird in der Agenten-Optimierung als primärer Maßstab genannt, insbesondere über eigene CPU-Optionen in Systemracks, die für Agenten- und KI-Lasten konzipiert sind. AMDs Argumentation knüpft entsprechend an zwei Achsen an: mehr parallele Rechenressourcen durch die Kernzahl und gleichzeitig bessere Single-Core-Fähigkeiten, die für nachhaltigen Throughput in komplexen Workflows entscheidend sind. Single-Core-Leistung wirkt oft dann besonders stark, wenn Threads nicht perfekt synchron laufen, wenn Scheduler-Overhead dominiert oder wenn Teile der Pipeline stärker seriell geprägt sind. In frühen Benchmark-Darstellungen, wie sie in der Quelle zusammengefasst werden, wird zudem betont, dass bereits Zen 5-basierte EPYC-Chips gegenüber vergleichbaren Systemen vorne liegen sollen und dass Zen 6 („Venice“) den Abstand weiter vergrößert, während sich die Leistung pro Leistungsaufnahme im ähnlichen Leistungsrahmen bewegt.
Damit rückt auch die Plattformstrategie in den Fokus. EPYC wird in der Quelle als Reihe aus mehreren Familien beschrieben, etwa mit „Venice“- sowie „Turin“-Ablegern, die über mehrere Generationslinien hinweg auch unterschiedliche Zielkategorien abdecken. Für Betreiber ist weniger der Familienname entscheidend als die Frage, wie gut sich diese Bausteine in bestehende Rechenzentrumsarchitekturen integrieren lassen: Welche Sockelplattform wird verwendet, wie viele Speicherkanäle stehen zur Verfügung, und wie kompatibel bleibt das System bei der nächsten Rack-Generation. In „Venice“-Kontexten werden dafür mehrere Plattformmerkmale angerissen, darunter DDR5-Support und eine PCIe-Gen-6-Orientierung. Für die praktische Bewertung bedeutet das: Entscheider schauen nicht nur auf den Maximalwert von 256 Kernen, sondern auf die reale Konfiguration aus Speicherbestückung, Netzwerkanbindung und den I/O-Pfade, die im Zusammenspiel mit GPU- oder Beschleuniger-Subsystemen die Gesamtleistung formen.
Auch wenn der Artikel die konkrete Verfügbarkeit in den Details teils offen lässt, zeichnet sich die Richtung für die nächsten Deployments bereits ab. Agentic AI erhöht die Bedeutung von CPU-Engineering: Scheduling, Parallelisierung und Interconnect-Handling werden zum dominanten Faktor, nicht nur der reine Tensor-Throughput. AMDs Wechsel zu einem 2nm-HPC-Volume-Ansatz kann dabei ein Signal sein, dass die Generationenplanung stärker an Energieeffizienz und an skalierbaren Racks ausgerichtet wird. Für Rechenzentren heißt das: Die Systemarchitektur muss künftig noch genauer auf CPU-Auslastung, Speicherbandbreite und I/O-Latenzen abgestimmt werden, weil „zu wenig CPU“ genauso schnell zum Flaschenhals wird wie „zu wenig GPU“. Wer jetzt plant, sollte folglich frühzeitig auf Plattformkompatibilität, Monitoring-Konzepte und Auslastungsprofile achten – denn die neue Kerndimension macht jede Ineffizienz im Scheduler oder in der Datenpipeline spürbar.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- NIEDLICHER BEGLEITER: Eilik ist der ideale Begleiter für Kinder und Erwachsene, die Haustiere, Spiele und intelligente Roboter lieben. Mit vielen Emotionen, Bewegungen und interaktiven Funktionen.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "AMD EPYC „Venice“ mit Zen 6: 256 Kerne, 2nm und mehr Effizienz für HPC" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "AMD EPYC „Venice“ mit Zen 6: 256 Kerne, 2nm und mehr Effizienz für HPC" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »AMD EPYC „Venice“ mit Zen 6: 256 Kerne, 2nm und mehr Effizienz für HPC« bei Google Deutschland suchen, bei Bing oder Google News!