


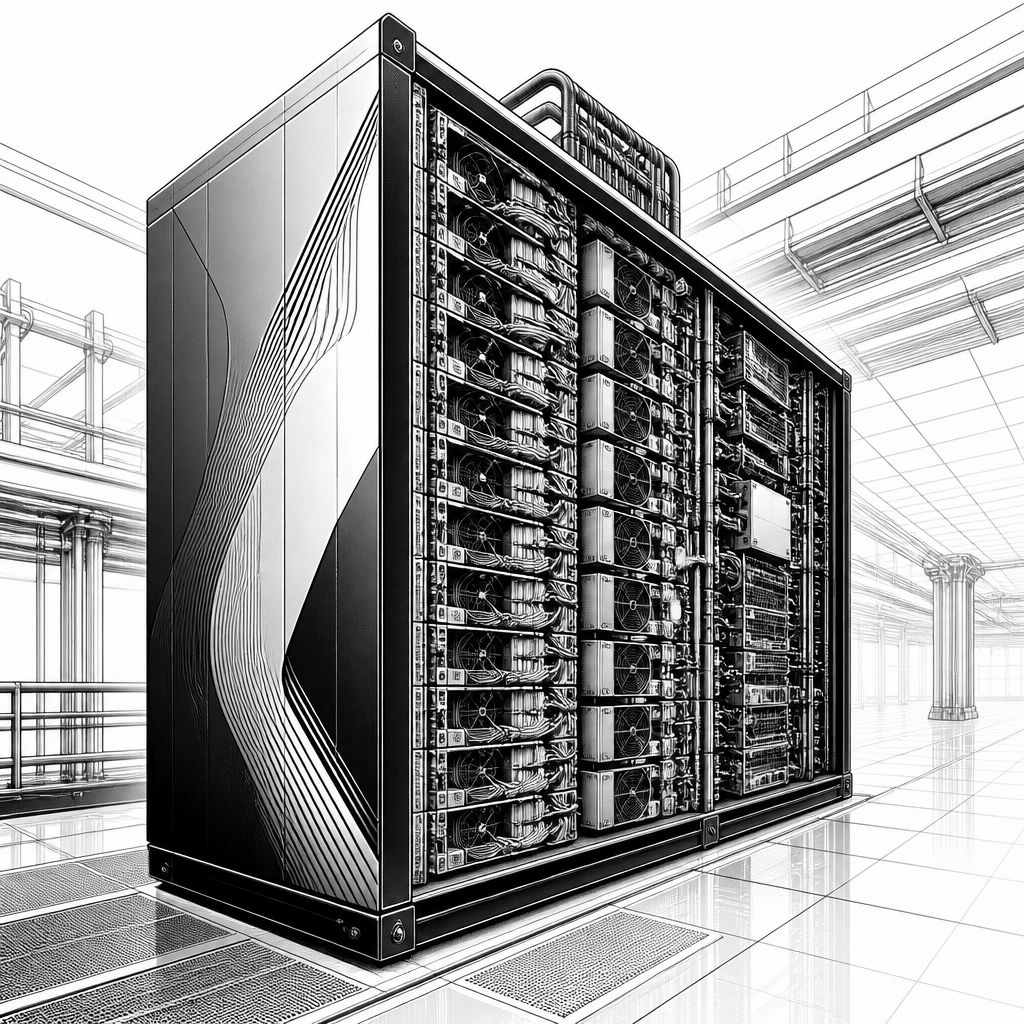
SAN JOSE, CALIFORNIA / LONDON (IT BOLTWISE) – NVIDIA meldet, dass seine Groq-3 LPX Racks vollständig in Produktion sind und noch in diesem Jahr online gehen sollen. Die Systeme sollen gemeinsam mit Vera- und Rubin-Prozessoren bei Nebius als Plattform ausgerollt werden. Im Fokus steht niedrige Latenz bei der Inferenz, damit KI-Agents beim Codieren schneller reagieren. NVIDIA nennt dabei eine Durchsatzrate von 3.400 Tokens pro Sekunde für die Groq-3 LPX Racks.
NVIDIA treibt die Kommerzialisierung von Groq nicht nur als Zukauf voran, sondern als eigenen Baustein für ein wachsendes Inferenz-Problem: KI-Anwendungen brauchen immer häufiger Reaktionszeiten, die spürbar unter dem liegen, was viele Nutzer als „Warten“ empfinden. Genau an dieser Stelle setzt das Unternehmen laut Aussagen von Dion Harris auf Low-Latency Inference – also Inferenz, bei der die Verzögerung zwischen Eingabe und erster auszugebender Ausgabe sinkt. Die Konsequenz ist klar: Wer Tokens schneller ausgibt, kann in Cloud-Angeboten mit einer höheren Zahlungsbereitschaft für zeitkritische Workloads argumentieren. Damit wird Inferenz zu einem Produktmerkmal, nicht nur zu einer technischen Detailfrage im Hintergrund.
Die neue Hardware-Schiene basiert auf Groq 3 LPX als Rack-Lösung, die NVIDIA als „in voller Produktion“ beschreibt und für einen Einsatz „später in diesem Jahr“ einordnet. Technisch unterscheidet sich der Ansatz vom klassischen GPU-dominierten Stapel: Groq zielt laut Darstellung vor allem auf den „decode“-Teil der Modell-Ausgabe ab. Dabei geht es um das sukzessive Erzeugen der nächsten Tokens, bei dem Latenz besonders sichtbar wird. NVIDIA betont zugleich, dass diese Chips GPUs nicht ersetzen. GPUs bleiben für Training und für Inferenz gleichermaßen das flexible Arbeitstier; die Spezialisierung bei Groq wirkt eher wie ein gezielt optimierter Co-Prozessor für den Engpass in der Serving-Phase.
Damit erklärt sich auch, warum NVIDIA die Groq-Architektur so detailliert an den Speicherhunger gekoppelt darstellt: Auf dem Chip sitzt laut Beschreibung 500 Megabyte schnellen SRAM direkt auf dem Die, um Speicher-bedingte Bottlenecks zu reduzieren. Die Fertigung erfolgt weiterhin arbeitsteilig in der Industrie: Groq-Chips werden von Samsung hergestellt, während die NVIDIA-GPUs von Taiwan Semiconductor Manufacturing produziert werden. In den LPX-Racks steckt zudem eine klare Skalierungsstrategie, denn NVIDIA paketiert 256 einzelne Groq 3 Chips in einen LPX-Rack-Verbund. Für die Performance nennt das Unternehmen eine Benchmark-basierte Zahl von 3.400 Tokens pro Sekunde – ein Wert, der vor allem für Use Cases zählt, in denen Nutzer bei Zeitsprüngen im Outputfluss die Qualität des Interaktionsgefühls bewerten.
Der Markt stellt sich parallel breiter auf und verschärft damit den Wettbewerb um schnelle Ausgaben: Advanced Micro Devices hat laut Quelle angekündigt, rack-scale Systeme mit Chips von Cerebras zu integrieren. Cerebras, das zuvor bereits in diesem Segment für Inferenz mit Fokus auf niedrige Latenz bekannt wurde, wurde in der Zwischenzeit öffentlich gehandelt, wodurch das Thema „Inference-Throughput“ auch an Kapitalmarkt-Erzählungen stärker andockt. Zusätzlich verweist NVIDIA auf einen „Ultrafast mode“ von OpenAI, der derzeit 750 Tokens pro Sekunde verspricht und „powered by Cerebras“ sein soll. In Summe zeigt das: Die Hardware-Frage verschiebt sich weg von „Wie groß ist mein GPU-Cluster?“ hin zu „Wie effizient liefere ich genau die Token-Ausgabe, die Nutzer in Echtzeit erleben“.
Besonders strategisch wirkt dabei die Kombination aus Groq und NVIDIAs eigener Rechenzentrums-Roadmap. NVIDIA plant, Groq 3 LPX gemeinsam mit Vera central processing units und Rubin graphics processors bei Nebius einzusetzen; die Systeme sollen erst „später in diesem Jahr“ online gehen. Gleichzeitig wird die Produktionskurve bereits sichtbar: NVIDIA berichtet, dass es seine Vera-Rubin-Systeme hochfährt, deren Produktion laut Angaben früher in diesem Jahr begonnen hat. Auf der GTC-Bühne hatte der CEO außerdem eine Absatzperspektive skizziert, wonach zwischen den aktuell verfügbaren Blackwell-Chips und den neuen Vera-Rubin-Systemen bis 2027 kumulierte Verkäufe in Höhe von 1 Billion US-Dollar erwartet werden. Auch wenn solche Projektionen stark von Auslastung und Kundensegmenten abhängen, verdeutlichen sie die Priorisierung: Für Codierungs-Anwendungen soll ein Viertel der Data-Center-Flächen für Groq eingeplant werden, der Rest für Vera Rubin.
Für Unternehmen, die KI-Systeme in Produktion betreiben, verschiebt sich damit die Architekturentscheidung in der Praxis: Statt nur auf GPU-Power zu optimieren, rückt die Aufteilung der Workload nach Laufzeitprofilen in den Vordergrund. Wo Training häufig mit großen GPUs abläuft, kann Serving – besonders bei agentischen Funktionen wie „planen, schreiben, testen“ – stärker von spezialisierten Decode-Pipelines profitieren. Genau darauf zielt NVIDIA ab, wenn es die Fähigkeit hervorhebt, Premium-Tiers für Kunden zu bedienen, die „latency-sensitive“ Service-Levels nachfragen. Der Effekt ist doppelt: Entwickler erhalten die Option, Modelle für bestimmte Antwortzyklen besser auszurichten, und Produktverantwortliche bekommen ein konkretes Argument für SLAs, Token-Preismodelle und die Gestaltung von Wartezeiten in interaktiven Tools.
Unterm Strich ist NVIDIA mit der Groq-Integration in eine Phase gegangen, in der die Inferenz-Latenz vom Nebenaspekt zur Kernkennzahl wird. Der angekündigte Ramp auf 3.400 Tokens pro Sekunde zeigt, dass „Decode“-Optimierung in der Praxis messbar sein soll – und dass sich der Preis für Cloud-Token nicht nur über Modellgröße, sondern auch über die Serving-Engine unterscheiden lässt. Entscheidend wird nun, wie schnell die Auslieferung real Kundensysteme erreicht und wie stabil die Latenz im Betrieb bleibt, sobald Lastspitzen, Batch-Strategien und parallele Nutzerzugriffe hinzukommen. Wenn NVIDIAs Vera-Rubin- und Groq-LPX-Roadmap zeitlich zusammenläuft, könnte sich der Wettbewerb damit stärker entlang von Antwortgefühl und Durchsatz entscheiden als allein entlang von Rechenleistung pro Watt.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "NVIDIA bringt Groq-Racks mit 3.400 Tokens/s in den Betrieb – noch dieses Jahr" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "NVIDIA bringt Groq-Racks mit 3.400 Tokens/s in den Betrieb – noch dieses Jahr" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »NVIDIA bringt Groq-Racks mit 3.400 Tokens/s in den Betrieb – noch dieses Jahr« bei Google Deutschland suchen, bei Bing oder Google News!