


LONDON (IT BOLTWISE) – Der Markt für KI-Inferenz soll bis 2032 auf 1,3 Billionen US-Dollar wachsen und damit das Training überholen. Der Beitrag erklärt, wie NVIDIA, AMD und Cerebras mit stark unterschiedlichen Chip- und Systemdesigns auf die Decode- und Pre-Fill-Phasen zielen. Während NVIDIA GPUs mit zugekauften LPUs koppelt, setzt Cerebras auf riesige Wafer-Scale-Chips mit speicherintensivem SRAM-Ansatz. AMD kombiniert Chiplet-Design mit gezielten Zukäufen und Partner-Architekturen, um Latenz und Kosten im Rechenzentrum zu senken.
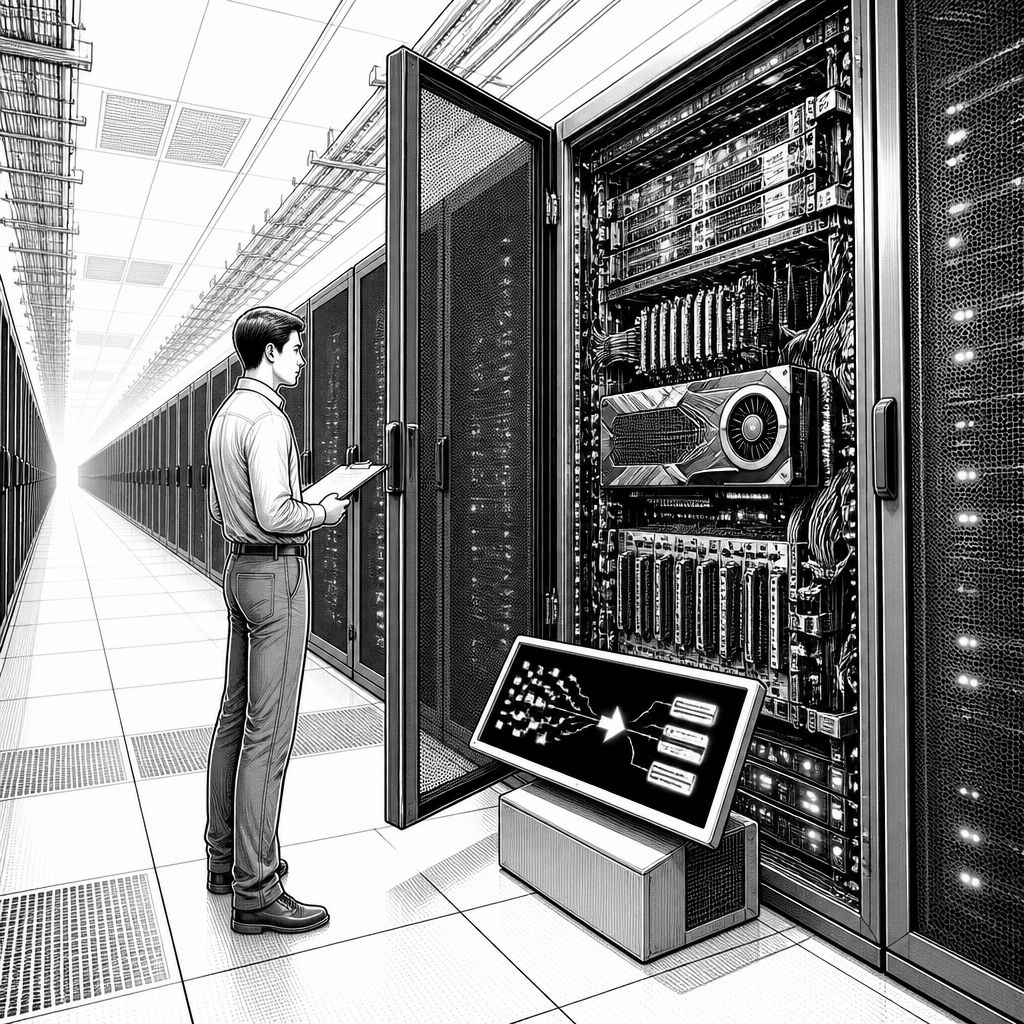
Der eigentliche Wettbewerb in der KI-Infrastruktur verlagert sich immer stärker von der Trainingsphase hin zur Inferenz: Dort müssen bereits trainierte Modelle in Echtzeit oder zumindest in sehr kurzen Antwortzeiten tatsächlich Anfragen beantworten. Wenn KI-Systeme in der Produktion landen, entscheidet nicht nur die Modellgüte, sondern auch die Frage, wie effizient sich Eingabedaten vom ersten Token bis zur Ausgabe verarbeiten lassen. Genau deshalb wird Inferenz zunehmend als Kosten- und Performancehebel betrachtet, denn jede Millisekunde Latenz wirkt sich direkt auf Nutzererlebnis, Durchsatz und Betriebskosten in Cloud- oder On-Premise-Setups aus. Laut einer Prognose soll der Inferenzmarkt bis 2032 auf 1,3 Billionen US-Dollar wachsen und damit den Trainingsmarkt übertreffen; diese Verschiebung macht sichtbar, warum Chip-Designer und Systemarchitekten gerade ihre Wege für Decode- und Pre-Fill-Workloads schärfen.
NVIDIA steht in diesem Kontext für den Ansatz, Inferenz als End-to-End-System zu denken statt nur als einzelne Recheneinheit. Der Chipkonzern verfolgt dafür die Koppelung aus klassischen GPU-Komponenten und speziellen Language-Processing-Units (LPUs), die mit direkt auf dem Chip verbautem SRAM-Schnellspeicher arbeiten. Im Kern adressiert das die Decode-Phase, in der ein Sprachmodell eine Anfrage schrittweise beantwortet; genau hier kann schneller Speicherzugriff entscheidend sein, weil die Rechenlast eng mit den Datenbewegungen im Modellablauf verknüpft ist. Indem NVIDIA nach den Angaben aus der Quelle komplette Inferenz-Systeme bereitstellt, übernehmen die GPUs das Einlesen der Eingabe, während die LPUs die Antwortgenerierung beschleunigen. Für Anbieter und Entwickler im Rechenzentrum hat das einen praktischen Vorteil: Sie müssen weniger unterschiedliche Zulieferer koordinieren, weil eine zentrale Systemarchitektur aus einer Hand unterstützt wird.
Cerebras hingegen wählt einen deutlich anderen Maßstab und will die Inferenz über extrem große, wafergroße Chipflächen beschleunigen. Auch hier spielt SRAM eine zentrale Rolle, allerdings mit einem Ansatz, der Speicher nicht primär durch feine Skalierung in kleinen Chips ausreizt, sondern physisch über die gesamte Chipgröße bereitstellt. Der Vorteil, den die Quelle nennt: Solche Wafer-Scale-Chips sollen bei Inferenzaufgaben fünf- bis sechsmal schneller arbeiten als LPUs. Gleichzeitig verschiebt sich der Aufwand weg vom reinen Rechenmodul hin zu Infrastrukturfragen, denn große Chips erfordern spezielle Kühlung sowie angepasste Energieversorgung. Deshalb werden diese Chips laut Quelle ausschließlich als Bestandteil der CS-3-Systeme verkauft oder vermietet, was das Modell preislich in eine andere Liga hebt. Interessant ist außerdem, dass das System offenbar bereits bei großen Cloud- und KI-Kunden eingesetzt wird; dadurch wirkt Cerebras nicht nur wie eine Nischenlösung, sondern bekommt Referenzen, die für weitere Rollouts entscheidend sein können. Die Quelle betont jedoch auch, dass Cerebras im Vergleich zu NVIDIA und AMD gemessen an der Unternehmensgröße weiterhin der kleinste der drei Anbieter ist.
AMD setzt schließlich auf einen hybriden Weg aus Chiplet-Technik, engerer Phasenaufteilung und mehreren Zukäufen. Beim eigenen Chipdesign erlaubt die Chiplet-Bauweise, mehr High Bandwidth Memory in ein Gesamtsystem zu integrieren und damit Latenzzeiten zu reduzieren. Entscheidend ist hier die Architekturlogik: In der Quelle wird ein Zusammenspiel beschrieben, bei dem die Helios-Rack-Lösung von AMD die Pre-Fill-Phase übernimmt, während die schnellere Decode-Phase durch die Wafer-Scale-Engine von Cerebras bearbeitet wird. Damit versucht AMD, nicht nur „mehr Rechenleistung“ anzubieten, sondern das Problem in Teile zu zerlegen und die jeweils passende Speicher- und Beschleunigungsstrategie einzusetzen. Für Betreiber kann das besonders relevant sein, weil Pre-Fill und Decode unterschiedliche Ressourceneigenschaften mitbringen: Pre-Fill skaliert oft stark mit Speicherbandbreite und Parallelisierung, Decode wiederum mit dem effizienten Umgang mit sequenziellen Token-Schritten und speichergebundenen Zugriffsmustern.
Ergänzend geht AMD über Partnerschaften hinaus und erweitert den Werkzeugkasten für Speicher- und Datenbewegungsoptimierung. In der Quelle werden zwei Entwicklungen hervorgehoben: Mit MEXT soll eine Technik eingeführt werden, die selten benötigte Daten vom teuren DRAM auf Flash verschiebt und sie mithilfe vorausschauender KI-Modelle vor dem tatsächlichen Zugriff zurückholt. Dadurch soll der DRAM-Bedarf sinken, was in der Praxis häufig einer der größten Kostentreiber in speicherintensiven Inferenzpipelines ist. Taalas wiederum wird mit Chips beschrieben, auf denen KI-Modelle fest verdrahtet sind; das macht sie weniger flexibel als universelle Prozessoren, kann aber die Ausführungsgeschwindigkeit erhöhen und die Kosten pro Einsatz reduzieren. Die Quelle skizziert außerdem ein Zielbild, bei dem AMD-GPUs die Pre-Fill-Phase abdecken, während Taalas-Chips die Decode-Phase beschleunigen. Damit adressiert AMD potenziell sowohl die Performance als auch die Wirtschaftlichkeit der Inferenz, allerdings bleibt die entscheidende Frage offen, wie stark sich diese Vorteile in heterogenen Workloads im Dauerbetrieb tatsächlich reproduzieren lassen.
Für den Markt bedeutet das: NVIDIA, AMD und Cerebras konkurrieren nicht nur um Marktanteile, sondern um die Architekturentscheidung, wie Cloud-Anbieter und KI-Entwickler Inferenz in ihre Plattformen integrieren. In den kommenden Quartalen wird sich zeigen, wessen Systemmix aus Geschwindigkeit, Kosten und Verfügbarkeit sich bei großen Cloud-Deployments am besten durchsetzt, weil genau dort Standardisierung, Servicefähigkeit und Lieferfähigkeit zählen. Gleichzeitig weist die Quelle darauf hin, dass einige Angaben zu Geschwindigkeitsvorteilen und Einsparungen bisher überwiegend aus Unternehmenskommunikation stammen und im breiten Praxiseinsatz erst verifiziert werden müssen. Für Anleger und Entscheider ist das ein wichtiger Hinweis: Gerade bei Cerebras hängt ein erheblicher Teil der bisherigen Umsätze laut Quelle von wenigen Großkunden ab, was das Geschäftsrisiko stärker an einzelne Abnehmer bindet als das breiter aufgestellte Geschäft von NVIDIA und AMD. Unterm Strich wird Inferenz damit zum Prüfstein für KI-Industrialisierung: Wer die Decode-Phase effizient, kühlbar und wirtschaftlich in Systeme gießt, bestimmt mit, wie schnell KI-Produkte im Alltag skalieren.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "KI-Inferenz boomt: NVIDIA, AMD und Cerebras liefern drei unterschiedliche Wege" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "KI-Inferenz boomt: NVIDIA, AMD und Cerebras liefern drei unterschiedliche Wege" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »KI-Inferenz boomt: NVIDIA, AMD und Cerebras liefern drei unterschiedliche Wege« bei Google Deutschland suchen, bei Bing oder Google News!