


SINGAPUR / LONDON (IT BOLTWISE) – KAYTUS hat MotusAI ausgebaut, damit Unternehmen „Token-Fabriken“ vor Ort planen, verwalten und skalieren können. Laut Anbieter soll die neue Version Betriebskosten für Token um 30 % bis 50 % senken. Im Mittelpunkt stehen lokale Datenhoheit, ein ausfallsicheres GPU-Setup und ein API-Gateway, das OpenAI-kompatibel bleiben soll. Für Produktionsteams ist zudem ein Monitoring mit Kennzahlen wie TTFT und TPS vorgesehen.
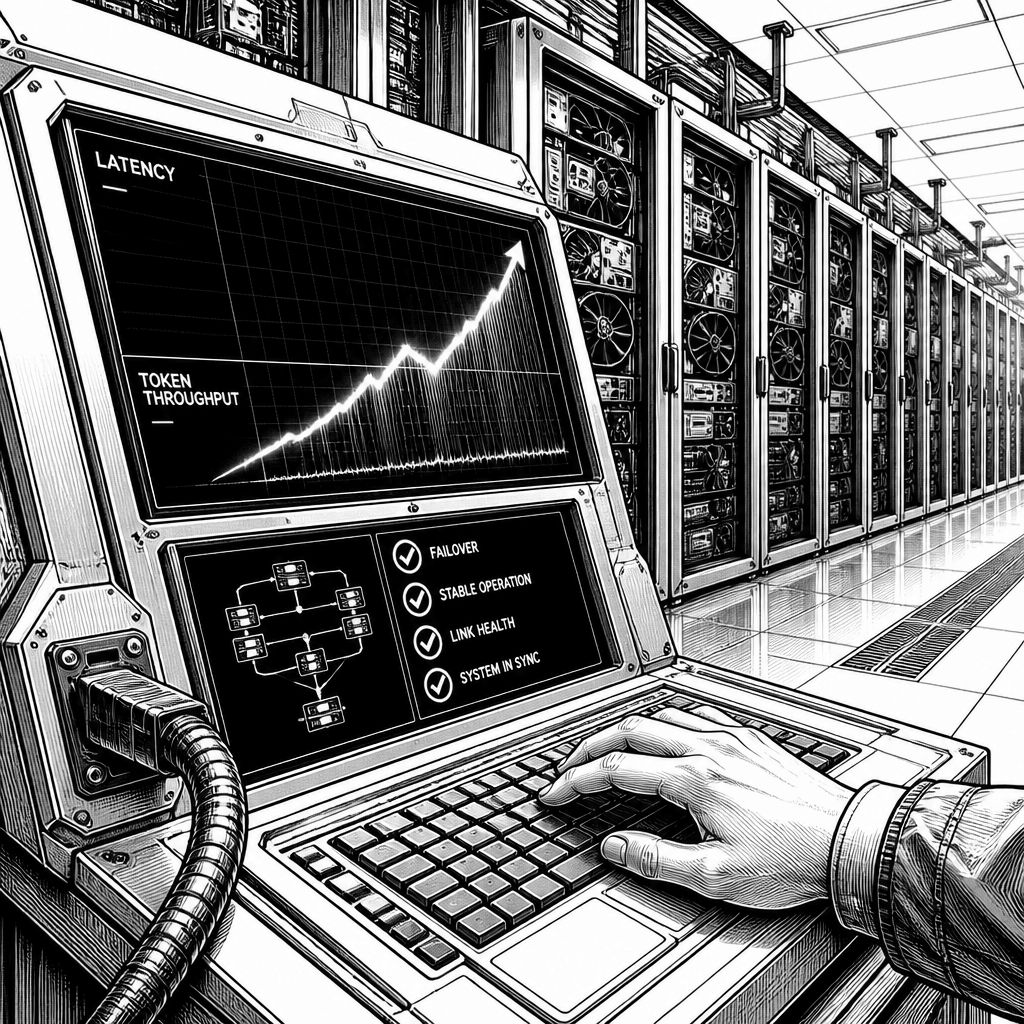
Künstliche Intelligenz verschiebt sich in Unternehmen gerade von punktuellen LLM-Abfragen hin zu agentenbasierten Multi-Agent-Systemen, bei denen mehrere Schritte, Tool-Aufrufe und wiederholte Kontextrunden zusammenkommen. Genau hier wird aus Rechenleistung schnell ein strategischer Engpass: Nicht nur das Modell selbst, sondern auch die Orchestrierung im Betrieb bestimmt, wie zügig Ergebnisse beim Nutzer ankommen. KAYTUS reagiert darauf mit einem Upgrade seiner Unternehmens-KI-Plattform MotusAI, das laut Ankündigung vor allem die Produktion von KI-„Token“ in einer kontrollierten Umgebung adressiert. Der Kernversprechen-Block ist dabei weniger ein einzelnes Modellfeature als vielmehr ein geschlossenes Betriebsmodell für das „Token-Lebenszyklusmanagement“ – also von der Erstellung und Verteilung bis zum laufenden Betrieb.
Technisch setzt MotusAI auf eine sichere, lokal installierte Infrastruktur, bei der die Inferenzverarbeitung, Modellgewichte und der Kontext im Sicherheitsperimeter des Unternehmens bleiben. Damit entfällt laut Hersteller die Notwendigkeit, für die Verarbeitung auf öffentliche Clouds oder externe LLM-APIs zurückzugreifen. Der Ansatz zielt besonders auf Branchen, in denen Datenklassifizierung und Zugriffskontrolle nicht verhandelbar sind: Finanzdienstleistungen, Gesundheitswesen und öffentliche Sektoren werden explizit genannt. Für die Praxis bedeutet das vor allem weniger Datenverlagerung und damit ein anderes Risikoprofil bei der Datenhaltung, aber auch andere Anforderungen an Betrieb, Skalierung und Ausfallsicherheit – Themen, die im klassischen „Cloud first“-Betriebsmodell oft von den Plattformbetreibern abgefedert werden.
Beim Thema Latenz und Servicezuverlässigkeit beschreibt KAYTUS vor allem Optimierungen rund um TTFT („Time to First Token“), Token-pro-Sekunde (TPS) und Pipeline-Charakteristiken mehrstufiger Schlussfolgerungen. Die Plattform nutzt dafür Mechanismen wie Prefill-Decode-Disaggregation, dynamisches KV-Caching und dynamisches Batching, um TTFT und die End-to-End-Latenz über mehrere Gesprächsrunden zu reduzieren. Zusätzlich soll das Zusammenspiel mit gängigen Inferenzlaufzeitumgebungen wie vLLM und SGLang die dynamische Skalierung verbessern: MotusAI skaliere demnach anhand von Echtzeit-Telemetriedaten auf Kenngrößen wie TTFT, TPS und GPU-Auslastung. Interessant ist auch die konkrete Produktionsreferenz aus den „Produktionstests“: Nach Erreichen von Spitzenverkehr sei die automatische Skalierung innerhalb von 21 Sekunden aktiviert worden, die Kapazität nach zwei Minuten auf 16 Instanzen erweitert und die SLA-Vorgaben wiederhergestellt worden.
Damit hängt unmittelbar ein zweites Betriebsproblem zusammen, das bei agentenbasierten Workloads oft unterschätzt wird: die Kostenkontrolle. In vielen Setups wächst die Modellnutzung unbemerkt durch wiederholte Agentenschleifen, Tool-Aufrufe oder parallele Aufgaben, und ohne Abteilungsquoten oder saubere Verrechnung wird aus „wir testen“ schnell eine unübersichtliche API-Rechnung. MotusAI adressiert das durch Transparenz im laufenden Betrieb und durch Mechanismen für Isolation in Mehrmandantenumgebungen. Administrierende sollen Abteilungsquoten setzen, Zugriffe steuern und interne Abrechnungssätze festlegen können. Zudem nennt der Anbieter als Ergebnis eine Senkung der jährlichen Betriebskosten im Zusammenhang mit Token um 30 % bis 50 %, wenn redundante Anfragen herausgefiltert und Lasten sauber verteilt werden.
Auf der Entwicklungsebene verspricht das MotusAI-API-Gateway eine schnellere KI-Entwicklung ohne Umprogrammierung. Konkret soll es OpenAI-kompatible APIs unterstützen, damit Teams Open-Source- und kommerzielle Modelle anbinden, testen und zwischen ihnen wechseln können, ohne den Anwendungscode neu schreiben zu müssen. Das ist für viele Organisationen relevant, weil Tool-orchestrierende Agenten häufig eng mit konkreten API-Schemata verbunden sind und ein Wechsel dann schnell in Anpassungsaufwand mündet. Ergänzend nennt KAYTUS die Unterstützung von Kontexten mit einer Million Token, was in der Praxis vor allem bei großen Dokumentmengen, mehrschrittigen Analysen oder Codegenerierungsaufgaben den Unterschied macht zwischen „Modell kann alles, aber nur in Häppchen“ und „Modell arbeitet mit breitem Kontextfenster“.
Der Marktbezug zeigt sich in den genannten Einsatzszenarien: Ein ausländisches Fintech-Unternehmen habe laut Beschreibung seine Plattform durch MotusAI auf acht GPU-Servern ersetzt, um Token-Dienste mit zentraler Steuerung für interne Risikoanalyse und Sicherheitsvorgaben zu betreiben. Ein japanischer Cloud-Anbieter betreibe Kernplattformen damit für mehr als 30 Unternehmenskunden gemeinsam genutzte GPU-Ressourcen und decke durchgängige Workflows für Training und Inferenz ab. Daneben wird ein südostasiatischer Betreiber erwähnt, der sich für die integrierte Hardware- und Softwarelösung statt eines internationalen Mitbewerbers entschieden haben soll und dabei auf die Multi-Tenancy- und Abrechnungsfunktionen innerhalb von MotusAI setzt. Aus der Logik dieser Beispiele wird deutlich, warum die Kombination aus Hardware-nahem Betrieb und Plattformlogik für „Token-Fabriken“ als Produktkategorie an Zugkraft gewinnt.
„Unternehmen benötigen nicht nur mehr GPUs – sie benötigen die Möglichkeit, Token-Dienste zuverlässig zu verwalten, abzuwickeln und zu skalieren“, sagte Darren Cox, GM von KAYTUS Europe. „MotusAI schließt die Lücke zwischen Hardware und Token-Betrieb und ermöglicht es Unternehmen, KI-Agenten sicher in ihren eigenen Rechenzentren zu betreiben.“ Für Entscheider ist an dieser Stelle weniger die politische Aussage im Vordergrund als die betriebliche Konsequenz: Wer Agenten im großen Maßstab einsetzen will, braucht Messbarkeit (TTFT, TPS, Cache-Effizienz), kontrollierte Ressourcenverteilung und Ausfallsicherung. MotusAI setzt dafür auf Echtzeit-Clusterüberwachung und Failover bei Knotenanomalien, was in Kombination mit der dynamischen Skalierung ein konsistenteres Qualitätsversprechen für geschäftskritische Agenten-Workflows ergeben soll.
Für die nächsten Monate wird entscheidend sein, wie gut solche Plattformen in heterogenen Umgebungen funktionieren: unterschiedliche GPU-Clustergrößen, Lastprofile mit spikenden Agentenrunden und wechselnde Modellmixe. Wenn das Zusammenspiel aus Monitoring, dynamischer Ressourcenzuteilung und API-Gateway in der Praxis hält, können Unternehmen Agenten-Workflows schneller industrialisieren, ohne für jede neue Anwendungswelle die komplette Infrastruktur umzuwerfen. Gleichzeitig bleibt das Thema Vendor-Lock-in ein kritischer Prüfstein: OpenAI-kompatible Interfaces und Modellwechsel-Workflows senken zwar die Hürde für Experimente, aber die echte Portabilität hängt dann davon ab, wie stark das Agenten- und Tooling-Schema an diese Betriebsplattform gekoppelt ist. Genau hier dürfte MotusAI in den kommenden Rollouts zeigen müssen, ob die versprochenen TTFT- und Kosteneffekte dauerhaft unter realen Produktionslasten reproduzierbar sind.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "KAYTUS erweitert MotusAI für lokale Agenten-Token-Fabriken und senkt Kosten" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "KAYTUS erweitert MotusAI für lokale Agenten-Token-Fabriken und senkt Kosten" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »KAYTUS erweitert MotusAI für lokale Agenten-Token-Fabriken und senkt Kosten« bei Google Deutschland suchen, bei Bing oder Google News!