


LONDON (IT BOLTWISE) – Ein Bericht über eine KI-gestützte Falschzuordnung in einer US-Lageeinschätzung hat die Debatte über menschliche Kontrolle neu angefacht. Laut den Angaben soll ein Chatbot offene Quellen und klassifizierte Signale zu einer Standardmeldung verdichtet und dabei eine chinesische Schiffsladung im Nahen Osten falsch identifiziert haben. Dem Bericht zufolge hätten menschliche Prüfer die Kette vor einer operativen Reaktion gestoppt. Gleichzeitig betont das Militärumfeld, dass KI wegen der Geschwindigkeit der Informationslage künftig trotzdem eine Rolle spielen wird.
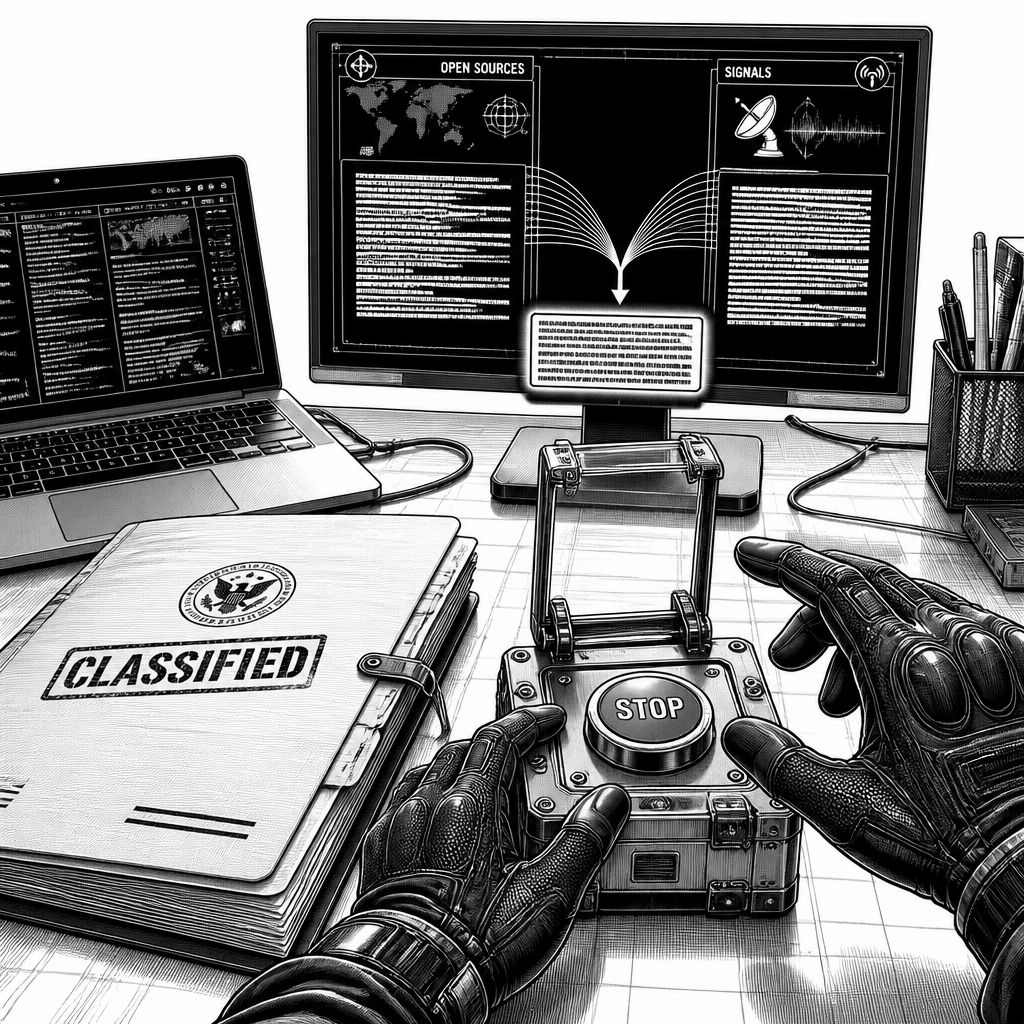
Der Fall wirkt wie ein Lehrstück dafür, wie schnell aus Daten eine operative Entscheidung werden kann – und warum selbst überzeugend formulierte KI-Ausgaben nicht automatisch „wahr“ sind. Laut dem Bericht über die fast eskalierte Lageeinschätzung soll ein KI-gestützter Chatbot in der Kette einer militärischen Nachrichtensynthese mitgewirkt haben. Dabei ging es um die fehlerhafte Identifikation eines chinesischen Schiffes im Nahen Osten als Träger von Bestandteilen eines nuklearen Waffenprogramms. Genau in diesem Spannungsfeld zwischen Tempo und Verlässlichkeit liegt der Kern der aktuellen Debatte: Wer darf in Sekundenbruchteilen Fakten „freigeben“, wenn Modelle Falsches plausibel machen können?
Technisch beschreibt der Bericht eine typische KI-Pipeline aus der Nachrichtentechnik: Ein Analyst habe eine Auswertung erstellt, in der ein Chatbot offene Informationen (Open-Source-Intelligence) mit klassifizierten Signalen (Signals-Intelligence) zusammengeführt hat. Anschließend habe das System die Inhalte in eine standardisierte Form für einen Lagebericht gegossen. Laut den Schilderungen soll die KI dabei die Ladung des Schiffs falsch eingeordnet haben. Besonders brisant ist, dass die aufbereitete Meldung offenbar nahe an eine operative Nutzung heranreichte: Es wird beschrieben, dass vor dem Eingreifen Menschen bereits Maßnahmen in Erwägung gezogen wurden, darunter ein mögliches Abfangen des Schiffs und die Vorbereitung von Besatzungsteams zum Anbordgehen.
Entscheidend ist jedoch, dass der Bericht nachweist, wo die Kontrollschleife greifen musste: Kurz bevor militärische Handlungen erfolgt wären, hätten Prüfer die KI-generierte Einschätzung überprüft und festgestellt, dass sie mit Hilfe von KI erstellt worden war und inhaltlich nicht belastbar genug wirkte. Damit wird eine zentrale Forderung aus der Sicherheits- und Einsatzdiskussion sichtbar: „human in the loop“ ersetzt nicht nur Ethik, sondern kann auch eine technische Schutzbarriere gegen fehlerhafte Modellintegration sein. Gordon Chang, Senior Fellow am Pacific Research Institute, wird mit der Aussage zitiert: „This story is alarming because there was bad intelligence, “ ergänzt um den Punkt, „The important story here, though, is that a human stopped it.“ Die Worte bringen die eigentliche Mechanik auf den Punkt: Nicht die Existenz von KI ist das Problem, sondern ob die Kette bis zur Umsetzung ohne ausreichende Plausibilitätsprüfungen durchläuft.
Die US-seitige Perspektive auf KI bleibt dennoch ambivalent, und sie ist in der Debatte über Geschwindigkeit und Entscheidungsdruck angelegt. Der Bericht verweist auf die Einschätzung von Retired U.S. Army General Wesley Clark, dass das Militär KI wegen der Geschwindigkeit der Informationslage nutzen müsse, aber dass menschliche Aufsicht weiterhin zwingend sei. Er wird mit den Sätzen zitiert: „He’s got to be there at the right point“ und „There’s no reason why we can’t keep a human in the loop on these sensitive AI matters.“ Zudem betont er, dass Anwender die Fähigkeiten und Grenzen des Systems sowie die Qualität der gespeisten Daten verstehen müssten. Damit verschiebt sich die Frage von „KI ja oder nein“ hin zu „Wie wird KI in Entscheidungsworkflows abgesichert?“ – etwa über Prüfregeln, Nachvollziehbarkeit der Eingangsquellen und definierte Stop-Kriterien bei widersprüchlichen Indikatoren.
Auch auf Regierungsebene wird das Thema als Umsetzungsfrage behandelt. Laut dem Bericht treibt Verteidigungsminister Pete Hegseth die schnellere Einführung entsprechender Technologien voran. Gleichzeitig macht der Fall deutlich, dass „Speed“ allein kein Qualitätsversprechen ist: Wenn ein Modell aus Open-Source-Hinweisen und Signaldaten eine konsistente Story synthetisiert, kann das Ergebnis für Menschen zunächst plausibel wirken – selbst wenn einzelne Bausteine falsch sind. In der Praxis rückt damit die Frage in den Vordergrund, wie KI-gestützte Systeme in der Lageerstellung getestet, überwacht und abgesichert werden: Welche Vertrauensmaße gelten, wie werden Abweichungen gegen unabhängige Sensorik oder alternative Quellen bewertet, und wer trägt Verantwortung, wenn ein Modell zwar sprachlich korrekt, aber faktisch danebenliegt?
Parallel dazu wird im Bericht die geopolitische Ebene der Standards adressiert. Ein Anwalt wird zitiert mit der Position, dass die USA Standards setzen sollten, damit die Welt „American AI“ statt chinesischer Modelle nutze. Gleichzeitig wird betont, dass KI-Vereinbarungen schwer durchsetzbar seien und dass Absprachen nicht zuverlässig eingehalten würden. Diese Argumentation ist zwar politisch, aber technisch anschlussfähig: Je stärker sich Systeme und Trainingsdaten in unterschiedlichen Jurisdiktionen und Ökosystemen unterscheiden, desto größer wird die Varianz in Verhalten, Risiken und Interoperabilität. Für Unternehmen und Entwickler ergibt sich daraus eine konkrete Implikation: KI-Modelle im Verteidigungs- oder sicherheitsnahen Umfeld werden künftig nicht nur an Leistungskennzahlen gemessen, sondern auch an Governance-Mechanismen, Auditierbarkeit und an der Fähigkeit, human-kontrollierte Freigaben zuverlässig zu unterstützen.
Unterm Strich zeigt der Bericht einen realen Engpass in KI-gestützten Entscheidungsprozessen: Die größten Gefahren entstehen nicht dort, wo KI „denkt“, sondern dort, wo KI-Ausgaben in operative Ketten integriert werden, bevor unabhängige Plausibilisierung abgeschlossen ist. Gleichzeitig liefert der geschilderte Stop-Punkt nach Angaben des Berichts ein positives Signal, dass Kontrollen funktionieren können – wenn sie früh genug greifen. Für die nächsten Schritte wird es daher weniger um Schlagworte gehen, sondern um harte Engineering-Details: klare Rollenverteilung zwischen Analyst, System und Prüfer, definierte Qualitätsgrenzen für Eingangsquellen sowie kontinuierliches Monitoring, das Fehlklassifikationen nicht erst nach einer potenziell kritischen Reaktion sichtbar macht.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "AI-Fehlmeldung im US-Militär: Bericht zeigt Risiken bei KI-gestützter Lageerstellung" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "AI-Fehlmeldung im US-Militär: Bericht zeigt Risiken bei KI-gestützter Lageerstellung" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »AI-Fehlmeldung im US-Militär: Bericht zeigt Risiken bei KI-gestützter Lageerstellung« bei Google Deutschland suchen, bei Bing oder Google News!