


LONDON (IT BOLTWISE) – LTT Labs hat untersucht, was lokale KI-Agenten mit 8, 12 und 16 GiB VRAM in der Praxis leisten. Als Basis diente der Agent Hermes mit LM Studio und verschiedenen Gemma-4-Varianten. Entscheidend war nicht nur die Token-Rate, sondern ob konkrete Workflows wie Web-Recherche, PDF-Erstellung oder Programmierung stabil funktionieren. Das Ergebnis: 8 GiB reichen für einfache Aufgaben, ab 12 beziehungsweise 16 GiB wird der Agent deutlich alltagstauglicher, bleibt aber auch dort nicht fehlerfrei.
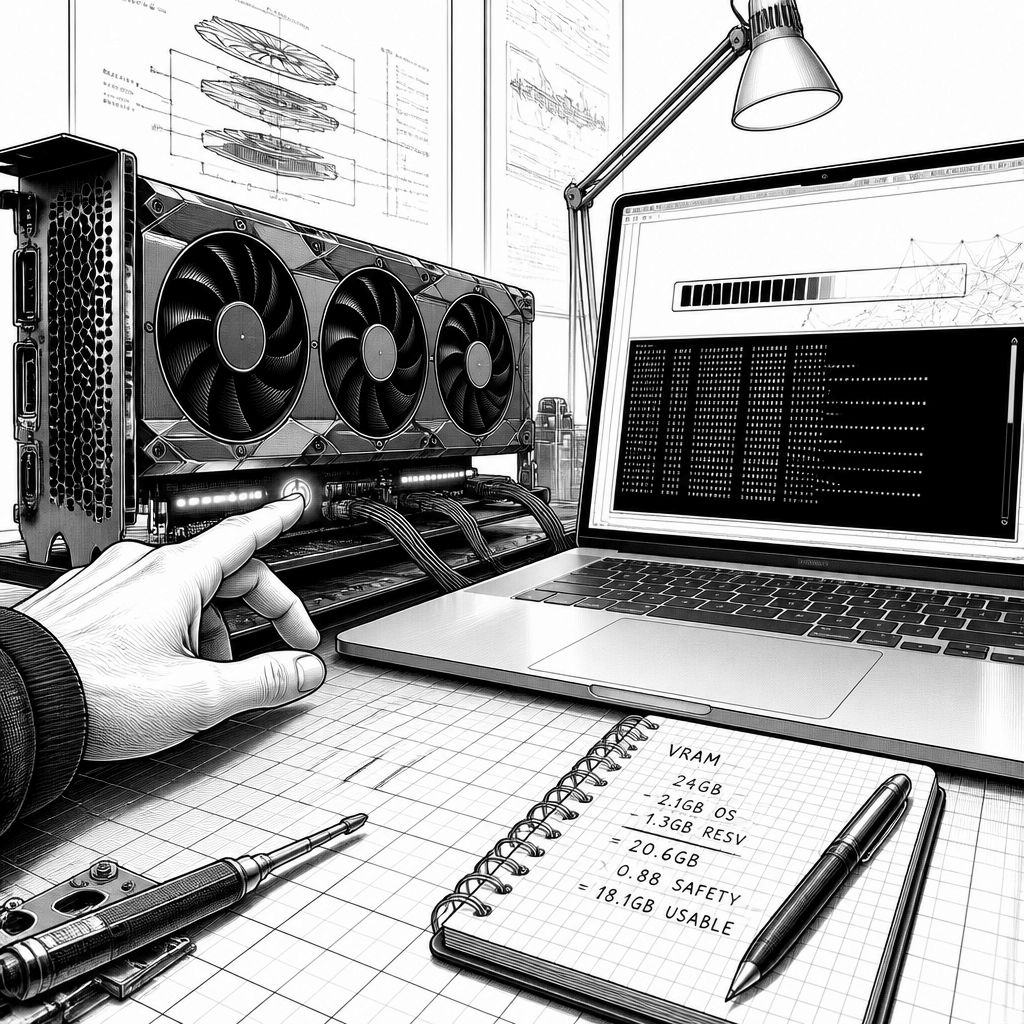
Wer lokale Künstliche Intelligenz auf einer Gaming-GPU einsetzen will, steht sehr schnell vor einer scheinbar einfachen Frage: Wie viel VRAM braucht der Agent wirklich? Genau hier setzt der Praxistest von LTT Labs an, der statt auf reine Durchsatzwerte auf die Erfolgsquote bei konkreten Aufgaben schaut. Als Agent diente Hermes, betrieben über LM Studio, wobei LTT Labs gezielt nur Karten aus NVIDIAs Blackwell-Generation nutzt. So lassen sich Speicherunterschiede zwischen den getesteten Ausstattungen vergleichen, ohne dass ein Sprung in der Architektur die Ergebnisse überlagert.
Technisch ist das Setup klar auf die VRAM-Grenze zugeschnitten. Die Modellvarianten sollten nach Angaben der Tester möglichst vollständig im Grafikspeicher liegen, denn ein Auslagern in den normalen Arbeitsspeicher reduziert die Geschwindigkeit spürbar. Als Plattform wurde ein Core Ultra 9 285K mit 32 GiB DDR5-6800 verwendet. Getestet wurden drei konkrete Konfigurationen: eine GeForce RTX 5060 mit 8 GiB, eine GeForce RTX 5060 Ti mit 16 GiB sowie eine GeForce RTX 5070 mit 12 GiB. In allen Fällen blieb der Kontextrahmen bei anspruchsvolleren Szenarien auf großen Fenstern, konkret wird ein Kontext von 131.072 Token verwendet, was die Speicherlast deutlich erhöht.
Die 8-GiB-Stufe zeigt sehr deutlich, wo die Grenze in der Praxis verläuft. Für die RTX 5060 mit 8 GiB musste LTT Labs auf Gemma 4 E2B in Q8_0-Quantisierung zurückgreifen, weil sich eine größere E4B-Variante trotz noch stärkerer Q4-Quantisierung nicht sinnvoll im Speicher unterbringen ließ. Selbst wenn der Agent theoretisch mit dem Kontext arbeiten kann, entscheidet bei solchen Grenzen letztlich, ob die Modellgröße und das Kontextfenster gleichzeitig in den VRAM passen. Im Test funktionierte dann zwar ein einfacher Rezept-Workflow samt Websuche noch zuverlässig, bei einer umfangreicheren Recherche zu steigenden RAM- und SSD-Preisen dagegen scheiterte das Modell mehrfach: Das geforderte PDF wurde nicht erstellt, außerdem traten bei Programmieraufgaben Fehler auf, die der Agent trotz mehrerer Versuche nicht sauber korrigierte.
Mit 12 GiB VRAM verschiebt sich das Bild spürbar. Laut LTT Labs ließ sich Gemma 4 E4B in Q6_K einsetzen, und damit konnte der Agent mehrere Schritte am Stück abarbeiten, darunter die Einführung mit dauerhaftem Kontext, eine umfangreichere Recherche sowie eine komplexere Programmieraufgabe. Auch bei typischen „Noisy Real-World“-Aufgaben wie der Einrichtung eines Plex-Servers klappte es im Test. Allerdings blieb das System nicht stabil über alle Workflows: Probleme gab es weiterhin beim kleineren FFmpeg-Projekt, bei der E-Mail-Automatisierung sowie beim Teilen der Home-Assistant-Integration. Genau an dieser Stelle wird der Unterschied zwischen „lokal starten“ und „lokal zuverlässig delegieren“ sichtbar.
Die 16-GiB-Konfiguration lieferte im Ergebnis die vollsten Resultate. Die RTX 5060 Ti mit 16 GiB VRAM ermöglichte Gemma 4 E4B mit Q8_0 und ebenfalls 131.072 Token Kontext. In der Praxis klappte damit Plex und Home Assistant; die Recherche wurde erfolgreich abgeschlossen, und auch eine umfangreichere Programmieraufgabe gelang. Gleichzeitig galt aber: Selbst mit 16 GiB arbeitete der Agent nicht fehlerfrei. Beim erzeugten FFmpeg-Skript wurden nicht alle Anforderungen erfüllt, und beim Durchsuchen sowie Zusammenfassen von E-Mails traten erneut Schwächen auf. LTT Labs führt das daher nicht ausschließlich auf die reine VRAM-Kapazität zurück, sondern nennt als Einflussfaktoren auch Modellwahl, Quantisierung, Agenten-Software und Prompt-Design.
Für die Einordnung in den Markt bedeutet das: Mehr VRAM ist kein Garant für perfekte Ergebnisse, aber ein echter Hebel für den Spielraum bei Modellgröße und Kontextfenster. Der Test zeigt weniger eine fixe Mindestanforderung, eher eine Abstufung. 8 GiB sind demnach realistisch für das Ausprobieren lokaler KI oder eng begrenzte Aufgaben, bei denen der Kontext und die Aufgabenkomplexität nicht ausufern. 12 GiB erlauben schon deutlich größere Modelle und komplexere Abläufe, und 16 GiB holen in vielen Szenarien „mehr Arbeit pro Prompt“ heraus. Wer bereits eine 8-GiB-GPU besitzt, kann die Technologie also sinnvoll evaluieren; produktiv interessant wird es in den Ergebnissen aber eher ab 12 beziehungsweise 16 GiB.
Ein weiterer Punkt ist die Rolle von Arbeitsspeicher-„Backfilling“: Anwendungen auf Basis von llama.cpp, darunter LM Studio und Ollama, können Teile eines Modells in den RAM auslagern. Damit lässt sich die VRAM-Grenze technisch überschreiten, etwa für größere Modelle oder breitere Kontextfenster. Allerdings bezahlen Nutzer diesen Komfort laut den Testergebnissen mit einer deutlich geringeren Geschwindigkeit, weil DDR-Speicher im Zugriff langsamer ist als der Grafikspeicher. Das macht den praktischen Nutzen solcher Hybrid-Setups vom Ziel abhängig: Für gelegentliche Tests oder Experimente ist Auslagern attraktiv, für einen flüssigen Agentenbetrieb bleibt die VRAM-Kapazität trotzdem der zentral limitierende Faktor. Und genau deshalb ist die konkrete Ergebnisstreuung zwischen 8, 12 und 16 GiB für Entscheider relevant: Sie bestimmt nicht nur, ob ein Modell läuft, sondern ob der Agent Workflows in der gewünschten Qualität durchzieht.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "8, 12 oder 16 GiB VRAM: Wie gut lokale KI-Agenten wirklich laufen" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "8, 12 oder 16 GiB VRAM: Wie gut lokale KI-Agenten wirklich laufen" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »8, 12 oder 16 GiB VRAM: Wie gut lokale KI-Agenten wirklich laufen« bei Google Deutschland suchen, bei Bing oder Google News!