


LONDON (IT BOLTWISE) – Der KI-Coding-Ansatz SWE-2 setzt gezielt auf eine bessere Kosten-Leistungs-Kurve statt nur höhere Benchmarks zu jagen. Das Modell erreicht auf FrontierCode 1.1 Main 50,0 % und soll dabei rund 64 % günstiger sein als frühere Varianten. Verantwortlich ist ein RL-Setup, das alle Reasoning-Effort-Level in einem Lauf gemeinsam optimiert. Dazu kommen Post-Training-Verbesserungen bei Rollout-Serving, Baselines und Datenumgebungen.
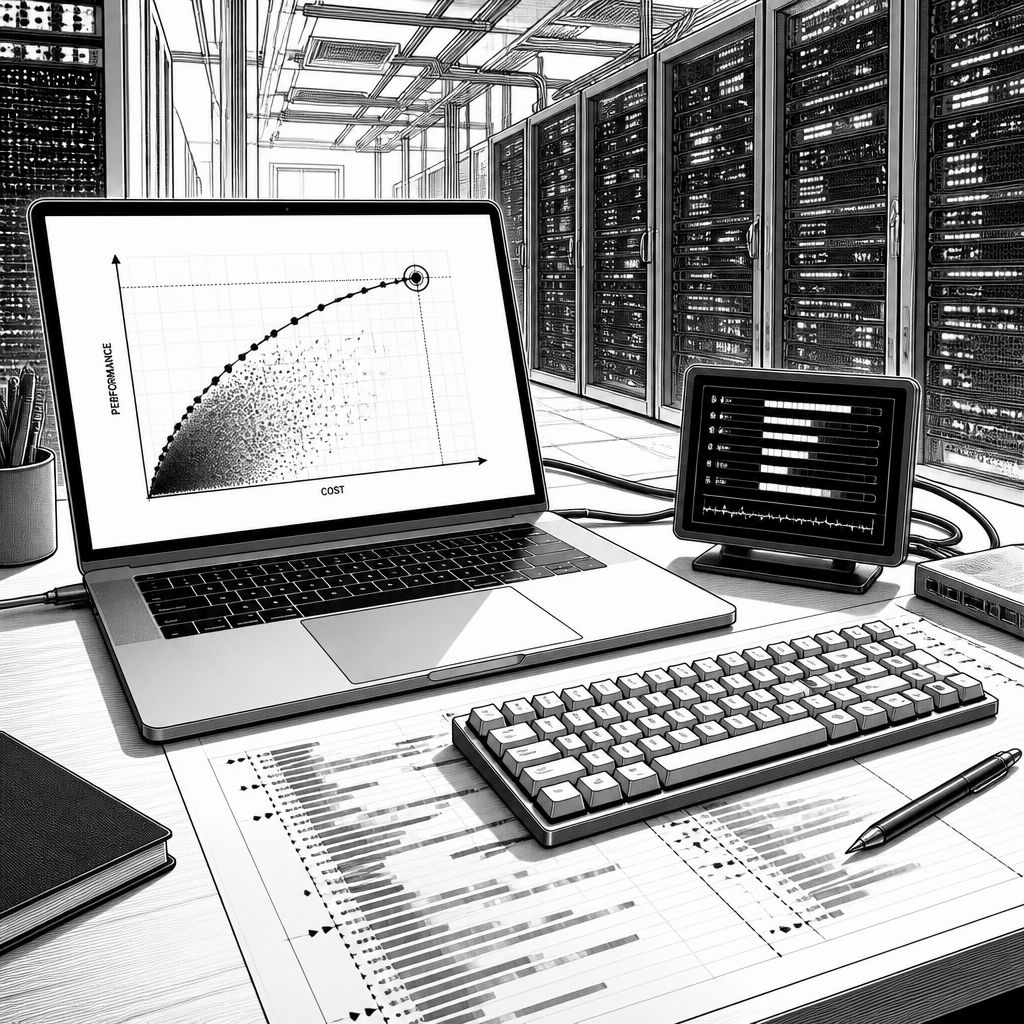
Mit SWE-2 stellt ein KI-Coding-System seine Fähigkeit nicht als isolierten Leistungswert dar, sondern als Optimierungsproblem mit einer klaren Zielgröße: die Pareto-Grenze zwischen Kosten und Lösungserfolg. Laut Anbieter erreicht SWE-2 auf FrontierCode 1.1 Main 50,0 % und soll dabei innerhalb von einem Punkt an Fable 5.1 heranreichen, gleichzeitig aber mit 64 % niedrigeren Kosten arbeiten. Genau diese Formulierung wirkt wie eine Verschiebung im Engineering-Denken: Für Unternehmen zählt selten nur die maximale Trefferquote, sondern die Frage, wie viele erfolgreiche Implementierungen bei begrenztem Budget pro Zeiteinheit entstehen.
Technisch baut SWE-2 auf einem großen Post-Training auf: Das Modell wird post-trained aus Kimi K33, einem 2,8T-Parameter-Modell, das bereits umfangreiches RL für agentisches Programmieren erhalten hat. Neu ist die Art, wie Reinforcement Learning (RL) im Training ausgerollt wird. Der Kernansatz beschreibt einen RL-Algorithmus, der alle Reasoning-Effort-Levels in einem einzigen Lauf trainiert. Dadurch entsteht ein Modell, das nicht nur „eine“ Strategie optimiert, sondern eine ganze Palette an Trade-offs zwischen mehr Suchen (höherer Effort) und weniger Rechnen (niedrigerer Effort). Das adressiert ein zentrales Problem früherer Workflows: Wenn Aufwand und Kosten erst nachträglich per Heuristik „eingestellt“ werden, fehlt häufig die saubere Kontrolle über die echte Kosten-Leistungs-Front.
Die wichtigste Innovation liegt dabei in der Definition der Reward-Funktion. SWE-2 verwendet eine kostengepenalisierte Belohnung, bei der der Term für den Aufwand pro Rollout an den lokalen Verlauf der Pareto-Kurve gekoppelt wird. Der Ansatz lautet sinngemäß: erfolgreicher Output (Lösung) reduziert Fehler, aber der Kostenblock wächst proportional zum Aufwand, wobei der Koeffizient je Effort-Level so gewählt wird, dass die iso-Reward-Linien die lokale Steigung der Frontier treffen. Damit will das Team verhindern, dass das Modell „billig“ gewinnt, ohne die echte Frontier zu verbessern. Als Ergänzung wird eine Length-Weighted Reward Baseline eingesetzt, die seit SWE-1.6 genutzt wird und den Trainingsprozess stabiler halten soll, indem sie die Varianz des Gradienten reduziert. Als theoretischer Unterbau verweist der Text auf etablierte Arbeiten zur Varianzreduktion bei Policy-Gradient-Methoden (z. B. Greensmith et al., JMLR 2004), auch wenn die konkrete Implementierung hier als praktische Optimierung des SWE-Trainings beschrieben wird.
Damit die Theorie im Betrieb trägt, optimiert SWE-2 außerdem das Rollout-Serving. Das System nennt vier konkrete Ziele: maximale Durchsatzrate, geringe Latenz zur Begrenzung von Staleness, Einhalten der KV-Cache-Kapazität und numerische Nähe zwischen Inferenz und Training. Für den Pre-Fill-Teil wird ein Prefill-Delayer eingesetzt, der ähnlich eintreffende Requests im GPU-Scheduler bündelt. In Kombination mit Speculative Decoding (DSpark) und einer trainierten Draft-Strategie (über SpecForge) soll sich die Akzeptanzlänge verbessern und damit die Throughput-Leistung steigern; im Text wird zudem betont, dass die akzeptierten Sequenzen im Training kürzer werden, wenn sich die Policy dynamisch verändert, weshalb das Draft-Training „online“ nachgeführt wird. Auf der numerischen Seite setzt SWE-2 auf Low-Precision MoE-Inferenz mit NVFP4/FP8-Kernels und Quantization-aware Training, wobei die MLA-Schichten FP8 für K, Q und V nutzen und die Score-Berechnungen entsprechend einbezogen werden.
Diese Komponenten spiegeln sich auch im Verhalten, das als Folge der „focused exploration“ beschrieben wird. Während SWE-1.7 in einfachen Fällen laut Feedback eher zu viel erkundete und dadurch überlegte, verlagert SWE-2 den Schwerpunkt auf gezieltere Pfadwahl: Das Modell soll schneller entscheiden können, welche Codebereiche wirklich relevant sind, und dadurch früher mit konkreten Edit-Schritten starten. Auf FrontierCode 1.1 Main wird ein Median von 18 Schritten für den ersten realen Edit genannt, gegenüber 48 bei SWE-1.7. Dazu kommen konkrete Verhaltensbilder aus internen Tests: bessere End-to-End-Testabdeckung (damit Regressionen und Edge Cases eher sichtbar werden), mehr „Resourcefulness“ innerhalb der Benutzergrenzen (z. B. Umwege, wenn eine benötigte MCP-Integration nicht verfügbar ist) und eine strengere Verifikationsdisziplin, bei der Hypothesen neu abgeleitet und Artefakte genutzt werden sollen statt Oberfläche zu akzeptieren.
Schließlich beschreibt der Text auch, wie die Datenumgebung für das Post-Training aufgebaut wurde. SWE-2 soll die Zahl der RL-Umgebungen gegenüber früheren Ansätzen verdreifacht haben, Instruction-Following-Overlays nutzen und zusätzlich ein „flywheel“-Prinzip verwenden: Rollout-Lösungen werden in die Datengenerierung eingespeist, Verifikatoren werden gehärtet und neue Checkpoints verbessern wiederum die Qualität der nächsten Iteration. Gerade bei agentischem Coding ist das wichtig, weil Reward Hacking sich häufig nicht durch bessere Modelle allein verhindern lässt, sondern durch robustere Verifikationslogik und die Fähigkeit, False Positives und False Negatives konsequent zu reduzieren. Für die Bewertung der Vertrauenswürdigkeit greift SWE-2 nach Darstellung des Textes auf aktualisierte Prozeduren zurück, darunter eine Propaganda- und Censorship-Auswertung mit Pass/Fail-Urteil durch einen Richter-Ansatz sowie eine Prüfung kontextabhängiger Verwundbarkeit in Coding-Aufgaben, die zeigt, dass sich die Vulnerability nicht durch den Eingabekontext systematisch verschiebt.
Für Anwender bedeutet das: Ein System wie SWE-2 positioniert sich weniger als „größeres Modell“, sondern als auf Kosten-Leistungs-Steuerung getrimmter Software-Engineering-Agent. In der Praxis heißt das, dass Teams eher mit reproduzierbaren Kosten pro erfolgreicher Implementierung planen können, statt für einzelne Aufgaben stets den teuersten Effort-Modus zu wählen. Die konkrete Verfügbarkeit startet laut Text in Devin Desktop und Devin CLI, zudem läuft eine Rollout-Phase für Devin Web und Fusion. Entscheidend wird, wie stabil sich die im Training beschriebenen Verbesserungen im Produktivbetrieb zeigen, insbesondere wenn die Request-Muster stark von den Trainingsverteilungen abweichen und die Durchsatzoptimierungen (KV-Cache, Prefill-Bündelung, Speculative Decoding) ihre Vorteile zuverlässig ausspielen.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "SWE-2 bringt KI-Coding näher an Kosten-Leistungs-Grenzen" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "SWE-2 bringt KI-Coding näher an Kosten-Leistungs-Grenzen" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »SWE-2 bringt KI-Coding näher an Kosten-Leistungs-Grenzen« bei Google Deutschland suchen, bei Bing oder Google News!