


LONDON (IT BOLTWISE) – Die Partnerschaft verlagert den KI-Engpass von den Trainingschips auf das Netzwerk zwischen den GPUs. Statt Kupfer und Legacy-Switches sollen optische Verbindungen den Energie- und Zeitaufwand beim Daten-Shuffling senken. Für Unternehmen ändert sich damit die Kalkulation der KI-Operating-Costs spürbar. Entscheidend wird, wer das effizienteste Fabric zu Premium-Margen vermarkten kann.
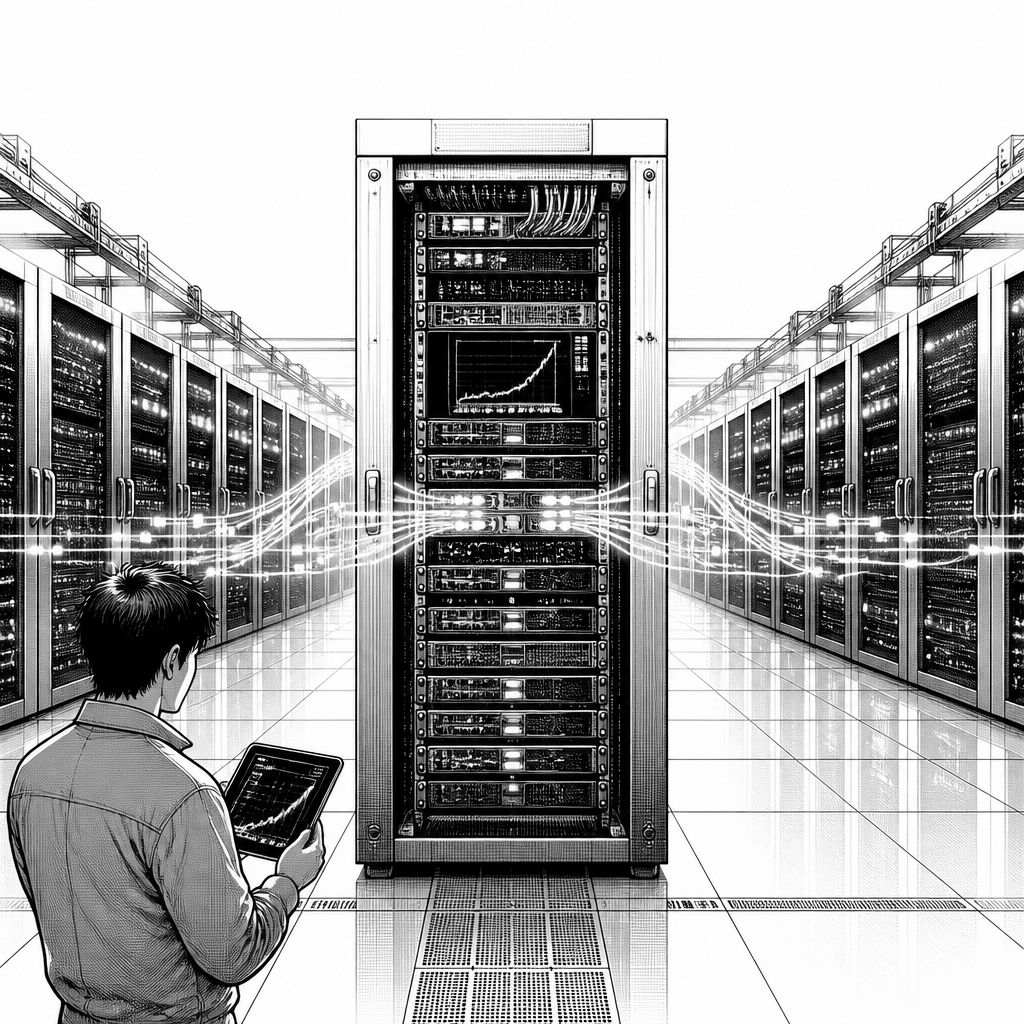
Wer Künstliche Intelligenz (KI) nur als GPU-Thema betrachtet, greift oft zu kurz. Genau hier setzt die aktuelle Cisco-NVIDIA-Argumentation an: Bei großen Trainingsläufen skaliert die Rechenleistung schneller als die Fähigkeit, Datenpakete zwischen den Chips ohne Verzögerung zu bewegen. Das Ergebnis ist ein klassischer Flaschenhals-Effekt im Rechenzentrum, bei dem das „Hin-und-Her“ der Daten zum dominierenden Kosten- und Latenztreiber wird. Damit rückt nicht das Silizium selbst in den Mittelpunkt, sondern die Infrastruktur, die es im Betrieb zusammenhält.
Technisch betrachtet entsteht der Engpass aus dem Zusammenspiel von Parallelisierung und Kommunikation. Wenn ein Modelltraining von einigen Tausend auf Hunderttausende GPUs wächst, werden Parameter-Updates, Gradienten und Aktivierungsdaten nicht nur einmal, sondern ständig zwischen Nodes ausgetauscht. Diese Kommunikationslast verursacht laut der zugrunde liegenden Argumentationslinie mehr Energie und Zeit als die eigentlichen Rechenoperationen, vor allem dann, wenn die Datenwege über Kupferverkabelung und langsamere, weniger energieeffiziente Switch-Generationen laufen. Die neue optische Plattform, die auf NVIDIA-Silizium basiert, adressiert genau diese „Steuer“: Sie soll die Transportstrecke durch schnellere, energieeffizientere Lichtverbindungen ersetzen, damit die Auslastung der Recheneinheiten nicht durch Netzwerkwartezeiten ausgebremst wird.
Ein weiterer Punkt kommt in der Darstellung besonders deutlich durch: Ein KI-Agent arbeitet nicht in „menschlichen Denkpausen“. Er stellt fortlaufend Anfragen, verarbeitet Ergebnisse und triggert damit wiederum Kommunikation im Fabric. Dadurch verändert sich die Wirtschaftlichkeitsrechnung für Betreiber. Während einzelne Nutzergruppen mit wenigen Sessions ein Fabric häufig „sättigen“ können, kann eine Flotte aus Agents für dieselbe Aufgabe die Bandbreitenanforderung um ein Vielfaches steigern. Unternehmen, die diese Lastbewegung unterschätzen und ihr Netzwerk wie austauschbare Commodity behandeln, riskieren eine schleichende Reduktion der effektiven GPU-Auslastung – selbst wenn die Modellgröße und die GPU-Anzahl steigen.
In der Praxis verschiebt sich damit der Fokus im KI-Budget vom reinen CAPEX für Beschleuniger hin zu einem breiteren Stack aus Stromversorgung, Kühlung und Netzwerk. Die Kernaussage lautet: KI-Infrastrukturkosten lassen sich nicht mehr auf „nur GPUs“ reduzieren, weil das Zusammenspiel aus Energieprofil und Datenpfaden immer stärker über die tatsächlich nutzbare Rechenzeit entscheidet. Genau deshalb wird die Netzwerkebene in der Argumentation zur strategischen Komponente. Wer sie als Engpass erkennt, gewinnt eine neue Art von Hebelwirkung – nicht nur im Design der Datenpfade, sondern auch in der Frage, welche Schicht später die Preismacht und damit die Margen trägt. Für Kapitalallokatoren ist das Signal entsprechend eindeutig: Der Engpass verlagert sich vom Trainingstakt der Chips auf das Geflecht, das die Chips miteinander verbindet.
Für den Markt bedeutet diese Sichtweise zudem einen Perspektivwechsel in der Bewertung von Lösungen. NVIDIA argumentiert dabei indirekt für eine durchgängige Auslastung seiner GPUs, weil bessere Kommunikationswege die Wartezeiten reduzieren. Cisco positioniert das Netzwerk und insbesondere die optische Transporttechnik als Teil einer „End-to-End“-KI-Infrastruktur, die nicht nur Integrationskosten senkt, sondern auch die Grundlage für skalierbare Performanz liefert. Das Muster passt zu einem breiteren Branchentrend: Sobald ein Engpass technologisch „billiger“ wird, rückt der nächste Abschnitt der Systemkette in den Vordergrund – zuletzt etwa bei Speichern (I/O) oder bei der Datentransport-Pipeline (Preprocessing). In dieser Logik ist es konsistent, dass jetzt das Fabric zwischen den Beschleunigern stärker diskutiert wird.
Für Unternehmen, die Künstliche Intelligenz produktiv einsetzen, folgt daraus eine klare Konsequenz in der Planung: Lasttests dürfen nicht bei der GPU-Auslastung enden. Sie müssen messen, wie viel Zeit in Kommunikation und Netzwerkwarteschlangen verloren geht, und wie sich das auf die effektive Trainings- oder Inferenzdurchsatzrate auswirkt. Ebenso wichtig ist die Frage, welche Erweiterungskonzepte zukünftige Agentenflotten und deren konstante Anfragefrequenz realistisch abbilden. Wer das Netzwerk als Engpass früh behandelt, kann die Operating Margin stabiler machen, weil zusätzliche GPUs nicht automatisch zu besserer Performance führen, wenn die Datenwege das System ausbremsen. Genau so wird aus der „Bandbreite statt Chips“-These eine konkrete Entscheidungsgrundlage für Architektur, Budget und Vendor-Strategie.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Cisco und NVIDIA: Warum KI weniger Chips braucht – und mehr Bandbreite" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Cisco und NVIDIA: Warum KI weniger Chips braucht – und mehr Bandbreite" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Cisco und NVIDIA: Warum KI weniger Chips braucht – und mehr Bandbreite« bei Google Deutschland suchen, bei Bing oder Google News!