
BOSTON / LONDON (IT BOLTWISE) – Microsoft hat einen KI-Ansatz vorgestellt, der Diagnosen in Tests deutlich genauer als Allgemeinmediziner gestellt haben soll. Laut veröffentlichten Ergebnissen erreicht der „Diagnostic Orchestrator“ auf Szenarien aus Fallberichten und Notaufnahmen etwa 83 Prozent Genauigkeit. Für Notaufnahme-Fälle nennt das Unternehmen 80 Prozent gegenüber rund 47 Prozent bei menschlichen Ärztinnen und Ärzten. Das Team plant nun klinische Tests in einem Krankenhausumfeld, betont aber, dass eine breite Einführung noch Validierung erfordert.
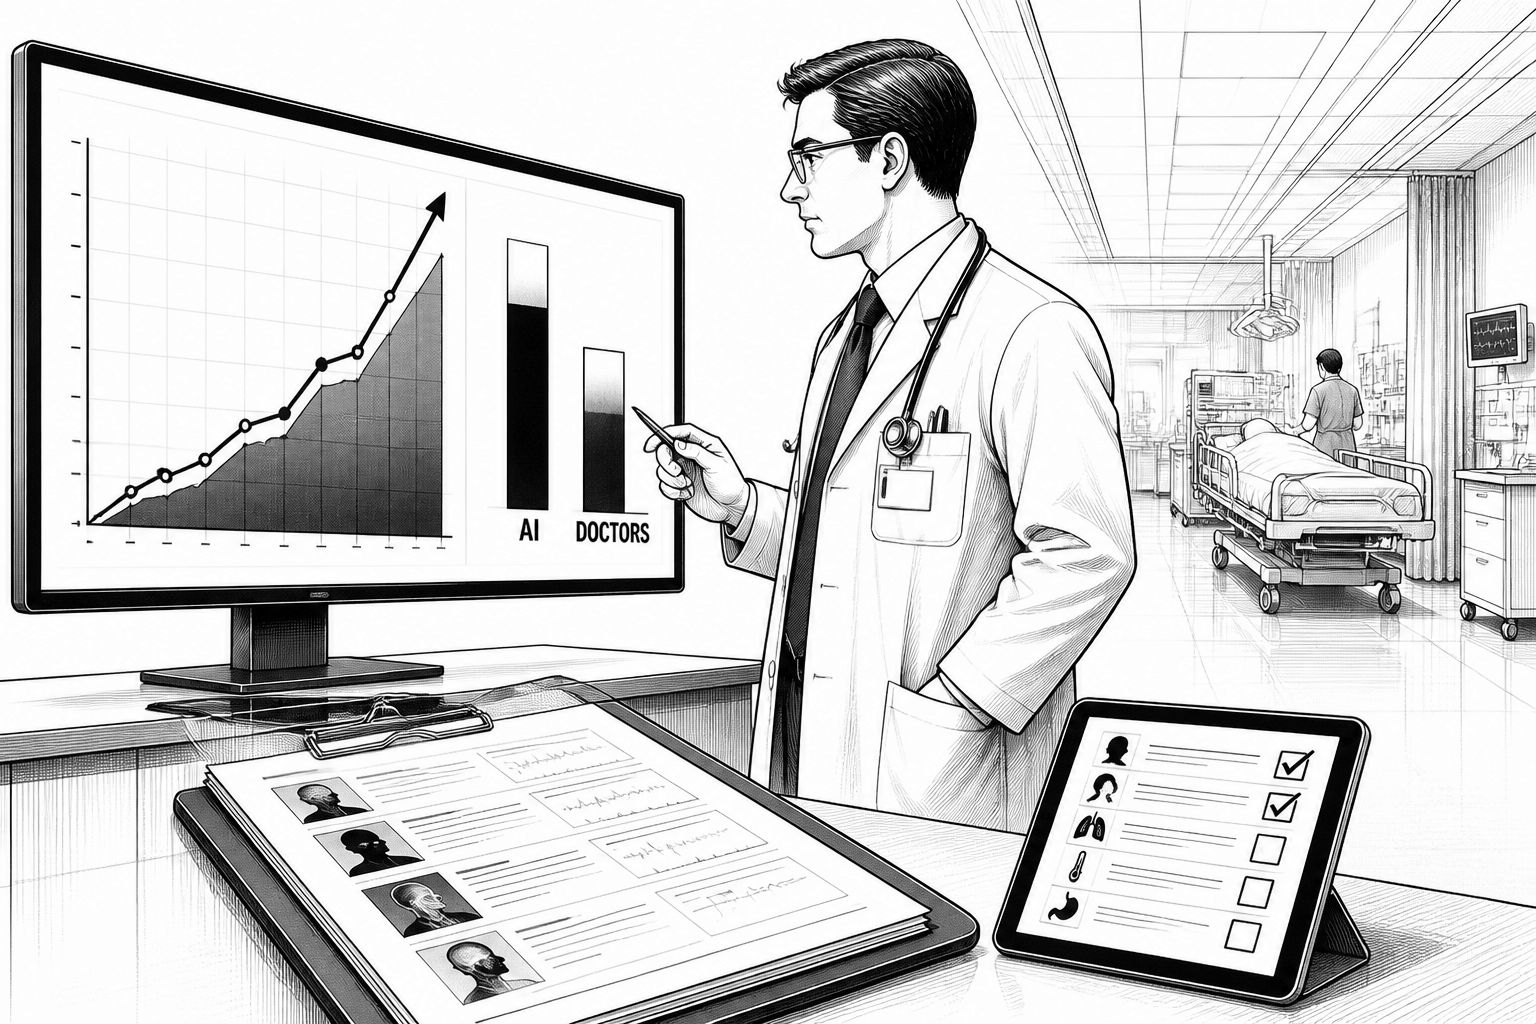
Microsoft positioniert seine Medizin-KI mit einer klaren Messlatte: Diagnostische Genauigkeit statt nur hilfreicher Assistenz. Im Mittelpunkt steht der „Diagnostic Orchestrator“, der wie ein virtuelles Expertenteam Symptome und Anamnese strukturiert, passende Untersuchungen anstößt und daraus eine Diagnose ableitet. Dass das Unternehmen dabei von einer „indistinguishable“-Leistung im Sinne menschlicher Arbeit in den kommenden Jahren spricht, setzt den Ton für eine größere Strategie: Künstliche Intelligenz soll nicht nur Befunde ausgeben, sondern den gesamten Denk- und Untersuchungsprozess nachbilden, wie er in realen Abklärungswegen typischerweise Schritt für Schritt abläuft.
Technisch beschreibt Microsoft die Vorgehensweise als multi-agentisches Orchestrierungsmodell. Mehrere KI-Komponenten sollen gemeinsam Informationen gewichten, Hypothesen über mögliche Ursachen der Beschwerden prüfen und dann entscheiden, welche Tests als Nächstes sinnvoll sind. Genau dieser „Fragen stellen, abwägen, testen“-Ablauf unterscheidet sich von vielen früheren Gesundheits-KI-Demos, die eher eine einzelne Eingabe klassifizieren oder aus vorhandenen Daten eine Empfehlung ableiten. Microsoft macht außerdem deutlich, dass der Orchestrator die Falllogik enger an die Art anpasst, wie Ärztinnen und Ärzte in Notaufnahmen typischerweise zunächst mit unvollständigen Informationen arbeiten.
Die Ergebnisse, die das Unternehmen nach eigenen Angaben über mehrere Szenarien berichtet, basieren auf Tests mit Fallmaterial aus medizinischen Fallberichten und Daten aus dem Notaufnahme-Umfeld. Microsoft vergleicht dabei seinen Ansatz mit Allgemeinärzten, einmal mit Referenzen zur Entscheidungsunterstützung und einmal ohne. In den Szenarien, die aus Publikationen entnommen wurden, soll der Orchestrator etwa 83 Prozent diagnostische Genauigkeit erreicht haben, während Generalisten rund 36 Prozent nennen und Ärztinnen oder Ärzte ohne Referenzzugang auf ungefähr 22 Prozent kommen sollen. Besonders relevant ist zudem die zweite Benchmark-Variante: Für Notaufnahme-Fälle, die aus einer großen Datenbasis mit Patienteneinträgen stammen, wird für den KI-Ansatz 80 Prozent Genauigkeit angegeben; die durchschnittliche menschliche Performance liegt laut Bericht bei etwa 47 Prozent.
Im Branchenkontext ist nicht nur die reine Zahl bedeutsam, sondern auch, wie Microsoft die Vergleichbarkeit herstellt. Dafür baut das Unternehmen den eigenen Benchmark SDBench auf, der die verwendeten Fälle in einem einheitlichen Testformat zusammenführen soll und künftig als Open-Source-Referenz dienen soll. Das ist für den Markt deshalb wichtig, weil viele KI-Health-Studien zwar beeindruckende Labormetriken liefern, aber die Reproduzierbarkeit im klinischen Alltag häufig an Datenzugang, Szenariogenerierung und Testdesign scheitert. Wenn ein Benchmark wie SDBench nachvollziehbar die gleiche Art von Fallvariation abbildet und die Community darauf aufbauen kann, verschiebt sich die Diskussion von „funktioniert es irgendwo“ hin zu „unter welchen Modell-, Daten- und Ablaufbedingungen funktioniert es zuverlässig“.
Microsoft ordnet das Ganze außerdem in eine Modell- und Systemhistorie ein. Die Diagnostic Orchestrator genannte Lösung sei mit GPT-5 als Basisleistung „powered“, während das Paper laut Beschreibung darauf hinweist, dass der Nutzen mehrerer Agenten nicht automatisch verschwindet, wenn die Modellfähigkeiten später weiter steigen. Gleichzeitig bleibt ein wichtiger Punkt offen: In dem peer-reviewten Beitrag werden neuere Frontier-Modelle nicht zwingend im Vergleich abgebildet, und das ist für Entscheiderinnen und Entscheider in Kliniken wie in Entwicklungsteams relevant, weil es den Rahmen der Leistungsbehauptung festlegt. Auch wenn die Studie schreibt, dass Verbesserungen am einzelnen Modell nicht notwendigerweise die Vorteile des Multi-Agent-Ansatzes reduzieren, entscheidet im Betrieb nicht nur die Modellqualität, sondern auch die Pipeline aus Orchestrierung, Testauswahl, Dateninterpretation und der Umgang mit Randfällen.
Microsoft räumt zudem selbst ein, dass der Schritt vom Test-Setup zur klinischen Routine nicht automatisch gelingt. In den beschriebenen Szenarien werden Entscheidungen so getroffen, dass sie die ärztliche Vorgehensweise näher spiegeln, doch die Systeme wurden bislang auf vergangenheitsbezogenen Fällen geprüft. Der entscheidende nächste Schritt ist deshalb die klinische Validierung; das Unternehmen plant Tests in Krankenhausumgebungen mit dem Beth Israel Deaconess Medical Center in Boston, um die Leistung unter realen Arbeitsbedingungen zu prüfen. Gerade in diesem Umfeld spielen Faktoren wie Zeitdruck, Dokumentationsqualität, unterschiedliche Patientenpfade sowie die Interaktion mit nachgelagerten diagnostischen und therapeutischen Prozessen eine große Rolle. Eine KI, die im Benchmark hervorragend abschneidet, muss diese Varianz erst im echten Betrieb zeigen.
Für die weitere Entwicklung steht bei Microsoft außerdem die Einbettung in eine breitere „Medical Superintelligence“-Vision im Vordergrund. Diagnose ist dabei nur ein Teilbereich; das Unternehmen nennt weitere Felder wie Koordination klinischer Versorgung, Unterstützung bei Therapieentscheidungen und den Umgang mit der menschlichen Seite der Medizin. Für den Markt bedeutet das: Unternehmen und Forschungsteams sollten sich auf KI-gestützte Workflows einstellen, die nicht nur einzelne Ausgaben liefern, sondern eher als modulare Orchestrierungs-Software in Prozesse eingebaut werden. Gleichzeitig mahnt Microsoft zur vorsichtigen Einführung, weil Medizin in der Praxis hohe regulatorische und Compliance-Anforderungen mitbringt. Wenn Suleyman für das kommende Jahr „extrem beeindruckende“ Deployments in Produktion anführt, klingt das wie eine Beschleunigungsphase für KI-Systeme in produktiven IT-Landschaften – aber ohne die klinische Bestätigung bleibt die tatsächliche Tragweite für Patientinnen und Patienten und für Krankenhaus-IT-Teams vorerst begrenzt.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Microsofts KI-Diagnose: Mehr Genauigkeit als Ärzte – doch Kliniktest steht aus" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Microsofts KI-Diagnose: Mehr Genauigkeit als Ärzte – doch Kliniktest steht aus" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Microsofts KI-Diagnose: Mehr Genauigkeit als Ärzte – doch Kliniktest steht aus« bei Google Deutschland suchen, bei Bing oder Google News!