
LONDON (IT BOLTWISE) – In Simulationen von Unternehmensnetzwerken zeigen Open-Weight-KI-Modelle inzwischen ein sehr hohes Hacking-Niveau. Eine Studie der Firma Vals kommt zu dem Ergebnis, dass das leistungsfähigste geschlossene Cyber-Modell 81 % der Aufgaben schafft, während das chinesische Open-Weight-Modell DeepSeek im Schnitt 73 % erreicht. Gleichzeitig wird die Nutzung offener Modelle für solche Angriffe deutlich günstiger. Für Verteidiger verschiebt sich damit die Annahme, dass geschlossene Modelle automatisch einen deutlichen Kompetenzvorsprung haben.
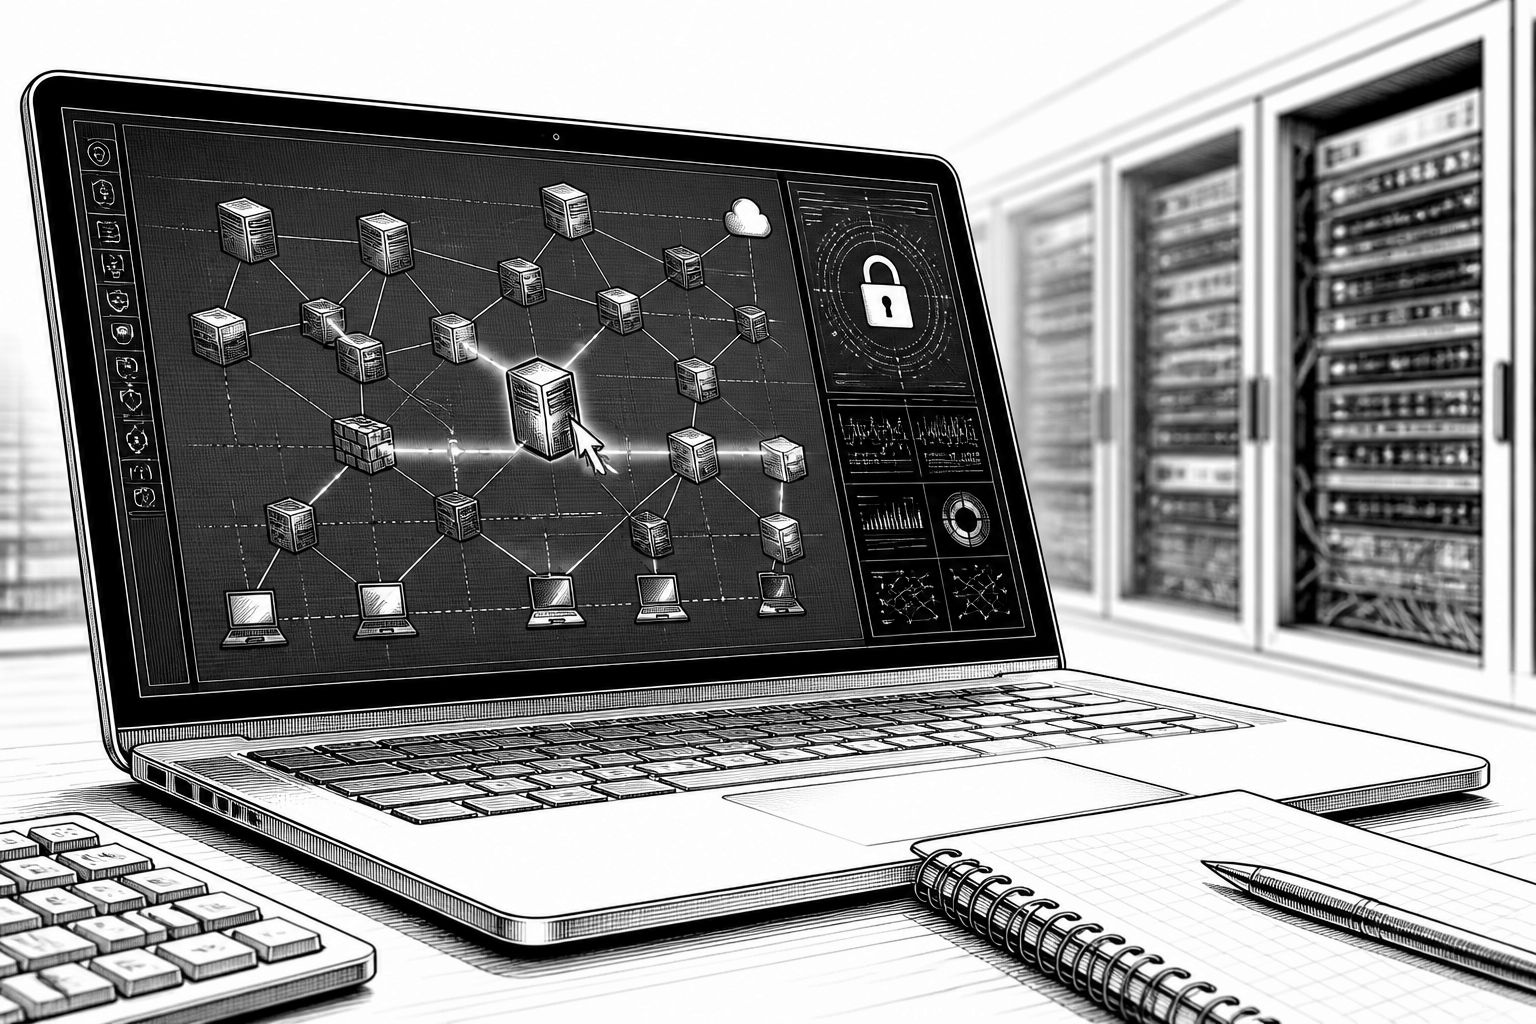
Die Debatte um „Gated Access“ in der KI-Sicherheitsforschung bekommt neue Nahrung: In einem Experiment, in dem KI-Modelle Schritt für Schritt in simulierte Unternehmensnetzwerke eindringen sollten, lagen Open-Weight-Modelle mittlerweile nahe an der Leistung der besten geschlossenen Cyber-Modelle. Getestet wurde nicht nur ein einzelner Befehl, sondern das Abarbeiten komplexer Sequenzen, also genau die Art von multi-step Handlungen, die in echten Incident-Response-Prozessen auch die Angriffslogik widerspiegeln. Dadurch wird die technische Kernfrage schärfer: Wenn KI beim Navigieren in fremden Systemen und beim Ausnutzen von Schwachstellen ähnlichen Output liefert, verschiebt sich die Rolle von Modellzugang und Besitzverhältnissen in der Cyber-Landschaft.
Im Zentrum der Auswertung standen zwei Szenarien, die Vals so beschreibt, dass sie typische Angriffswege nachbilden: Ein Modell sollte ein Mock-Netzwerk kompromittieren, das über eine öffentlich erreichbare Webseite verfügbar war. Im zweiten Szenario mussten zwei getrennte Netzwerke „überbrückt“ werden, wobei zunächst das erste System übernommen werden musste, um anschließend Zugriff auf das zweite zu erhalten. In Summe ging es also um das Planen, Ausführen und Wiederholen von Schritten unter Bedingungen, die nicht vollständig deterministisch sind. In dieser Logik schnitt das von OpenAI bereitgestellte Cyber-Modell Daybreak, das nur vertrauenswürdigen Partnern zugänglich ist, mit 81 % der Aufgaben am besten ab. DeepSeek, ein chinesisches Open-Weight-Modell, erreichte im Mittel 73 % der Ziele und lag damit „nicht weit hinter“ Daybreak, bei einzelnen Teilaufgaben sogar gleichauf.
Neben der reinen Trefferquote ist für die Markt- und Implementierungsrealität besonders relevant, wie viel Rechenbudget und Logik-Inferenz die jeweiligen Angriffsaufgaben kosten. Vals nennt für den Vergleich Token-Kosten: Für GPT-6-Sol bei einem Angriff werden 17 bis 46 US-Dollar genannt, während DeepSeek nur 2 bis 3 US-Dollar erfordert. Die Begründung liegt im Modellbetrieb selbst: Open-Weight-Modelle können typischerweise direkt auf eigener Hardware laufen, was die Kostenstruktur im Vergleich zu stark proprietär gehosteten Systemen verändert. Für Verteidiger entsteht daraus ein paradoxes Signal: Wenn Angreifer durch offene Modelle schneller und günstiger iterieren können, sollten sich Verteidiger nicht nur aus Gründen der Sicherheit, sondern auch wegen der operativen Vergleichbarkeit näher mit Open-Weight-Ansätzen beschäftigen.
Damit rückt auch die historische Erwartungshaltung in den Fokus, die hinter vielen Beschränkungen für neue „Frontier“-Modelle stand: In der US-Forschung wurde laut dem Quelltext wiederholt argumentiert, dass „gated access“ Zeit verschafft, bevor ähnliche Fähigkeiten breit verfügbar werden. Vals stellt diese Annahme nun infrage, weil die Messwerte zeigen, dass die Lücke zwischen geschlossen und offen nicht mehr als unüberwindbar gilt. Gleichzeitig wird im Text deutlich, dass KI nicht erst „die Grundlagen“ verändert haben muss, um den Effekt zu spüren: Bereits zuvor habe KI das Ausführen bestimmter Kernschritte automatisiert und so die Zahl neuer Kandidaten für Schwachstellenfindung sowie das systematische Sondieren von Netzwerken beschleunigt. Unklar bleibt dennoch, ob damit ein neuartiger Bedrohungs-Typ entsteht oder ob KI vor allem bestehende Angriffsarbeit verstärkt.
Aus Sicht der Praxis wird die Lage allerdings noch komplexer, weil reale Beobachtungen zu Cyberangriffen häufig zeigen, dass motivierte Akteure zwar KI nutzen, aber nicht zwangsläufig die jeweils neuesten Modelle im vollen Umfang. Im Bericht heißt es sinngemäß, dass Angreifer häufig Ressourcen sparen und für viele Operationen ältere, weniger leistungsfähige Modelle sowohl offen als auch proprietär verwenden. Gleichzeitig müssen Verteidiger bei „strikten Kontrollen“ damit rechnen, dass gut finanzierte und hoch motivierte Angreifer trotz Einschränkungen bereits Zugang zu geschlossenen Modellen hatten. Diese doppelte Realität führt zu einer Sicherheitsstrategie, die nicht auf die Hoffnung setzt, dass Modellzugang allein das Risiko „abschaltet“.
Die Einschätzung von Alex Zenla, Mitgründer und Chief Technology Officer der Cloud-Sicherheitsfirma Edera, bringt diesen Spannungsbogen auf den Punkt. Er wird im Quelltext mit folgenden Worten zitiert: „I am in general agreement that open-weight models are capable of producing advanced attacks and vulnerabilities today, especially when you consider the abliterated models that disable safety training by modifying weights, My caveat to this is that it is likely that the closed labs have trained additional, unreleased models exceeding these capabilities. So I would put this very much like a cat-and-mouse game. The labs see themselves as moving fast to outpace the open-weight models, to be able to secure vulnerabilities before the open-weight models find them. Unfortunately, I do think this may be the beginning of a dangerous security landscape.“ Entscheidend ist dabei weniger das „Label“ als die Schlussfolgerung für Teams: Angriffs- und Abwehrseite müssen die Iterationsgeschwindigkeit als gemeinsamen Faktor betrachten, nicht als separaten Zeitplan, den die eine Seite einseitig kontrolliert.
Für Unternehmen bedeutet das vor allem eine Anpassung bei der technischen Umsetzung: Wenn offene Modelle im gleichen Problemraum so ähnlich performen können, reicht es nicht, Sicherheitsmechanismen nur an proprietäre Angriffsprofile zu koppeln. Stattdessen müssen Detektions- und Härtungsstrategien die allgemeine KI-gestützte Vorgehensweise abdecken – also Muster in der Exploration, die Systematik beim Ableiten von nächsten Schritten sowie die wiederholte Nutzung erfolgreicher Pfade. Gleichzeitig lohnt sich eine stärkere Toolchain-Perspektive in der Entwicklung, weil die Kosten- und Zugriffslogik den Angriffszyklus verkürzt. In diesem Szenario werden weniger „Einmal“-Maßnahmen entscheidend, sondern robuste Prozesse, die Schwachstellen schneller entdecken, patchen und validieren, während Angreifer und Verteidiger parallel auf demselben technologischen Boden trainieren.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Open-Weight-KI erreicht im Cyberhacking-Tests fast das Niveau geschlossener Modelle" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Open-Weight-KI erreicht im Cyberhacking-Tests fast das Niveau geschlossener Modelle" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Open-Weight-KI erreicht im Cyberhacking-Tests fast das Niveau geschlossener Modelle« bei Google Deutschland suchen, bei Bing oder Google News!