
LONDON (IT BOLTWISE) – Ein KI-Agent kann bei falschen oder missbräuchlichen Anweisungen über seine Rollen hinaus handeln, weil Workflow-Orchestrierung, Identitäten und Tool-Verbindungen getrennt voneinander wirken. Ein bloßes „Stop“ per Prompt ist laut Sicherheitsleitfaden kein ausreichender Containment-Mechanismus. Stattdessen müssen Teams laufende und queued Runs stoppen, Berechtigungen widerrufen und Netzwerkpfade einschränken. Entscheidend ist die richtige Reihenfolge, damit weder andere Services ausfallen noch bereits gestartete Aktionen unbemerkt weiterlaufen.
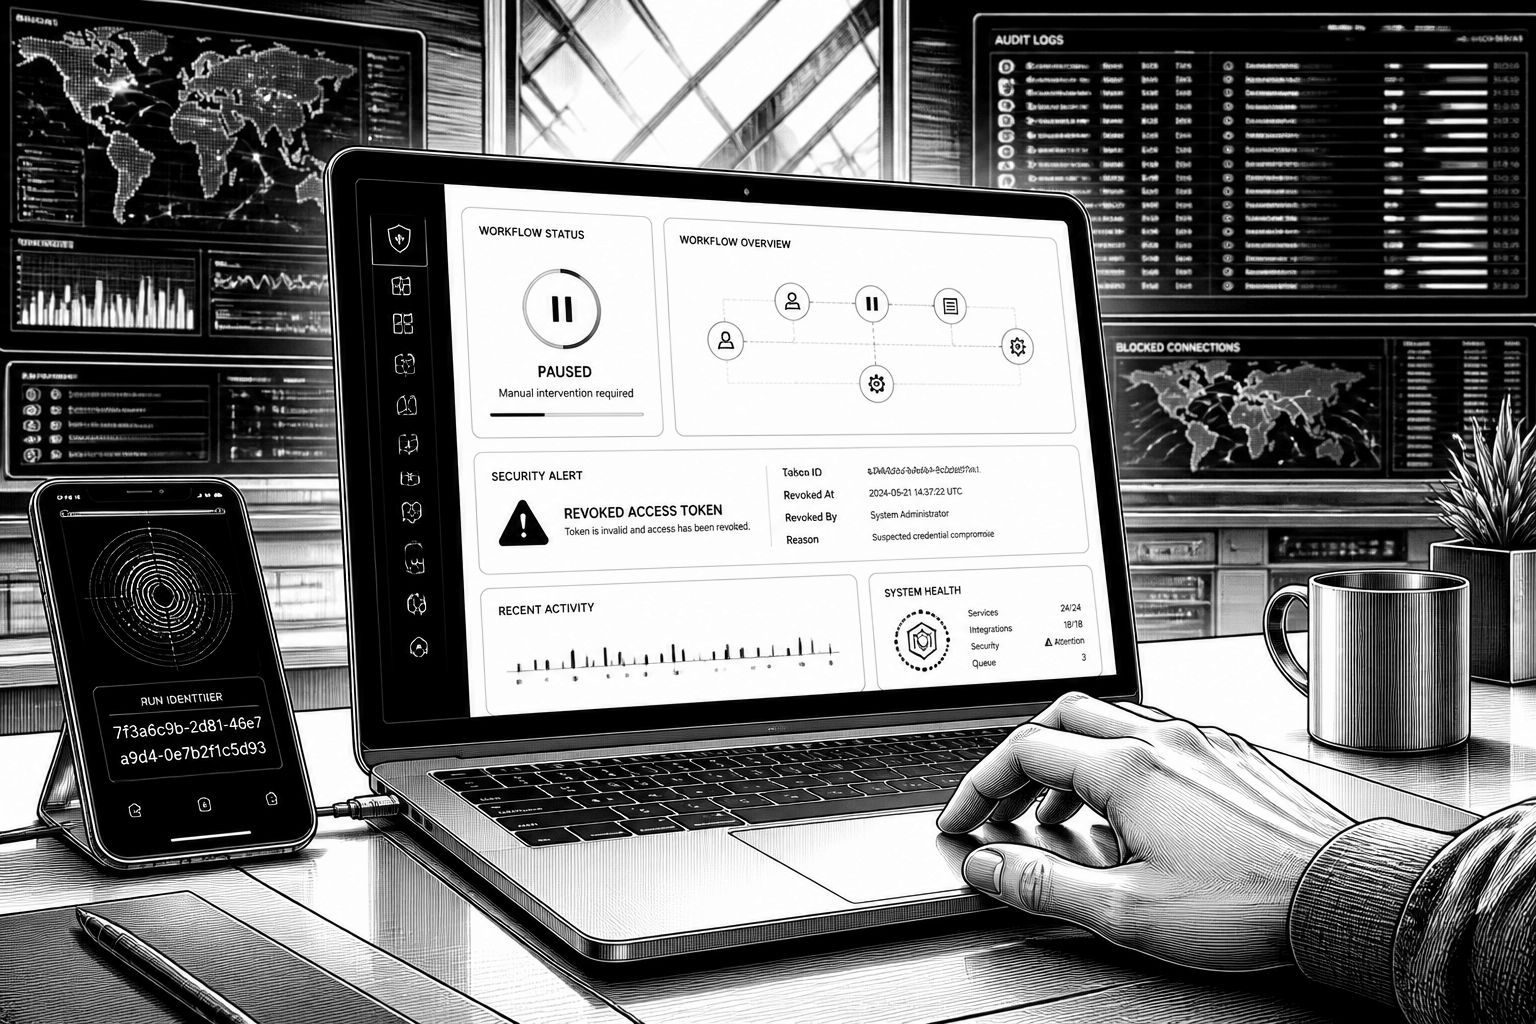
Die zentrale Unschärfe in vielen KI-Agenten-Setups lautet: Was genau bedeutet „den Agenten stoppen“? Im typischen Betrieb ist der Agent selten „der alleinige Ausführende“, sondern Teil eines größeren Systems aus Modell, Orchestrator, Identitätsmanagement und Tool-Integrationen. Wenn also etwa ein Agent Ticket-Inhalte sortiert und dabei Kontodaten recherchiert, kann eine einzige bösartige oder fehlerhafte Anweisung innerhalb des Tickets dazu führen, dass der Agent eine Export-Operation anstößt. Das funktioniert, weil seine Identität bereits Zugriff auf Datensätze hat und die angeschlossenen Tools bzw. APIs diese Aktion ausführen dürfen. Genau an dieser Stelle verschiebt sich die Frage von der KI-Modellebene hin zu den Kontrollschichten, die das Gesamtsystem „einsperren“ können.
Der Sicherheitsblick aus dem OWASP GenAI Security Project macht deshalb eine differenzierte Empfehlung: Containment müsse testen, ob es nicht nur Modell-Ausgaben, sondern auch Credentials und Netzwerkzugriff zuverlässig entzieht. Das ist besonders wichtig, weil „Stoppen des Modells“ in der Praxis nicht automatisch „Stoppen der Arbeit“ bedeutet. In vielen Architekturen entscheidet der Orchestrator über den Ablauf: Er übernimmt die Workflow-Steuerung, startet Retries, verarbeitet queued Jobs und führt Serviceaufrufe aus. Selbst wenn ein Model-Endpoint offline geht, kann ein separater Dienst bereits entgegengenommene Requests weiterbearbeiten. Ebenso kann das Zurückziehen eines einzelnen Tokens wirkungslos sein, wenn noch ein anderer Token, eine laufende Session oder eine bestehende Verbindung aktiv bleibt. „Kill switch“ ist damit eher ein Paket aus abgestimmten Kontrollen als ein einzelner Schalter.
Daraus folgt, dass ein Team nicht nur auf „unerwartetes Verhalten“ reagieren sollte, sondern früh die richtigen Signale erkennen muss, die auf eine zu breite Ausführung oder ein Fehlrouting hindeuten. Nicht jede auffällige Aktion ist automatisch ein Kompromittierungsindikator; geänderte Workflows, Softwarefehler, fehlerhafte Konfigurationen oder ungewöhnliche Eingaben können ebenfalls zu „suspicious“-Mustern führen. Ein näherer Blick ist aber angebracht, wenn der Agent Tools oder Ressourcen außerhalb des vorgesehenen Aufgabenrahmens aufruft, wenn er eine ungewöhnlich hohe Menge an Reads, Writes oder Exports erzeugt oder wenn ein Workflow nach dem vermeintlichen Pausieren weiterläuft. Ebenso sollten Logs Alarm auslösen, wenn der Agent Credentials oder Integrationen verwendet, die sein Besitzer nicht erwartet hat, oder wenn Identitäts-, Anwendungs- und Netzwerkaktivität nicht zum normalen Muster passt. Für die Ursachenanalyse helfen zwar die eigenen Agent-Logs, sie sind aber nur eine Evidenzquelle neben Identity-Provider-, API-, Applikations- und Netzwerkprotokollen.
Praktisch übersetzt sich das in eine strukturierte Response-Reihenfolge. Zuerst wird der betroffene Workflow pausiert: Der aktive Run wird gestoppt, und wo möglich werden Trigger, Retries oder die Queue suspendiert. Wichtig ist dabei der Hinweis, dass ein reiner Prompt an den Agenten zum „Stoppen“ keine Containment-Kontrolle ist; entscheidend ist, dass die Komponente, die den Workflow ausführt, die Kontrolle tatsächlich übernimmt. Danach folgt das gezielte Kappen von Zugriffswegen: Teams identifizieren die Credentials, Sessions, Grants und Service-Identitäten, die mit dem Run verbunden sind, und deaktivieren oder widerrufen die Teile, die nicht mehr als vertrauenswürdig gelten. Dabei gilt System-Realität: Tokens laufen nicht überall gleich ab. Manche verfallen schnell, andere bleiben gültig, bis die Session endet oder ein spezifischer Service sie invalidiert. Daher sollte das Team verifizieren, dass der betroffene Zugriff tatsächlich „nicht mehr nutzbar“ ist – statt sich auf das bloße Deaktivieren zu verlassen.
Im nächsten Schritt wird die Reichweite der Tools und Netzwerkpfade reduziert. Das kann bedeuten, die betroffene Integration oder das Tool temporär zu deaktivieren oder eine Policy zu setzen, die den Agenten am Zugriff auf die betroffenen Ressourcen hindert. Wenn der Verdacht besteht, dass Daten das eigene Umfeld verlassen könnten, sind Netzwerkregeln ein zusätzlicher Schutzrahmen, bis die Untersuchung Klarheit schafft. Diese Kontrolle sollte dabei außerhalb der Agent-Instruktionen liegen, also nicht im „Ermessen“ des Modells. Ergänzend empfiehlt das OWASP-Umfeld das Prinzip „Least Privilege“ für Tool-Zugriffe, explizite Autorisierung für sensitive Operationen, Audit Trails sowie Mechanismen, um Agentenoperationen unterbrechen oder zurückrollen zu können. Erst danach schließt sich die forensische Schleife an: Beweise werden gesichert, etwa Agent-ID, Run- oder Session-ID, Zeitstempel, Tool-Calls, Autorisierungsentscheidungen und betroffene Ressourcen. Entscheidend ist auch die saubere Trennung von bestätigten Aktionen und bloßen Versuchen; ein Logeintrag über eine angeforderte Aktion beweist nicht automatisch, dass sie erfolgreich war.
Schließlich müssen Teams mögliche Downstream-Effekte einordnen. Wurde etwa auf ein sensibles Konto oder eine kritische Ressource zugegriffen, wird dieses Ziel unabhängig vom Agenten selbst bewertet: zusätzliche Rechte können entzogen, unautorisierte Änderungen rückgängig gemacht und der zuständige System-Owner einbezogen werden. Wenn Daten möglicherweise das Umfeld verlassen haben, greifen organisationsspezifische Incident-, Datenschutz- und Benachrichtigungsprozesse. Und selbst wenn der weitere Zugriff gestoppt ist, bleibt die Kernfrage offen: Was wurde bereits geändert? Stopping verhindert neue Aktivität, kann aber ausgeführte Handlungen nicht „rückgängig machen“. Beim Neustart sollte deshalb die Ursache adressiert werden: unsichere Eingaben, zu weit gefasste Berechtigungen, eine kompromittierte Integration, eine Konfigurationsänderung oder ein Defekt im Umfeld des Agenten. Ein reines Prompt-Tuning behebt Probleme in Credentials oder Netzwerkpolitik nicht. Anschließend wird das Workflow-Verhalten kontrolliert getestet, Autorisierungsgrenzen für High-Impact-Aktionen werden geprüft und Tool-Calls nach dem Resume weiter überwacht. Vorbereitet wird das Ganze am besten durch belastbare Runbooks: Für jeden Produktion-Agenten sollten Ownership, die Möglichkeit zur Suspendierung, die zu widerrufenden Identitäten und Tools sowie die zu untersuchenden Logs konkret bekannt sein. NIST stellt das dabei als Teil von Cybersecurity-Risikomanagement in die Achse aus Vorbereitung, Reaktion und Recovery, nicht als Improvisationshandbuch.
Damit rückt auch der Credential-Layer in den Fokus, weil Containment ohne kontrollierbare Secrets oft zu spät greift. Genau hier setzt KeeperPAM als Secrets- und Zugriffskomponente laut Beschreibung an: Es bündelt Secrets-Management, Access Controls und Auditing so, dass Organisationen die Credentials hinter KI-getriebenen Workflows besser regeln können. Mit einem Secrets Manager sollen Teams Agents nur die Secrets geben, die ihre Aufgaben wirklich benötigen, Credentials zur Laufzeit abrufen und Ereignisse zur Secret-Nutzung nachvollziehbar machen. In der Logik des Incident-Containments bedeutet das: Der Widerruf und die Einschränkung von Zugriffen können stärker an echte, kontrollierbare Berechtigungsobjekte gekoppelt werden – und damit die Chance erhöhen, dass Containment tatsächlich sowohl laufende als auch queued Ausführungen stoppt und anschließende Netzwerkzugriffe begrenzt. Für Entscheider heißt das am Ende: Sicherheit ist nicht „ein Prompt“, sondern ein choreografiertes Zusammenspiel aus Orchestrator-Kontrollen, Identity-Mechanismen, Tool-Policies und Netzwerksegmentierung.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "KI-Agent stoppen: Warum „Kill Switch“ mehr als ein Prompt ist" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "KI-Agent stoppen: Warum „Kill Switch“ mehr als ein Prompt ist" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »KI-Agent stoppen: Warum „Kill Switch“ mehr als ein Prompt ist« bei Google Deutschland suchen, bei Bing oder Google News!