
LONDON (IT BOLTWISE) – OpenAI hat mit „BioBasicsBench“ einen neuen Bewertungsstandard vorgestellt, der KI anhand von rohen Nasslabor-Nachweisen aus realen Experimenten prüft. Der Test umfasst 100 Aufgaben aus fünf biologischen Kernbereichen und nutzt neben Laborvideos auch Instrumentenausgaben. In den Auswertungen zeigen sich deutliche Lücken bei praktischen Laborabläufen, während strukturierte Datenerfassung besser gelingt. Gleichzeitig macht das Setup klar, wie wichtig wiederholbare Referenzdaten und ein sauberer Umgang mit Mehrdeutigkeiten sind.
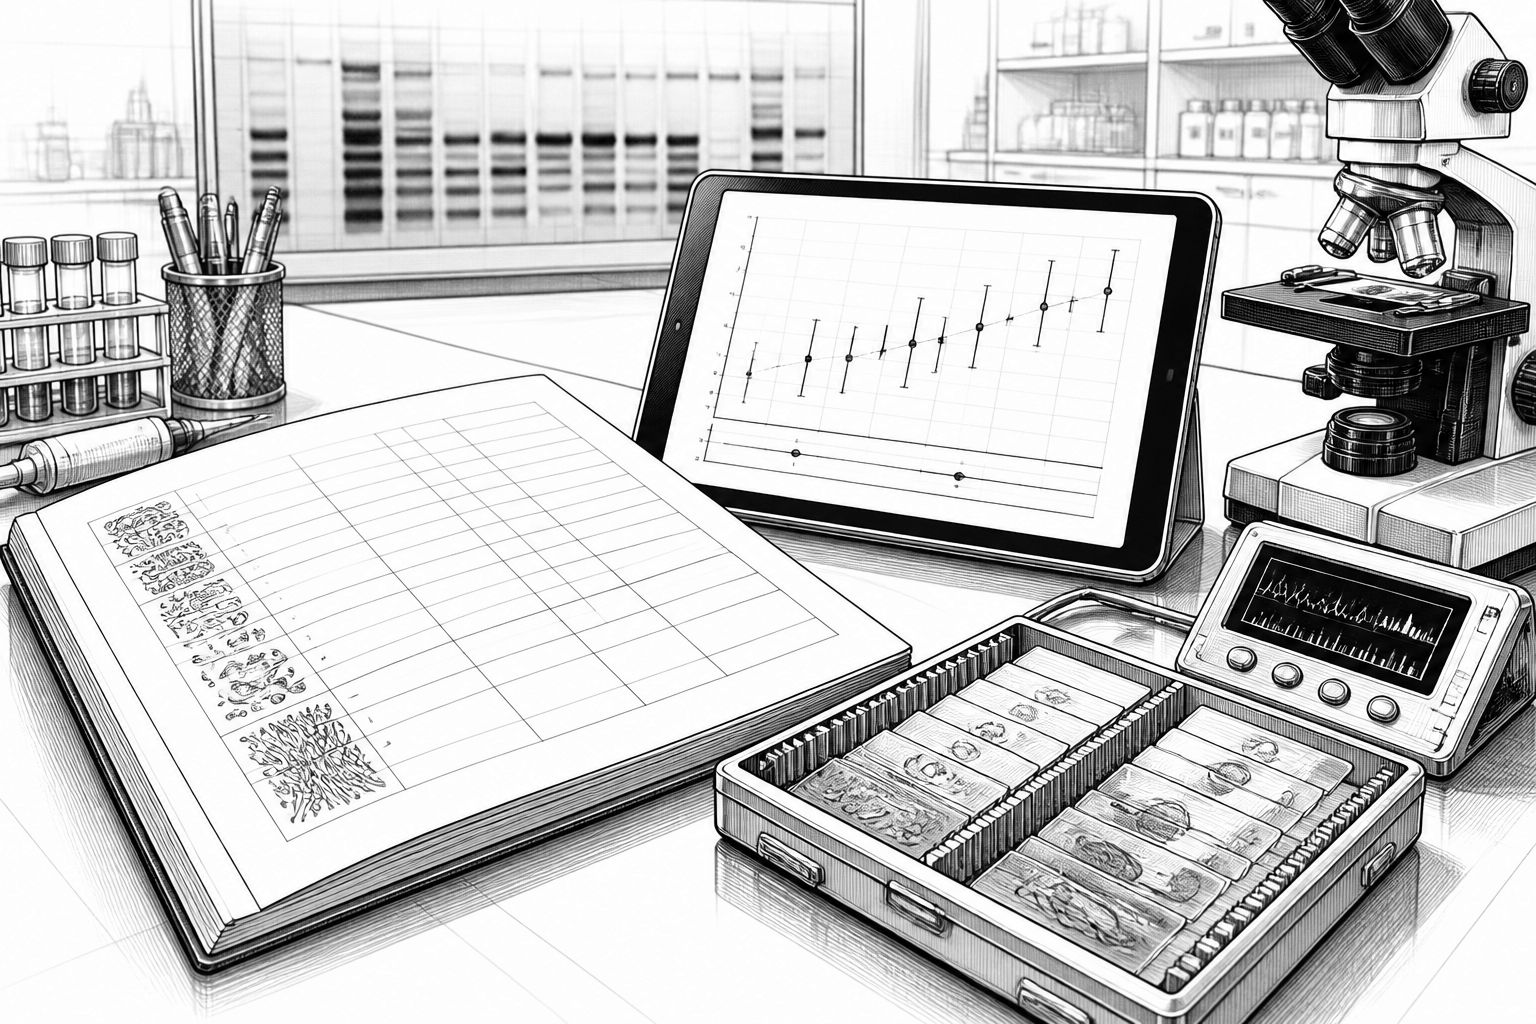
OpenAI stellt mit „BioBasicsBench“ einen Bewertungsstandard bereit, der den Fokus bewusst weg von Text- oder rein simulierten Datensätzen verlagert und stattdessen echte, in Wet-Lab-Workflows anfallende Spuren in die Bewertung einbezieht. Im Kern geht es darum, Künstliche Intelligenz nicht nur auf „sauber aufbereitete“ Labels zu testen, sondern auf rohere experimentelle Nachweise und direkte Instrumentenausgaben. Das Testportfolio ist über ein Forschungsportal zugänglich und enthält nach den vorliegenden Angaben Aufgabenbeschreibungen, Evaluierungsskripte sowie Referenzdaten, wodurch der Vergleich zwischen Modellen auf einer gemeinsamen Basis möglich werden soll.
Der Katalog deckt 100 Aufgaben aus fünf biologischen Disziplinen ab: Proteinmethoden, Bildgebung und Zytometrie, Quantifizierung und Assays, Nukleinsäuremethoden sowie molekulares Klonieren. Als Datengrundlage dienen unbearbeitete Versuchsdaten wie Gele, Kolonieplatten, mikroskopische Aufnahmen, Sequenzierungsdaten, Instrumentenausgaben und Laborvideos. Damit verschiebt sich die Messung von „Wie gut liest das Modell einen Text?“ zu „Wie gut kann das Modell aus visuellen und instrumentennahen Signalen ableiten, welche nächsten Schritte im Labor fachlich plausibel sind?“ Für Unternehmen ist das relevant, weil sich die Qualität solcher Modelle später in Labor- oder Pipeline-Entscheidungen niederschlägt, etwa bei der Interpretation von Messausgaben oder bei der Vorbereitung weiterer Experimente.
Qualitätssicherung spielt dabei eine zentrale Rolle im Setup. Jede Aufgabe durchlief ein dreistufiges Prüfverfahren, an dem Wissenschaftler von Ligo, ein externer promovierter Nasslabor-Forscher sowie ein interner Prüfer beteiligt waren. OpenAI beschreibt außerdem, dass die ausgewiesenen Werte den Anteil der erreichten Rubrik-Punkte widerspiegeln und nicht automatisch eine Erfolgsquote vollständig korrekter Experimente darstellen. Damit adressiert der Benchmark zwar wichtige Aspekte von Wissenschaftlichkeit, bleibt aber zugleich klar in einem Bewertungsrahmen: Es geht um die Übereinstimmung mit einer Bewertungsrubrik für Laborhandlungen und Interpretationen, nicht um die Garantie, dass ein gesamter experimenteller Prozess im Feld immer reproduzierbar „zum richtigen Ergebnis“ führt.
In der eigentlichen Testphase wurden sieben Modelle in 37 Modell- und Reasoning-Konfigurationen evaluiert. Pro Aufgabe liefen fünf Durchläufe, sodass insgesamt 18.500 Einzelergebnisse entstanden. Auf der höchsten Reasoning-Stufe erreichte laut den angegebenen Resultaten GPT-6 Astra 66,7 Prozent der Rubrik-Punkte bei einem 95-Prozent-Konfidenzintervall von 60,3 bis 73,1 Prozent; dabei lag der Verbrauch bei 4.704 Output-Token pro Aufgabe. GPT-6.1 Sol kam auf 62,0 Prozent (Konfidenzintervall 55,6 bis 68,4 Prozent, 5.238 Token), während spätere Plätze unter anderem GPT-5.6 Sol (43,8 Prozent, 37,6 bis 50,0 Prozent, 9.099 Token) und GPT-5.2 (31,2 Prozent, 26,2 bis 36,3 Prozent, 27.620 Token) umfassten. Diese Spannbreite deutet darauf hin, dass Reasoning-Ansatz und Kostenprofil nicht unabhängig voneinander sind: Höhere Leistungswerte gingen in mehreren Konfigurationen mit klar unterscheidbaren Token-Budgets einher, was spätere Betriebsentscheidungen in Produktion und Automatisierung beeinflussen kann.
Besonders aufschlussreich sind die Schwächen, die nicht „nur“ auf begrenztes Wissen hindeuten, sondern auf typische Fehlerbilder in praktischen Abläufen. Bei einem Klonierungs-PCR-Test interpretierte GPT-6 Astra Kontrollen falsch; im beschriebenen Szenario hätte das dazu führen können, dass ein falsches Plasmid gereinigt wird. Bei der Zählung von Kolonien lag das Modell rund 12 Prozent über der Benchmark-Referenz, weil es tatsächliche Kolonien übersah und statt dessen leeren Agar als Kolonien markierte. Gleichzeitig gibt es aber auch positive Indizien: In einer Aufgabe erkannte das Modell, dass ein Detektor Licht zweier verschiedener Farbstoffe erfassen kann, und leitete daraus ab, dass reine Helligkeit nicht zwingend einen Zelltod belegt. Solche Muster sind für die KI-Entwicklung in der Biotech-Umgebung entscheidend, weil sie zeigen, wo ein Modell robuste physikalisch/experimentelle Intuition besitzt und wo es durch mehrdeutige Signale fehlgeleitet wird.
OpenAI argumentiert, der Benchmark solle vor allem Optimierungsbedarfe beim wissenschaftlichen Fortschritt sowie im Bereich der biologischen Sicherheit identifizieren. Frühzeitige Ergebnisse legen dabei nahe: Moderne Spitzenmodelle überzeugen bei der strukturierten Extraktion von Daten, geraten aber deutlich, wenn kontextbezogenes Urteilsvermögen gefragt ist, etwa bei mehrdeutigen Befunden oder wenn Laborprotokolle angepasst werden müssen. In der Auswertung fehlt nach Angaben, die in Branchenberichten aufgegriffen werden, außerdem der Vergleich mit nicht vom jeweiligen Hersteller stammenden Baselines; zudem umfasse die Veröffentlichung zunächst primär herstellereigene Ergebnisse. Für Entscheider heißt das: Die Kennzahlen sind ein starkes Indiz für Fortschritt, ersetzen aber noch keine unabhängige Reproduktion in der eigenen Laborumgebung, insbesondere wenn unklare Randbedingungen oder andere Messgeräte im Einsatz sind.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "BioBasicsBench: OpenAI testet KI-Modelle mit Nasslabor-Aufgaben und 100 Benchmarks" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "BioBasicsBench: OpenAI testet KI-Modelle mit Nasslabor-Aufgaben und 100 Benchmarks" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »BioBasicsBench: OpenAI testet KI-Modelle mit Nasslabor-Aufgaben und 100 Benchmarks« bei Google Deutschland suchen, bei Bing oder Google News!