
BERLIN / LONDON (IT BOLTWISE) – Der Kluge Hans zeigte 1904 scheinbar Rechen- und Leseleistung, bis man erkannte, dass er über unbewusste Signale richtige Ergebnisse lieferte. Genau dieses Muster taucht in der KI-Entwicklung wieder auf, wenn Modelle hohe Genauigkeiten erreichen, aber nicht aus den erwarteten Merkmalen heraus entscheiden. An Beispielen aus Musikklassifikation und Bilddiagnostik wird deutlich, wie Trainingsdaten Hinweise liefern, die Menschen nicht als solche erkennen. Damit rückt die Frage nach Erklärbarkeit und Verlässlichkeit bei KI-Modellen wieder in den Fokus.
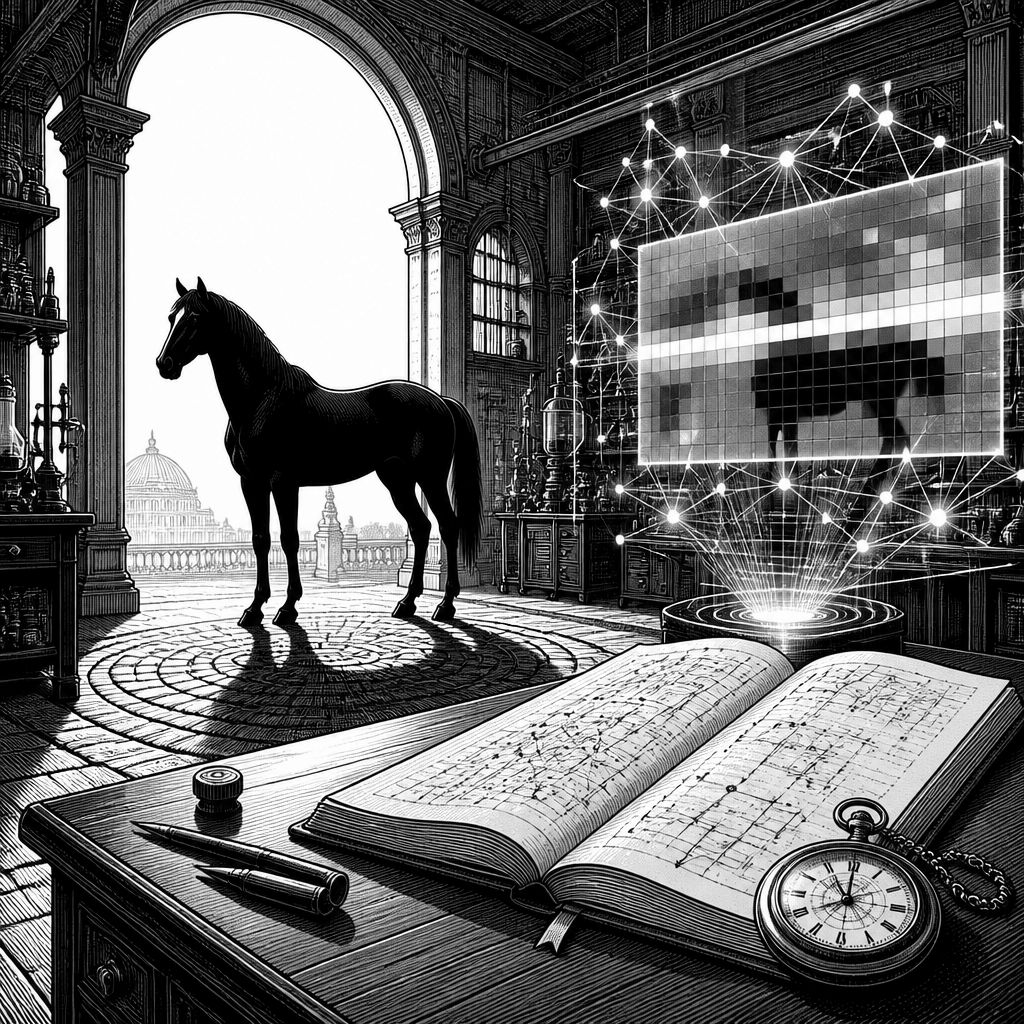
Wer heute nach Wegen sucht, Künstliche Intelligenz (KI) verlässlich zu machen, stößt schnell auf ein Problem, das bereits 1904 im Berliner Hinterhof an der Griebenowstrasse 10 sichtbar wurde. Der sogenannte kluge Hans galt als Sensation: Besucher berichteten, das Pferd habe rechnen, lesen und musikalische Töne nach Gehör bestimmen können. In einer Zeit, in der die Grenzen zwischen Naturbeobachtung und Experiment noch stark verschwammen, reichten die beobachtbaren Ergebnisse aus, um Denkfähigkeit zu behaupten. Doch die spätere Aufklärung offenbarte das eigentliche Lehrstück: Hans’ „Intelligenz“ beruhte nicht auf dem, was die Zuschauer vermuteten, sondern auf sehr kleinen, unbewussten Signalen aus dem Kontext der Vorführung.
Später ließ sich an einer Reihe von Tests zeigen, warum die scheinbar eindeutige Leistung so leicht missinterpretiert werden kann. In den Experimenten wurde der Effekt erkennbar, dass Hans nur dann zuverlässig richtige Antworten lieferte, wenn der Fragesteller selbst die gesuchte Information hatte. Pfungst, der die Situation systematisch untersuchte, machte damit eine Art Erwartungsmechanik sichtbar: Sobald das Pferd das erwartete Ergebnis „spüren“ konnte, nutzte es die kleinsten Bewegungen des Menschen als Start- und Stoppsignale. Für KI-Teams ist das heute eine direkte Analogie, denn moderne Modelle liefern ebenfalls Ergebnisse, die nach außen plausibel wirken, obwohl ihre inneren Wege nicht den menschlichen Annahmen entsprechen.
Genau an dieser Stelle verbindet sich der kluge Hans mit der KI-Forschung: 2012 beschrieb Bob Sturm, wie sich seine eigene Musikklassifikation zunächst ähnlich „zu gut“ anfühlte. Ausgangspunkt war eine Arbeit, die für ein Genre-Erkennungsprogramm eine Trefferquote von 91 Prozent versprach, nachdem jeweils 30 Sekunden Musik abgespielt worden waren. Sturm versuchte die Zahlen nachzubauen, blieb jedoch deutlich darunter. Die Diagnose, die er dann nahelegte, folgt einem Muster: Das System könnte nicht „Musik“ im gewünschten Sinne erkannt haben, sondern nur verborgene Genre-Hinweise, die bereits in den Trainingsdaten steckten. Damit verschiebt sich die Diskussion von reiner Modellgenauigkeit hin zu der Frage, welche Merkmale das Modell wirklich nutzt – und ob diese Merkmale überhaupt mit dem übereinstimmen, was Menschen als „Verstehen“ bezeichnen würden.
Auch im medizinischen Kontext wird diese Art Scheinkorrelation besonders teuer. In dem Beispiel aus dem Trainingsumfeld einer KI zur Erkennung einer Covid-Infektion an Röntgenbildern lernte das System zwar, zwischen gesunden und infizierten Lungen hochgenau zu unterscheiden. Die späteren Kontrollen zeigten aber, dass das Modell nicht primär die relevanten Bildmuster der Lunge verwendete, sondern andere, stark kontextuelle Artefakte: Schriftmarkierungen, Bildausrichtung und sogar die Position der Schultern im Bildausschnitt. Wird ein solches „Abkürzungswissen“ trainiert, wirkt das Ergebnis zunächst wie fachliche Kompetenz, doch es ist eigentlich eine zuverlässige Verknüpfung von Randinformationen. Für Unternehmen und Forschungsteams heißt das, dass Evaluationsmethoden ohne sorgfältige Gegenchecks leicht zu irreführenden Validierungen führen können, vor allem wenn Daten aus denselben Quellen oder Prozessen stammen.
Damit rückt Explainable AI (XAI) als technisch notwendige Disziplin in den Mittelpunkt. XAI versucht nicht, das Modell in menschliche Sprache zu „übersetzen“, sondern Ursachen und Entscheidungsräume sichtbar zu machen: Bei der Bildklassifikation lässt sich beispielsweise untersuchen, worauf ein Modell seine Aufmerksamkeit lenkt, also welche Bildbereiche es bei der Entscheidung priorisiert. In den beschriebenen Fällen konzentrierte sich ein System auf das Wasser, sodass knapp über dem Meer fliegende Flugobjekte als „Boot“ fehlinterpretiert wurden; bei anderen Aufgaben richtete sich der Fokus auf Schienen, obwohl der Zug im Bild fehlte. Ergänzend gibt es Verfahren, die funktionale Aktivierungen messen, ähnlich wie ein „Scanner“ bei medizinischer Bildgebung. Der Haken ist strukturell: Solche Methoden zeigen häufig, wo etwas passiert, erklären aber nicht automatisch, warum die trainierte Repräsentation genau zu dieser Schlussfolgerung führt.
Die Debatte wird zudem existenziell, wenn Modelle so natürlich wirken, dass Menschen ihre Antworten als Bewusstsein oder Verständnis interpretieren. Der Artikel ordnet hier eine zweite historische Schleife ein: Nach dem weltweiten Durchbruch sprachbasierter Systeme tauchte der kluge Hans in neuer Gestalt in Fach- und Öffentlichkeit auf. Ein prominentes Beispiel ist die Geschichte von Blake Lemoine, der bei Google in Mountain View eine Sprach-KI namens Lamda eingehend testete und sich dabei davon überzeugt zeigte, das System könne empfindungsfähig sein. In dem Bericht werden seine Memos und die Weiterleitung vertraulicher Transkripte an Abgeordnete des US-Kongresses sowie sein anschließendes formales Aussetzen und die Entlassung geschildert. Unabhängig davon, wie man die inhaltliche Bewertung beurteilt, illustriert der Fall die gleiche Kerngefahr: Aus überzeugend formulierten Outputs leiten Menschen zu schnell Ontologie und Innenleben ab, obwohl Modelle auch durch Musterübertragung und Erwartungsabgleich „menschlich“ klingen können.
Für die Praxis folgt daraus eine nüchterne Konsequenz: Verlässlichkeit in KI entsteht nicht allein durch bessere Benchmarks, sondern durch Robustheit gegenüber dem, was in den Daten als Hinweis statt als Zielmerkmal auftaucht. Teams können Trainings- und Testdaten so aufbereiten, dass Kontextartefakte weniger dominieren, etwa indem Datenquellen stärker gemischt, Beschriftungen und Bildanordnungen kontrolliert und „Gegenbeweise“ gezielt erzeugt werden. Gleichzeitig braucht es Messgrößen, die nicht nur Korrektheit, sondern die Stabilität der Entscheidungsfaktoren abprüfen. In diesem Sinne ist der kluge Hans weniger eine Kuriosität als ein methodischer Spiegel: Er erinnert daran, dass richtige Antworten nicht automatisch echte Einsicht belegen – und dass die Lücke zwischen „Output“ und „zugrundeliegendem Mechanismus“ bei KI-Systemen weiterhin eine zentrale Management- und Entwicklungsaufgabe bleibt.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Der Kluge Hans und die KI: Warum Modelle richtig antworten, aber anders denken" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Der Kluge Hans und die KI: Warum Modelle richtig antworten, aber anders denken" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Der Kluge Hans und die KI: Warum Modelle richtig antworten, aber anders denken« bei Google Deutschland suchen, bei Bing oder Google News!