
LONDON (IT BOLTWISE) – Der Palo-Alto-Startup Elorian stellt mit Glimpse sein erstes KI-Modell als Research-Preview vor. Das Modell soll beim visuellen Reasoning nicht nur einmal auf ein Bild schauen, sondern während des Denkens gezielt in den Bildinhalt „zurückspringen“ und Bereiche oder Videoframes erneut analysieren. Dafür nutzt es einen Mechanismus, den das Unternehmen „visual scratch space“ nennt. Mit API-Zugriff und einer Chat-Oberfläche startet Glimpse zunächst in eine Warteliste – positioniert sich aber bereits mit konkreten Kosten- und Benchmark-Angaben.
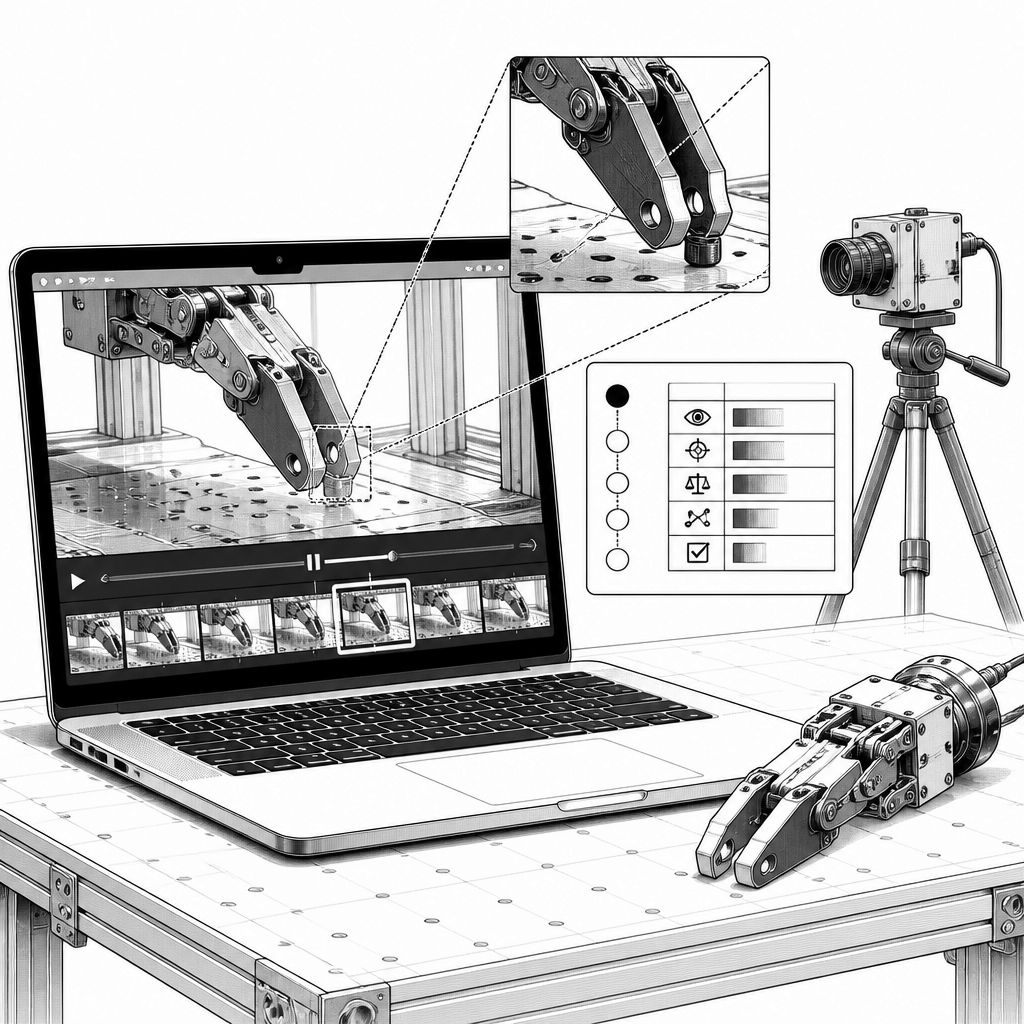
Elorian geht mit seiner ersten Modellgeneration einen Weg, der für Unternehmen besonders spannend ist, die nicht nur „Bild beschreiben lassen“, sondern visuelle Daten in konkrete Entscheidungen übersetzen müssen. Das Startup aus Palo Alto hat mit Glimpse einen KI-Baustein angekündigt, der Künstliche Intelligenz beim Reasoning über Bild- und Videoinhalte bewusst in einen iterativen Modus zwingt: Statt ein einziges Bild einmal in Tokens zu verwandeln und das Denken dann im Textraum fortzusetzen, greift das Modell während der Problemlösung erneut auf den Rohinhalt zurück. Genau diese Lücke sehen die Gründer als Kernproblem heutiger Multimodal-Systeme an, die zwar sprachlich überzeugend wirken, aber visuelle Informationen oft nicht zuverlässig „prüfen“, sobald es um mehr als eine oberflächliche Beschreibung geht.
Technisch beschreibt Elorian den Mechanismus als „visual scratch space“: Das System kann mid-reasoning in eine Region hinein zoomen, einzelne Frames aus einem Video ziehen oder Code ausführen, um gemessene oder vergleichende Eigenschaften der gerade betrachteten Inhalte zu bestimmen. Der praktische Effekt ist wie beim wiederholten Hinsehen auf einem Smartphone-Foto: Man glaubt zunächst, etwas erkannt zu haben, zoomt dann in eine Ecke, zieht den relevanten Ausschnitt größer heran und prüft damit die eigene Hypothese. Auf Architektur-Ebene heißt das weniger „mehr Rechenzeit“, sondern eher ein stärker eingebetteter Kreislauf zwischen visueller Wahrnehmung und dem nächsten Schritt der Argumentation. Genau dagegen richtet sich die Kritik, die Andrew Dai – ehemaliger Google-DeepMind-Forscher und CEO von Elorian – aus einem konkreten Alltagsszenario ableitet: Bei einem Spielabend habe er einem frontier Modell die Frage gestellt, wer gerade gewinnt, nachdem er ein Foto des fertigen Brettspiels aufgenommen hatte. Das Modell konnte keine verlässliche Antwort geben, obwohl für Menschen die Symbolik vieler Brettspiele auch mit minimaler Zusatzbeschriftung eindeutig ist.
Im Interview-ähnlichen Kontext aus der Quelle wird die Beobachtung zugespitzt: Brettspiele hätten „ihre eigene visuelle Sprache“ mit eigener Ikonografie und Symbolik. Für einen Menschen sei es relativ leicht, anhand weniger Hinweise zu verstehen, was gerade passiert; für die Modelle dagegen sei die intuitive Bedeutung dieser Symbole nicht zuverlässig ableitbar. Daraus folgt eine zentrale Konsequenz für die Produktisierung: Wer multimodales Reasoning in Produktionsumgebungen bringt, braucht nicht nur Bild-zu-Text-Kompetenz, sondern eine Art visuellen Gedächtnisraum, der während der Aufgabe gezielt an den richtigen Stellen nachschlägt. Elorian betont zudem, dass das Grundprinzip nicht völlig neu ist: OpenAI habe bereits 2025 bei den o-series Modellen ein Crop-and-Zoom während des Reasonings ergänzt. Der Unterschied in Elorians Darstellung liegt weniger in der Idee an sich, sondern darin, das Modell von Anfang an um diesen iterativen Zugriff herum aufzubauen – mit dem Anspruch, dabei „billig“ und effizient zu bleiben.
Finanziell und betriebspraktisch wird Glimpse durch die genannten Kosten in eine klarere Vergleichbarkeit gerückt. Elorian stellt das Modell als Forschungsvorschau (research preview) bereit, mit API-Zugang und einer Chat-Oberfläche, die zunächst nur über eine Warteliste erreichbar ist. Laut Unternehmen sei Glimpse mit einem kleinen Team auf „ein paar hundert GPUs“ trainiert worden und in der Modellgröße deutlich kleiner als die „frontier“-Systeme, gegen die es benchmarked. Preislich nennt Elorian 0,60 USD pro Million Tokens für Eingaben und 3 USD pro Million Tokens für Ausgaben. Damit positioniert sich Glimpse laut eigener Einordnung günstiger als Mid-Level-Modelle wie Sonnet/Sol, aber teurer als lightweight-Modelle wie Haiku und Luna. Für Betreiber ist das relevant, weil visuelles Reasoning typischerweise mehr Zwischenschritte auslöst als reine Textaufgaben – und Token-Kosten damit schneller in den Vordergrund treten als bei klassischen Chatbots.
Bei der Leistungsfähigkeit liefert Elorian ebenfalls konkrete Aussagen, die für Evaluationspläne wichtig sind. Demnach schneidet Glimpse in den eigenen Tests besser ab als GPT-6 Astra, und zwar bei „scientific chart reasoning“ sowie bei „short-form video captioning“. Gleichzeitig nennt das Unternehmen für andere visuelle Reasoning-Aufgaben Ergebnisse, die im Wettbewerb als „competitive“ beschrieben werden. Für Entscheider bedeutet das: Der Nutzen liegt nicht nur im „Sehen“ im Sinne einer Caption, sondern im Umgang mit strukturierten Visuals – Diagrammen, Zeitverläufen und typischen Musterwechseln in kurzen Clips. Genau dort, wo Daten aus Videos oder grafischen Darstellungen abgeleitet werden müssen, zahlt sich ein Mechanismus aus, der während der Lösung gezielt in Regionen und Sequenzen zurückspringen kann. Das wird auch durch die geplanten Zielmärkte gestützt: Elorian richtet sich zunächst an Unternehmen, die viel Video besitzen, darunter Robotik-Firmen, wissenschaftliche Labore, Medienhäuser und kreative Unternehmen.
Die Marktlogik dahinter ist klar: Sobald Video als primäre Datenquelle in Workflows einzieht, entsteht ein Bedarf an Modellen, die nicht nur im Nachhinein beschreiben, sondern aktiv Arbeitsschritte steuern. Elorian formuliert deshalb eine Roadmap, die von „seeing“ zu „doing“ überleitet. In der nächsten Ausbaustufe will das Unternehmen ein Modell einer Szene aufbauen und diese nutzen, um Aktionen abzuleiten – inklusive direkter Steuerung von Robotern. Damit rückt Glimpse aus der Komfortzone „Assistenz für Menschen“ heraus und wird zu einem Baustein in stärker automatisierten Systemen, in denen Fehlinterpretationen teurer sind. Für die KI-Entwicklung heißt das gleichzeitig: Das Unternehmen wird sich Fragen zur Robustheit bei wechselnden Bildqualitäten, zur Latenz während iterativer Bildzugriffe und zur Nachvollziehbarkeit solcher Reasoning-Schritte stellen müssen – besonders, wenn Teams Glimpse über die API in Produktionspipelines einbinden.
Elorian kommt zudem mit einer bereits laufenden Finanzierungs- und Netzwerkgeschichte aus der Startup-Phase. Das Unternehmen sei aus dem Stealth-Modus vor etwa sechs Monaten hervorgetreten, mit einer Seed-Runde über 55 Millionen US-Dollar bei einer Bewertung von 300 Millionen US-Dollar, co-gelead von Striker Venture Partners, Menlo Ventures und Altimeter Capital, mit Beteiligung von NVIDIA und Jeff Dean. Diese Konstellation ist für die technische Glaubwürdigkeit relevant, weil visuelle Reasoning-Mechanismen typischerweise Hardware- und Trainingsbudget brauchen – nicht nur für das Modell selbst, sondern auch für Datenaufbereitung und Evaluation. Ob Glimpse in der Breite zum Standard wird, hängt am Ende davon ab, wie schnell Entwickler den iterativen Zugriff über Bildregionen und Videoframes in stabile, wiederholbare Pipelines übersetzen können. Elorian setzt dabei eine klare Messlatte: Nächstes Jahr will das Unternehmen „das beste Visual-Reasoning-Modell“ aufbauen, das in allen relevanten visuellen Reasoning-Tests führt. Für Produktteams ist die konkrete Frage daher weniger, ob das Modell Bilder versteht – sondern ob der „visual scratch space“-Ansatz im Alltag zuverlässig die Lücke schließt, die heutige Multimodal-Modelle beim Prüfen und Hinterfragen visueller Hinweise offenlassen.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Elorians KI „Glimpse“: Visuelle Reasoning-Modelle mit „Visual Scratch Space“" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Elorians KI „Glimpse“: Visuelle Reasoning-Modelle mit „Visual Scratch Space“" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Elorians KI „Glimpse“: Visuelle Reasoning-Modelle mit „Visual Scratch Space“« bei Google Deutschland suchen, bei Bing oder Google News!