
SILICON VALLEY / LONDON (IT BOLTWISE) – Flapping Airplanes hat eine 1-Milliarde-Dollar-Series-A-Runde angekündigt, co-geführt von Index und Lux. Die Finanzierung wird Berichten zufolge bei einer Bewertung von 6 Milliarden Dollar eingeordnet. Das Startup will mit einem „Megakernel“-Framework große KI-Modelle trainieren und ausführen, ohne dafür massenhaft Daten zu benötigen. Im Fokus stehen dabei effizientere GPU-Nutzung, damit Trainings- und Inferenzlasten stärker ineinandergreifen.
Dass ein erst ein Jahr altes Startup direkt in die Größenordnung von 1 Milliarde US-Dollar vorstößt, ist in der KI-Welt ein starkes Signal für einen Trend: Nicht nur bessere Modelle, sondern vor allem bessere Trainings- und Ausführungseffizienz. Flapping Airplanes meldete den Abschluss einer Series A in Höhe von 1 Milliarde US-Dollar, co-geführt von Index und Lux, und wird dabei Berichten zufolge mit einer Bewertung von 6 Milliarden US-Dollar bewertet. Die Runde kommt nicht aus dem Nichts, sondern baut auf einer Seed-Finanzierung im Volumen von 180 Millionen US-Dollar auf, die neun Monate zuvor startete und das Unternehmen damals mit 1,5 Milliarden US-Dollar bewertete; damit hat sich die Bewertung auf dem Papier vervierfacht. Für Beobachter aus dem Venture-Umfeld ist das weniger ein „Wette auf die Story“ als eine Wette auf ein konkretes technisches Versprechen: KI-Systeme sollen mit weniger Daten trainierbar werden und zugleich in der Praxis günstiger laufen.
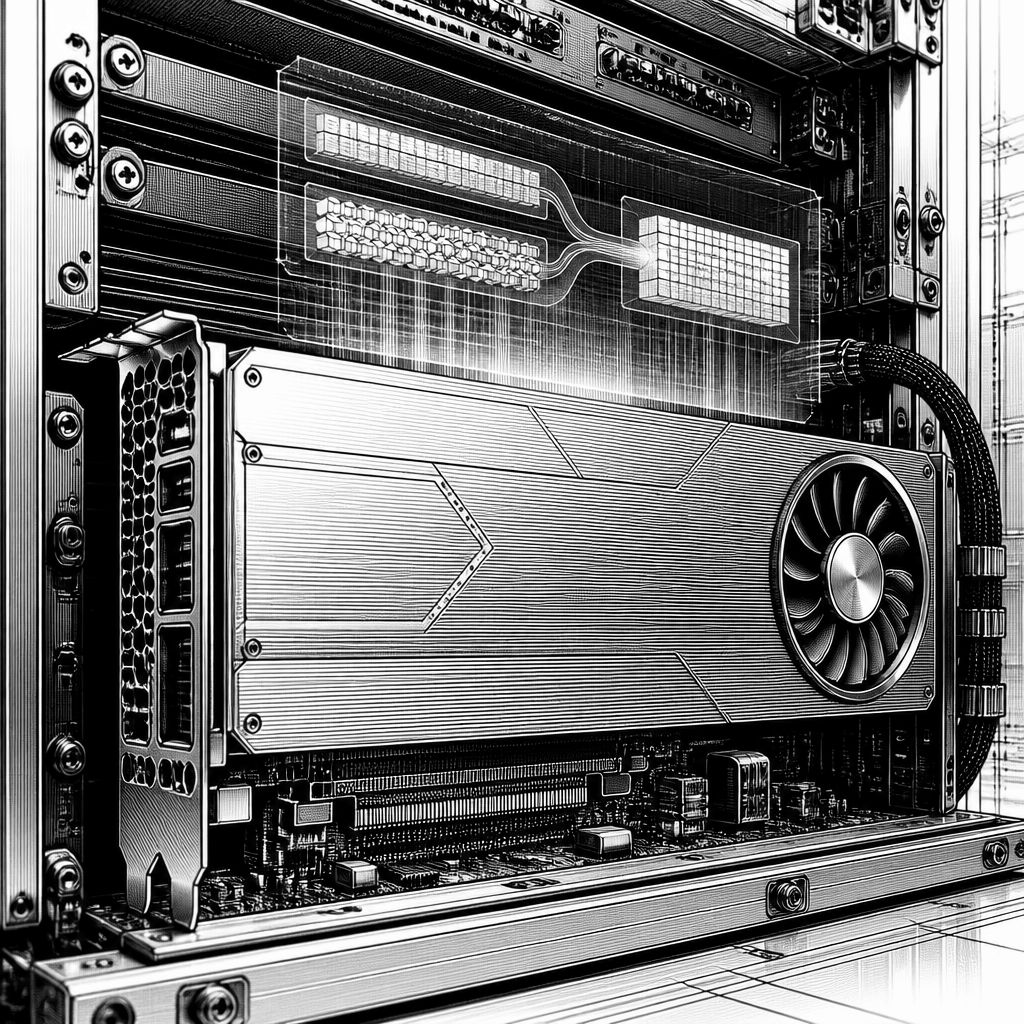
Technisch setzt das Team um Aidan Smith sowie die Brüder Asher und Ben Spector auf ein Framework, das sie selbst als „megakernel“ beschreiben. Der Kern der Idee: Statt mehrere einzelne GPU-Kernels nacheinander oder getrennt laufen zu lassen, bündelt eine „Megakernel“-Architektur viele Schritte in einem einzigen Programm. In den eigenen Beschreibungen heißt es: „the world’s most complete megakernel framework. It can perform entire training runs, serve inference, play video games, and even do all three simultaneously in a single kernel.“ Ein „Kernel“ ist dabei ein Programm, das auf der GPU läuft; ein „Megakernel“ soll Aufgaben so zusammenführen, dass die GPU weniger Leerlaufzeiten hat. Genau hier knüpft die Dateneffizienz-These an: Wenn die Hardwareauslastung besser ist und Workloads geschickter gemischt werden, können Experimente schneller iterieren und Trainingsläufe effizienter werden.
Der konkrete technische Hebel liegt laut den Aussagen der Gründer in der Überlappung von Inferenz und Training. Sie behaupten, das Framework könne „overlap memory-bound inference with compute-bound training“, also einen Inferenz-Teil, der stark auf Speicherzugriffe angewiesen ist, gleichzeitig mit einem Trainings-Teil koppeln, der eher rechenintensiv ist. In der Praxis zielt das darauf ab, typische Engpässe zu entschärfen: Ein Chip sitzt häufig nicht deshalb untätig, weil es keine Arbeit gibt, sondern weil einzelne Phasen auf Daten warten oder andere Engpässe entstehen. Wenn das System Aufgaben so orchestriert, dass Wartezeiten der einen Phase nicht die gesamte Pipeline ausbremsen, lässt sich die Hardware-Nutzung verbessern. Für Unternehmen, die KI entwickeln oder betreiben, ist das relevant, weil es die Kostenfrage in zwei Richtungen adressiert: schnellere Trainingszyklen (Zeitbudget, Compute-Budgets) und effizientere Inferenz (Latenz, Durchsatz, laufende Infrastrukturkosten).
Die Finanzierung unterstreicht, dass auch der Markt genau diese Kombination aus Ingenieursarbeit und Skalierbarkeit erwartet. Neben den neuen Co-Leadern sind laut Meldung frühere Unterstützer wie Sequoia und GV sowie weitere Investoren in der Runde vertreten, darunter Kleiner Perkins und auch Nvidia; insgesamt werden außerdem Valor, Atreides, A*, Kleiner Perkins sowie frühere Geldgeber namentlich genannt. Bemerkenswert ist auch die Gründungsbiografie: Aidan Smith kommt aus der Start-up-Welt und war Thiel Fellow; während des Studiums arbeitete er bei Neuralink. Asher Spector hat als Statistik-PhD den Hintergrund für wissenschaftliche Methodik, Ben Spector bringt als Informatik-PhD die Nähe zu System- und Softwarefragen mit; außerdem gründete er Prod, ein studentisches Accelerator-Programm. Dass gerade der „Megakernel“-Ansatz in den Vordergrund rückt, wirkt wie ein Versuch, Systemnähe nicht als Randthema, sondern als Kernfähigkeit zu etablieren.
Einordnung liefert auch die öffentliche Investorenargumentation, die im Quellentext mit Zitaten wiedergegeben wird. In einem Beitrag erklärte Sequoia-Partner David Cahn zu Prod: „„become one of the most powerful talent incubators in Silicon Valley, ““ und verortete damit auch die Pipeline der Gründer. Diese Art von Resonanz ist für Startups wichtig, weil sie nicht nur Kapital, sondern später auch Rekrutierungs- und Partnerchancen stärkt. Gleichzeitig bleibt die Dateneffizienz-Behauptung der zentrale Prüfstein: Der Quellentext nennt den Satz „A model that’s a million times more data efficient is probably a million times easier to put into the economy“, zugeschrieben an Asher Spector in einem frühen Zeitfenster nach dem Start. Genau dieser Punkt entscheidet darüber, ob sich die Lösung später als reine Optimierung der GPU-Nutzung erweist oder ob sie tatsächlich den Datenbedarf als Engpass für breite Anwendungsfälle reduziert.
Für die Praxis ist dabei entscheidend, wie sich ein solches Framework in reale Produktivumgebungen überführt lässt. Ein Megakernel-Ansatz berührt mehrere Ebenen: Compiler- und Laufzeitlogik, Speicherverwaltung auf GPU-Seite sowie die Fähigkeit, Trainings- und Inferenzpfade koordiniert auszuführen. Besonders in heterogenen Umgebungen – etwa wenn Workloads zwischen Forschung, Batch-Training und interaktiver Inferenz wechseln – muss eine solche Orchestrierung robust sein. Das ist nicht nur eine Frage der Performance, sondern auch der Wartbarkeit: Entwickler möchten nachvollziehbare Diagnosen, planbare Ressourcen und reproduzierbare Ergebnisse. Die neue Finanzierungsrunde schafft hierfür Zeit und Personalbudget, wie der Quellentext betont, um „hire“ auszubauen und das Ziel umzusetzen, KI-Systeme mit geringeren Kosten für Training und Betrieb realisierbar zu machen.
Was in den nächsten Monaten wahrscheinlich besonders beobachtet wird, ist die Messbarkeit der Versprechen: Senkt das Framework den effektiven Datenbedarf wirklich deutlich, oder entsteht der „Fortschritt“ primär durch schnellere und effizientere Trainingsläufe? Für IT-Entscheider in Unternehmen bedeutet das: Es lohnt sich, nicht nur nach Benchmarks zu fragen, sondern nach Betriebskennzahlen wie Durchsatz, Latenz, GPU-Auslastung und der praktischen Skalierung in bestehenden Pipelines. Flapping Airplanes hat mit der Series A jetzt Ressourcen, um genau diese Fragen mit Prototypen und frühen Integrationen zu beantworten. Gleichzeitig zeigt die Runde, dass Investoren weiterhin bereit sind, „Infrastruktur für KI“ als produktfähige Software zu bewerten – nicht nur als Forschungswerkzeug.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Flapping Airplanes erhält 1 Milliarde Dollar: KI-Training mit weniger Daten" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Flapping Airplanes erhält 1 Milliarde Dollar: KI-Training mit weniger Daten" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Flapping Airplanes erhält 1 Milliarde Dollar: KI-Training mit weniger Daten« bei Google Deutschland suchen, bei Bing oder Google News!