
LONDON (IT BOLTWISE) – Ein KV-Cache-Leck in einer disaggregierten KI-Inferenzumgebung hat bei GLM-5.3 in einem begrenzten Zeitraum Nutzerdaten aus anderen Sessions offengelegt. Betroffen waren 155 Antworten, ausgeliefert zwischen Ende August und der Wiederfreischaltung am 9. September 2026. Der Grund lag in einer SGLang-Konfigurationslücke und einem zweiten Bug im Umgang mit abgelehnten überlangen Prompts. Der Fehler wurde durch eine korrigierte KV-Pool-Konfiguration und eine Engine-Härtung upstream abgesichert.
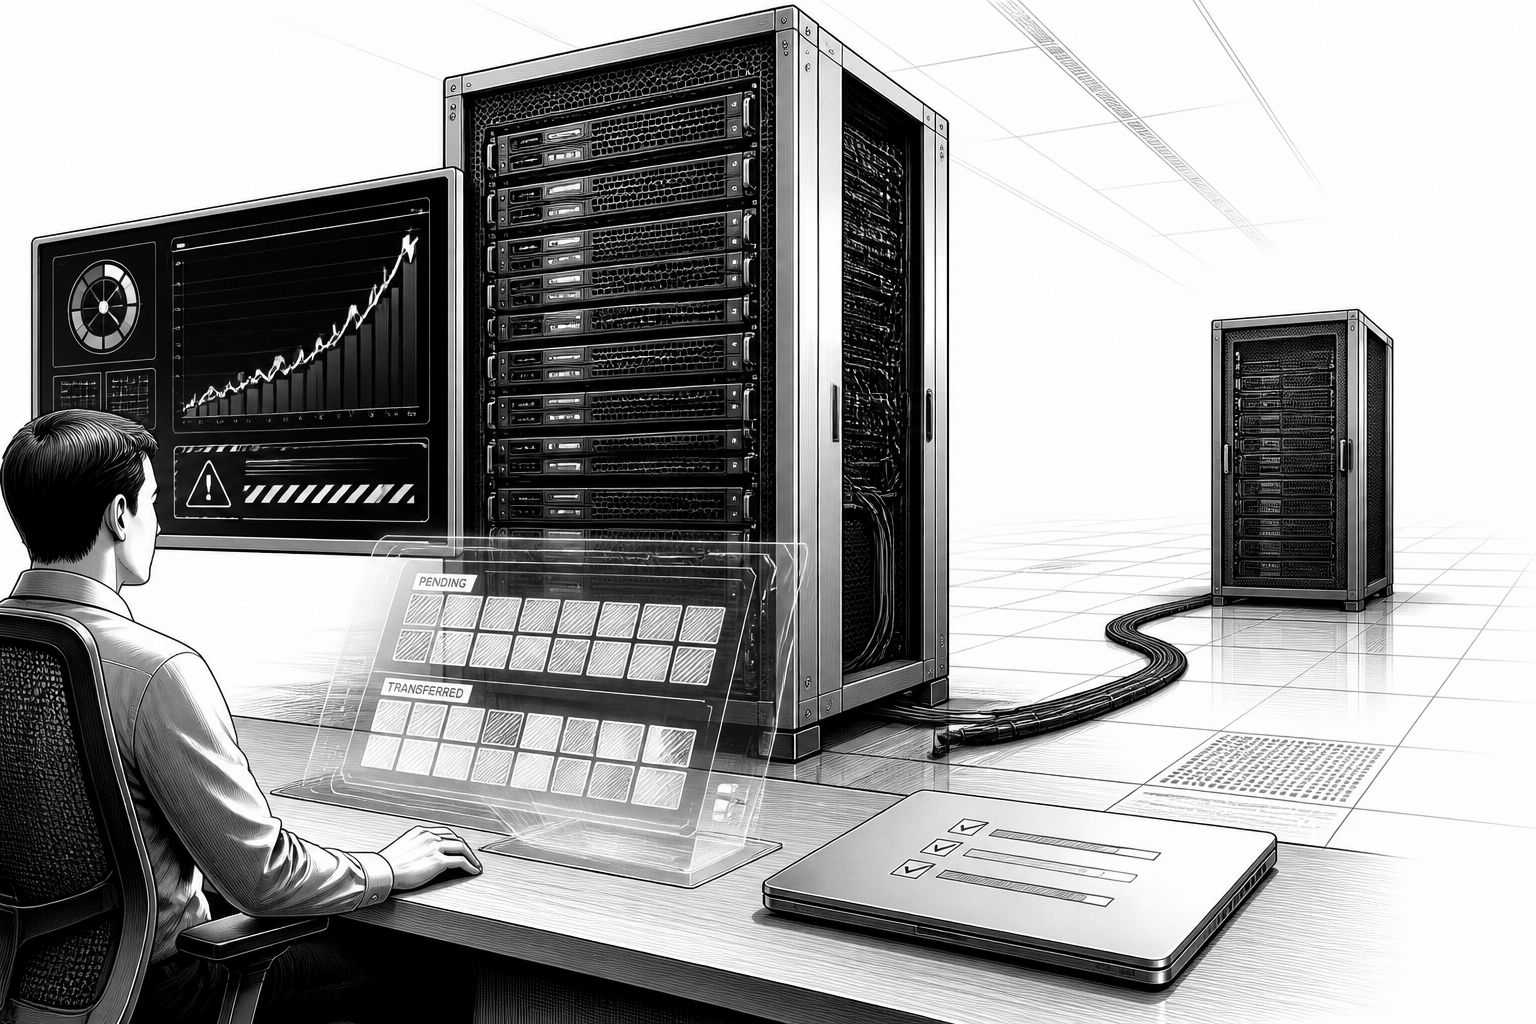
Bei der Bereitstellung von GLM-5.3 über eine disaggregierte Inferenzarchitektur ist im Zeitraum vom 27. August bis zum 9. September 2026 ein konkretes Sicherheitsproblem sichtbar geworden: In einzelnen Fällen enthielten Antworten Inhalte aus kurz zuvor verarbeiteten Anfragen anderer Nutzer. Der Vorfall betraf nach den Angaben der Betreiber genau 155 Responses, und zwar bei Prompts, die länger als 681.280 Tokens waren. Entscheidend ist dabei nicht nur die Zahl, sondern das Muster: Es handelte sich um ein Querschnittsproblem zwischen Requests desselben Modells, also ein typisches „Cross-request“-Fehlverhalten in der KV-Cache-Verarbeitung.
Technisch betrachtet drehte sich alles um die Frage, wem bestimmte KV-Cache-Seiten im Speicher wirklich gehören und wie sie zwischen Prefill und Decode weitergereicht werden. Im beschriebenen Setup arbeitet Workers AI mit SGLang in einer Architektur, in der Prefill-GPUs den Prompt verarbeiten, die benötigten Key-Value-Daten erzeugen und diese dann über RDMA (unter Nutzung von Mooncake) an Decode-GPUs übergeben. Auf den GPU-Seiten liegt dabei ein Pool aus festen KV-Cache-Seiten, der aus Performancegründen nicht zwischen Requests konsequent „zeroed“ wird; stattdessen überschreibt der nächste Request die Seiten. Das bedeutet: Die Engine muss Ownership und Lebensdauer der Seiten zuverlässig nachführen, sonst liest Decode im schlimmsten Fall alte Seiteninhalte.
Der Auslöser bestand aus zwei überlappenden Schwächen. Erstens lag eine Konfigurationsabweichung vor: GLM 5.3 wurde mit einem Kontextfenster von 1.048.576 Tokens gestartet, doch der KV-Cache-Pool auf den Prefill-GPUs hatte nur Platz für 681.280 Tokens. Obwohl diese Diskrepanz vor dem Launch erkannt worden sein soll, wurden die Betreiber offenbar nicht durch Output-Kohärenz-Tests alarmiert, sondern vor allem über HTTP-Statuscodes und Benchmark-Streaming beruhigt. Genau hier kommt die zweite Schwäche ins Spiel: In SGLang kam es in disaggregated prefill/decode dazu, dass ein überlanger Request zwar intern als „rejected“ markiert wurde, aber dann nicht sauber am Handoff scheiterte.
Die Konsequenz beschreiben die Betreiber sehr konkret: SGLang ersetzte den Prompt durch einen Ein-Token-Placeholder, führte jedoch die KV-Cache-Erzeugung und -Übergabe so weiter, dass der Decode-Node nach Erhalt eines „transfer complete“-Signals annahm, die vollständigen KV-Seiten seien für diesen Request neu geschrieben worden. Tatsächlich blieb die Mehrheit der Seiten aus früheren Requests unberührt. Decode reservierte im beschriebenen Ablauf die KV-Seiten entsprechend der großen Prompt-Länge, „attendete“ anschließend aber auch auf stale Cache-Seiten, sodass die Antwort für überlange Prompts Daten aus fremden Sessions enthalten konnte. Da die betroffenen Requests wiederholt eine Art von Nicht-Abbruch-Pfad durchliefen, erklärt sich auch, warum das Verhalten zu einer systematischen Exposition wurde, statt nur zu seltenen Timing-Fehlern zu führen.
Die unmittelbare Remediation folgte deshalb einem doppelten Ansatz: Erstens wurde die Konfiguration so angepasst, dass der KV-Cache-Pool zur Kontextlänge passt. Dazu stellten die Betreiber die GLM-5.3-Konfiguration auf die Logik um, die zuvor bei GLM 5.2 genutzt wurde, wodurch der Pool auf etwa 2,04 Millionen Tokens erweitert wurde. Damit gilt: Ein Prompt, der in das 1.048.576-Token-Kontextfenster passt, passt dann auch immer in den KV-Pool, wodurch die problematische Ablehnungsroute bei gültigen Requests nicht mehr betreten wird. Zweitens wurde die Engine-Funktionalität gehärtet, sodass sich ein „fragiles“ Vertrauen auf Poolgröße allein nicht mehr lohnt; die Ablehnung musste sicherstellen, dass der Request schon an der Admission Queue im disaggregierten Modus zurückgezogen wird, bevor Bootstrap, Allocation und KV-Transfer stattfinden.
Als Teil dieser Engine-Fix-Strategie wurden auch Upstream-Änderungen adressiert und mit konkreten Patch-Nummern untermauert. Die Betreiber verweisen auf eine vorgeschlagene Upstream-Änderung (#38704) und darauf, dass entsprechende Korrekturen bereits auf SGLang main in früheren PRs enthalten gewesen seien, aber zur Zeitpunkt des Vorfalls noch nicht in einer veröffentlichten Version für alle Operatoren ankam. Um das Risiko weiter zu reduzieren, werden zusätzliche Härtungen entlang der typischen KV-Cache-Risiken beschrieben: verzögerte Freigaben, Schranken für Transfer-Batches sowie Checks, die Decode-übertragenes Material verifizieren. Interessant ist dabei die strategische Logik: Die Betreiber behandeln das konkrete Leck nicht als Einzelfall, sondern als Vertreter einer Bug-Klasse, bei der eine Seite freigegeben, wiederverwendet oder zu früh gelesen wird, ohne dass ein anderer Teil der verteilten Ausführung die Ownership-Ansprüche korrekt „kennt“.
Für den Markt und Betreiber disaggregierter Inferenzsysteme ist das vor allem eine Erinnerung an eine bislang oft unterschätzte Lücke zwischen „Model Capacity“ und „Engineering Capacity“. Ein Kontextfenster, das sich nur als Model-Konfiguration verstehen lässt, muss im Betrieb gegen die tatsächliche KV-Pool-Größe, die Quantisierung, Tensor-Parallelism und Speicher-Constraints geprüft werden; andernfalls reichen bereits scheinbar harmlose Annahmen über „Fehlerpfade“ oder Response-Statuscodes. Zugleich zeigt der Fall, warum Integritätssignale auf Protokollebene wichtiger werden: Die Betreiber beschreiben eine geplante stärkere „Integrity by construction“-Ausrichtung, bei der KV-Seiten mit Tags versehen und beim Lesen gegen erwartete Tags verifiziert werden sollen. Bis diese breite Modellabdeckung in Produktion greift, bleibt v0.5.22 (oder ein gleichwertiges Backport-Set) als praktische Leitplanke besonders relevant, weil sie die Ablehnungs- und Transferpfade so absichert, dass überlange Requests nicht mehr ungewollt in fremde Cache-Kontexte „durchrutschen“ können.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "GLM-5.3 auf Workers AI: KV-Cache-Leck durch falsches SGLang-Prefill-Handling behoben" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "GLM-5.3 auf Workers AI: KV-Cache-Leck durch falsches SGLang-Prefill-Handling behoben" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »GLM-5.3 auf Workers AI: KV-Cache-Leck durch falsches SGLang-Prefill-Handling behoben« bei Google Deutschland suchen, bei Bing oder Google News!