
LONDON (IT BOLTWISE) – Ein KI-gestütztes Projekt macht aus Millionen Hacker-News-Kommentaren ein kuratiertes Bücherregal. Der Ansatz basiert auf einer mehrstufigen Pipeline: erst werden Buchverweise per Regex aus Kommentaren herausgefiltert, dann extrahiert ein KI-Modell konkrete Titel- und Zitatstellen, anschließend klärt Open Library die bibliografische Zuordnung. In der Praxis dauerte der komplette Durchlauf knapp 2,5 Stunden, wobei der Löwenanteil nicht in der Codierung, sondern in API-Aufrufen, Rate-Limits und Datenauflösung floss.
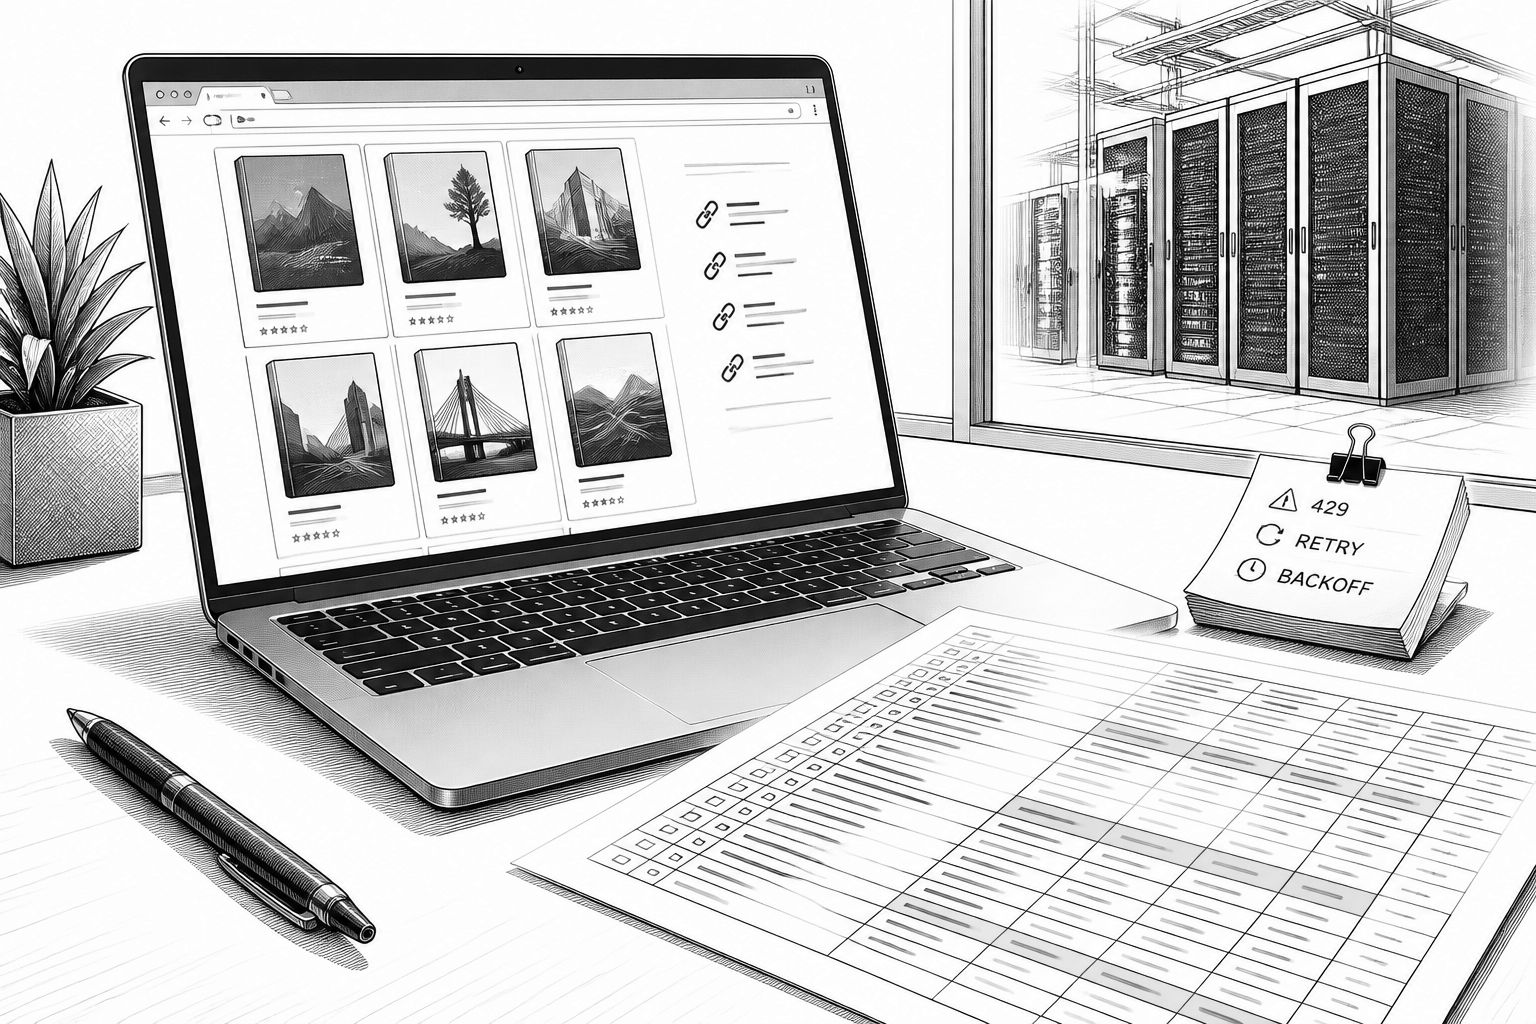
Wer Hacker News über längere Zeit liest, merkt schnell: Hinter einzelnen Kommentarthreads steckt oft eine Art inoffizielles Leselisten-Archiv. Genau diesen Effekt nutzt ein KI-gestütztes Projekt, das aus über 9,4 Millionen Kommentaren eine handfeste Auswahl von Büchern ableitet. Die Idee stammt aus einem ähnlichen Pipeline-Gedanken für Videorempfehlungen, adaptiert auf Bücher. In der hier beschriebenen Umsetzung steht am Ende kein “Chat mit dem Modell”, sondern ein statisches Online-Regal: Es gruppiert Titel nach Kategorien, verlinkt jede Nennung zurück auf die ursprünglichen Kommentare und liefert pro Buch eine Kuratierung aus wiederkehrenden Empfehlungen.
Technisch beginnt die Arbeit nicht beim großen Modell, sondern bei der Datenhygiene. Als Quellmaterial dienen Hacker-News-Kommentare aus einem definierten Zeitraum (Jan 2024 bis Aug 2026). In einer ersten Vorfilter-Stufe werden Buchhinweise per DuckDB-Regex aus dem offenen Dataset “open-index/hacker-news” herausgezogen. Dabei wird nicht nur auf typische Linkmuster geachtet – etwa zu Amazon, Goodreads, Open Library, Bookshop sowie ISBNs oder Verlag/Store-Begriffen wie O’Reilly, Manning, PragProg und No Starch – sondern auch auf semantisch orientierte Textphrasen wie “must read”, “worth a read” oder “book called”. Dadurch sinkt die Kandidatenmenge drastisch: Von mehreren hunderttausend potenziellen Treffern landet man bei 11.519 verbliebenen Kandidaten, was den späteren LLM-Aufwand überhaupt erst praktikabel macht.
Im nächsten Schritt übernimmt Künstliche Intelligenz die eigentliche Extraktion. Die Umsetzung verwendet dafür ein Modell der Gemini-Familie (“gemini-3.5-flash-lite”), das in 288 Batches zu je 40 Elementen arbeitet und dabei 6.076 Buchnennungen aus den Kandidaten hervorholt. Diese Roh-Ergebnisse sind allerdings noch unvollständig: Nicht jeder Link entspricht automatisch einem eindeutig identifizierbaren Werk. Deshalb folgt eine Auflösungsphase (“Resolve”), in der Open Library als bibliografische Referenz genutzt wird. Aus den 6.076 Nennungen werden 2.212 Werke gematcht; danach greift ein Qualitätsfilter, der sich eng an der Grundidee orientiert: Ein Buch bleibt nur dann im Regal, wenn es von mindestens drei unterschiedlichen Personen in mindestens drei verschiedenen Monaten empfohlen wurde. So schrumpft die Auswahl auf 151 Bücher – die später auch die Anzahl der “Card”-Erstellungen bestimmt.
Damit ist das kuratorische Kernproblem aber noch nicht gelöst, sondern nur auf das letzte Detail zugespitzt: Präsentation und Nachvollziehbarkeit. Für jedes der 151 Bücher wird jeweils eine eigene KI-Karte erstellt, und insgesamt entstehen so 151 KI-Karten, 723 Nennungen und 601 eindeutige Empfehlende. Die Seite selbst wird als statische Anwendung realisiert, ausgeliefert über GitHub Pages – ein Ansatz, der die Laufzeitkosten im Betrieb minimiert und die Datenintegrität vereinfacht, weil die Inhalte nach dem Build “stehen”. Interessant ist außerdem, dass der Projektansatz nicht nur “zusammenfasst”, sondern Transparenz einfordert: Jede Nennung im Bücherregal verlinkt zurück auf den konkreten Hacker-News-Kommentar, wodurch die Kuratierung überprüfbar bleibt.
Die Zeitachse zeigt besonders deutlich, wo Projekte dieser Art real Zeit verlieren. Zwar lässt sich der Code für die Pipeline in kurzer Zeit bauen – in der beschriebenen Version dauerte das Cursor-basierten Implementieren des Pipelineskripts inklusive Site- und Deploy-Setup rund 40 Minuten. Der Rest der 2,5 Stunden entfällt auf das, was im Produktivalltag fast immer den Takt vorgibt: API-Aufrufe, Wartezeiten und Rate-Limits. Die Extraktion mit Gemini beanspruchte ungefähr 20 Minuten; die bibliografische Auflösung und das anschließende Filtern durch Open Library dauerten dagegen etwa 44 Minuten und waren damit der langsamste Block. Auch die Kostenlogik erklärt das Ergebnis pragmatisch: Die KI-Extraktion lief im beschriebenen Fall auf einer freien Gemini-Stufe für die Tokens, dennoch wurden 429-Fehler (Rate-Limit) über Backoff und Retry abgefedert. Damit wird klar: Schnelligkeit entsteht nicht allein durch “schnelle Modelle”, sondern durch ein Pipeline-Design, das die Engpässe antizipiert.
Spannend ist schließlich, wie belastbar die KI-Ergebnisse wirklich sind. Das Projekt berichtet von konkreten Fehlerbildern: In einem ersten Durchlauf wurde versehentlich nur Beispiel-/Placeholder-Daten veröffentlicht; außerdem war ein zu grober Vorfilter anfangs auf rund 392.000 Kommentare “open-end”-artig gerichtet, was auf einer Free-Tier-Logik zu teuer bzw. zu langsam geworden wäre. Ein weiteres Risiko betrifft die Qualität extrahierter Zitate: In der ersten LLM-Extraktion waren 470 der “quotes” nicht wortgenau, weshalb die Umsetzung die Zitate bewusst entwertet hat (sie wurden “geblankt”). Bei der bibliografischen Auflösung offenbarte sich zudem eine Schwäche bei fuzzy Titel-Matches: Ein Top-Eintrag zu “1984 (adaptation)” wurde als Michael-Dearby-Variante statt als Orwells Roman gematcht. Trotzdem liefert eine manuelle Stichprobe eine klare Antwort auf die wichtigste Frage: Beim Abgleich von 10 Büchern und 83 Nennungen gegen die Originalkommentare waren Autorenzuordnung und Zitate in dieser Überprüfung konsistent – die Erwähnung des 1984-Mismatch zeigt aber zugleich, dass man sich auf Automatik allein nicht blind verlassen sollte.
Für Unternehmen und Entwickler mit Blick auf Enterprise-Nutzung lässt sich aus dieser Umsetzung eine klare Lehre ableiten. Erstens funktioniert der “3 Personen, 3 Monate”-Filter nicht als Marketing-Regel, sondern als statistisch robuste Abbruchbedingung gegen Einmal-Empfehlungen und synthetisches Rauschen. Zweitens ersetzt ein KI-Codetool wie Cursor nicht die Datenarbeit: Der eigentliche Aufwand sitzt in Extraktionslogik, Rate-Limit-Strategien, Entitäten-Matching und in manuellen Kontrollpunkten. Drittens lohnt sich ein Sicherheitsnetz bei LLM-Extraktionen, besonders wenn Originaltexte als Zitatbestandteil später Vertrauen erzeugen sollen. Wer so etwas produktiv aufbaut, sollte dem Modell nicht nur “klassifizieren” lassen, sondern auch Mechanismen einziehen, die Abweichungen gegenüber Quelltexten messbar machen – genau deshalb bleibt die Verlinkung zu den Originalkommentaren hier ein zentraler Bestandteil der Lösung.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "KI-gestützte Kuratierung: Von Hacker News zu einem Bücherregal in 2,5 Stunden" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "KI-gestützte Kuratierung: Von Hacker News zu einem Bücherregal in 2,5 Stunden" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »KI-gestützte Kuratierung: Von Hacker News zu einem Bücherregal in 2,5 Stunden« bei Google Deutschland suchen, bei Bing oder Google News!