
LONDON (IT BOLTWISE) – Sprachmodelle können nach MIT-Angaben nicht nur Texte verarbeiten, sondern auch Gewichte neuronaler Netze gezielt auslesen und verändern. In Experimenten mit Atari-Klassenmodellen sagten sie bereits aus der Struktur und den Gewichten korrekt voraus, welches Spiel dahintersteckt. Zudem passten sie problematische Parameter eines mathematisch schwächeren Modells so an, dass der MATH-500-Test von acht Prozent auf 48,1 Prozent steigt. Das Konzept verspricht perspektivisch weniger Trainingsaufwand bei gleich besseren Ergebnissen.
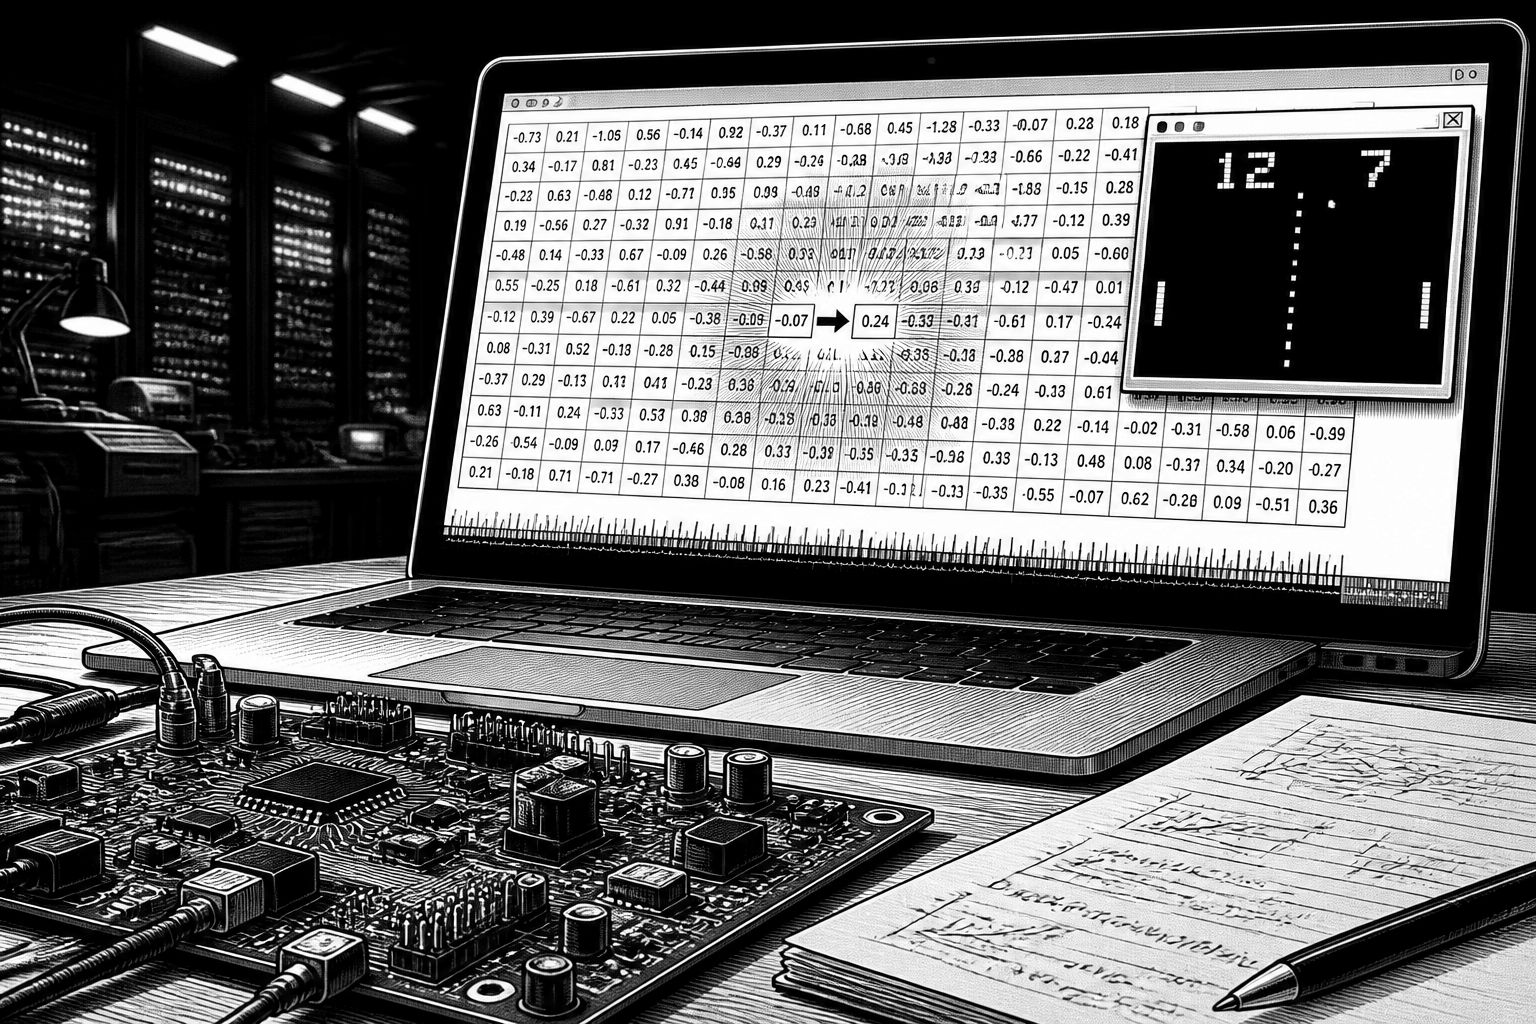
Der Engpass beim Training großer KI-Modelle ist selten das „Erfinden“ neuer Architekturen – er liegt vielmehr darin, dass das Innenleben neuronaler Netze für Außenstehende praktisch unlesbar bleibt. Sprachmodelle funktionieren dann zwar erstaunlich zuverlässig, doch die Frage „Warum reagiert das Netz so?“ lässt sich im Alltag kaum beantworten. Genau an dieser Stelle setzen die nun beschriebenen Experimente an: Statt die Blackbox zu akzeptieren, nutzen die Forschenden Künstliche Intelligenz, um Teile des Gewichtsraums selbst zu analysieren und zu optimieren.
Technisch berührt das Vorgehen einen Kernmechanismus moderner Netze: Neurone liefern Rechenwerte, Synapsen gewichten diese Signale mit Zahlen, den sogenannten Gewichten. Diese Gewichte starten als freie Parameter und werden während des Trainings so angepasst, dass die Vorhersagen mit den Zielvorgaben zusammenpassen. Je mehr Gewichte ein Modell besitzt, desto schwerer wird die Interpretation, weil Änderungen in vielen Parametern zusammenwirken. Die Studie argumentiert deshalb, dass es nicht zwingend Menschen sind, die die relevanten Parameter finden müssen, sondern dass Modelle ihre eigenen Ableitungen aus den Gewichten ableiten können – und damit potenziell gezielter statt „brutal“ durch riesige Trainingsläufe vorgehen.
Im ersten Test nutzten die MIT-Informatiker ein Sprachmodell-gestütztes Verfahren mit dem GPT-6 Astra-Modell als Ausgangspunkt. Sie gaben kleineren neuronalen Netzen, die bestimmte Atari-Spiele wie Pong oder Pac-Man beherrschten, sowohl Strukturinformationen als auch die zugehörigen Gewichte. Ziel war dabei, aus genau diesen Signalen abzuleiten, auf welches Spiel das Netz spezialisiert ist. Das Modell konnte die Zuordnung in allen Fällen korrekt treffen – ein Hinweis darauf, dass sich Spiel-spezifische Rechenmuster offenbar in den Parameterstrukturen „materialisieren“ und nicht nur im Verhalten bei Eingaben.
Besonders auffällig wird es beim zweiten Schritt: Hier erhielten die Forschenden statt der reinen Gewichte die Spielregeln und den Code für Breakout und ließen das Sprachmodell ein passendes neuronales Netz entwerfen. Danach verglichen sie das Ergebnis mit einem klassischen Trainingsalgorithmus, der über mehr als 500 Millionen Schritte trainiert wurde. In der Darstellung erreichen die Netze im Astra-Setup ohne dieses umfangreiche Training und ohne zusätzliche Hilfsmittel deutlich höhere Werte; die Studie nennt dabei eine Größenordnung von „20-mal“ besser. Der Kern der Interpretation lautet: Das Modell nutzt seine Schlussfolgerungsfähigkeit, um zu erkennen, was jeder Teil des Netzes berechnet, und passt die Gewichte entsprechend an – also eine Art parameterbezogene Rekonfiguration statt langer Optimierungsschleifen.
Im dritten Experiment ging es darum, ob das Prinzip auch bei realen Fehlerbildern in großen Modellen funktioniert. Dazu griffen die Forschenden auf das frei verfügbare Qwen3.5-0.8B von Alibaba zurück, das in bestimmten mathematischen Aufgaben in Endlosschleifen geriet und keine Antwort fand. Astra sollte hier nicht das gesamte Modell neu trainieren, sondern die Gewichte identifizieren, die diese Fehlzustände auslösen. Nach den Anpassungen verbesserte sich das Ergebnis bei MATH-500: Das modifizierte Modell löste 48,1 Prozent der Aufgaben, während das ursprüngliche Modell bei acht Prozent lag. Gerade die deutliche Lücke macht klar, dass „Interpretierbarkeit durch gezielte Parameterkorrektur“ nicht nur ein akademisches Prinzip ist, sondern unmittelbar messbare Auswirkungen auf Testleistung hat.
Damit verschiebt sich auch der Blick auf die Ressourcenfrage in der KI-Entwicklung. Wenn Gewichte statt über monatelange Trainingsphasen über modellgestützte Schlussfolgerung nativ angepasst werden können, könnte sich der Aufwand verschlechtern – oder eben deutlich verbessern: weniger Rechenzeit, weniger wiederholtes Durchlaufen großer Datenmengen und damit potenziell ein effizienterer Weg zu besseren Ergebnissen. Die Replikation der Ergebnisse über das Open-Source-Netzwerk Hugging Face unterstützt zudem die praktische Anschlussfähigkeit, weil sich das Vorgehen dadurch eher in bestehende Workflows integrieren lässt. Für Unternehmen und Teams, die KI-Produkte betreiben, wäre das vor allem dann relevant, wenn sich Trainingsfenster und Kosten pro Iteration reduzieren lassen – ohne auf die Qualitätssteigerungen zu verzichten, die man bisher meist nur über massives Wiederholen von Training und Feinabstimmung erreicht.
Industrieseitig passt die Richtung in eine breitere Bewegung: weg von reinen „Daten plus Gradientenabstieg“-Pipelines, hin zu Verfahren, die Modelle als Werkzeug zum Verstehen und gezielten Korrigieren anderer Modelle einsetzen. Genau hier liegt die Chance, aber auch die offene Frage: Wie robust skaliert das Gewichts-Reading bei anderen Architekturen, anderen Aufgabenklassen und größeren Parameterzahlen? Die Studie deutet an, dass dies eine gängige Praxis der Zukunft werden könnte – nämlich wenn Gewichte neuronaler Netze zunehmend durch Sprachmodelle optimiert werden, die explizit über ihre Gewichte nachdenken. Für die nächsten Schritte wird entscheidend sein, wie stark sich der Ansatz auf unterschiedliche Domains übertragen lässt und wie gut er mit den üblichen Anforderungen an Stabilität, Wiederholbarkeit und Evaluationsdisziplin im Produktivbetrieb zusammenspielt.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "KI-Modelle optimieren KI-Modelle: Sprachmodelle lesen Gewichte gezielt aus" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "KI-Modelle optimieren KI-Modelle: Sprachmodelle lesen Gewichte gezielt aus" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »KI-Modelle optimieren KI-Modelle: Sprachmodelle lesen Gewichte gezielt aus« bei Google Deutschland suchen, bei Bing oder Google News!