
LONDON (IT BOLTWISE) – Modder haben offenbar künstliche FP16- und BF16-Berechnungsgrenzen bei GeForce RTX 20-, 30- und 40-Serie entfernt. Dadurch steigt die Tensor-Core-Leistung in bestimmten Workloads teils nahe an eine Verdopplung, während Gaming-Performance und Speicherbandbreite unverändert bleiben. Für lokale KI-Anwendungen werden in der Praxis Zuwächse gemessen, die je nach Software deutlich schwanken. Gleichzeitig sind die Änderungen nicht garantiert, können das Booten verhindern und machen die Garantie nach Angaben der Projekte praktisch unwirksam.
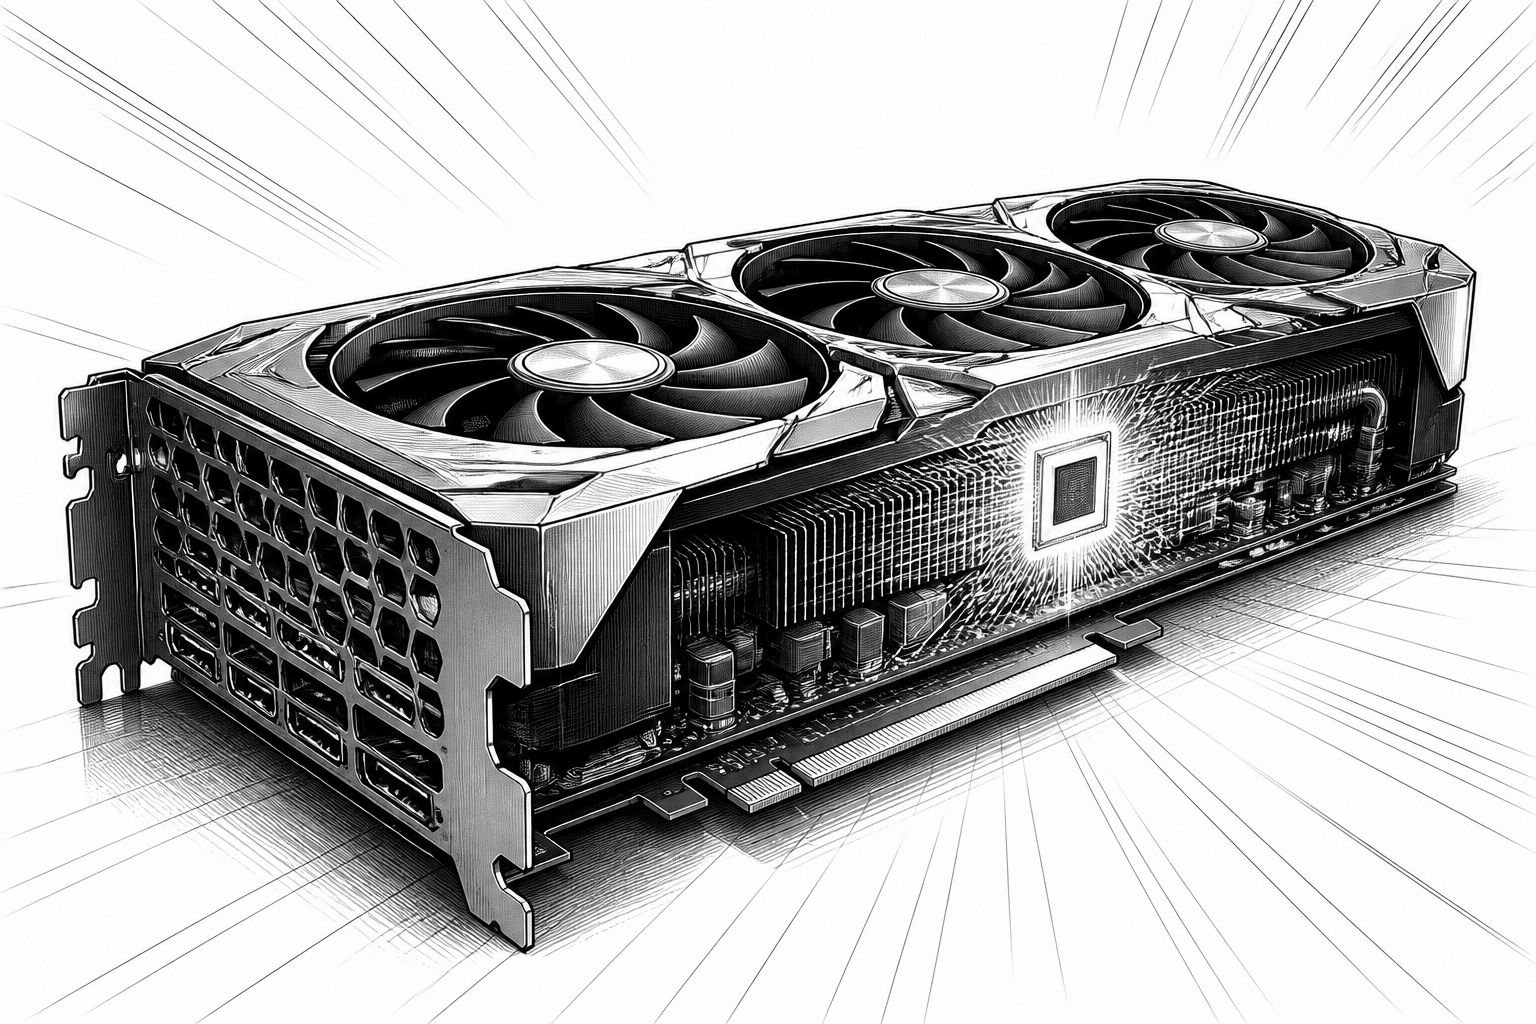
Die Meldung klingt zunächst nach Basteltrieb, hat für KI-Workloads aber einen klaren technischen Kern: Modder sollen FP16- und BF16-Compute-Limits auf GeForce RTX 20-, 30- und 40-GPUs aufgehoben haben, wodurch bestimmte Tensor-Core-Operationen deutlich schneller getaktet werden können. Der zentrale Punkt ist dabei weniger “mehr Leistung um jeden Preis”, sondern die Frage, wie NVIDIA die Ausführung bestimmter Instruktionen auf Consumer-Karten drosselt. Genau dort setzen die Tools an: Sie greifen offenbar in niedrigrangige Registerwerte ein, noch bevor der reguläre NVIDIA-Treiber im Betrieb die Steuerung übernimmt. Das verspricht im Vergleich zu Treiber-Patches und VBIOS-Flash eine schnellere, aber auch eher “flüchtige” Änderung, die beim Power-Cycle wieder verschwindet.
Technisch lässt sich das Prinzip so einordnen: Auf RTX 30 (“Ampere”) sollen die Unlocks die Ausgabe- bzw. Issue-Rate für FP16- und BF16-Operationen mit FP32-Akkumulation nahezu verdoppeln. Im selben Atemzug werden konkrete Messwerte genannt, die das Ausmaß für einzelne Karten belegen sollen. Bei einer RTX 3090 Ti wird etwa berichtet, dass FP16 bei der jeweiligen 450-W-Grenze von 87,46 TFLOPS auf 118,39 TFLOPS steigt; für BF16 werden 87,50 auf 157,41 TFLOPS angegeben. Bei TF32 werden sogar 42,58 auf 82,61 TFLOPS genannt. Für die RTX 40 (“Ada Lovelace”) beschreibt die gleiche Story eine zweite, separate Projektlinie, die FP16/BF16-Tensor-Throughput ebenfalls verdoppeln soll; als Beispiel wird die RTX 4090 von 165,6 auf 331,6 TFLOPS geführt. Die RTX 20 (“Turing”) schließlich sei angeblich mit derselben Technik ebenfalls unlockbar, dort wird für eine RTX 2080 Ti ein Anstieg von 59,9 auf 111 TFLOPS genannt.
Was diese Zahlen von einer “reinen TFLOPS-Anzeige” unterscheidet, ist die Abgrenzung zu typischen Gaming-Effekten: Die Unlocks sollen keine zusätzlichen Hardware-Ressourcen wie mehr Speicherbandbreite oder mehr CUDA-Kerne freischalten, und sie sollen auch keine belegbaren Effekte für DLSS liefern. Damit verschiebt sich die Erwartungshaltung: Es geht nicht um höhere Frames pro Sekunde, sondern um Workloads, bei denen das Modell- oder Inferenz-Setup stark von Tensor-Core-weitgehendem FP16/BF16-Computing und entsprechender Batching/Kernel-Ausführung abhängt. Historisch knüpft die Entwicklung zudem an frühere Unlocks für NVIDIA CMP-Mining-GPUs an; für RTX 30 soll ein Entwickler-Ansatz aus einem Open-Source-Projekt namens “GPU Unlock” für die Consumer-Generation adaptiert worden sein. Auch wenn das konzeptionell “wiederverwendet” klingt, bleibt die praktische Frage, wie stark sich die theoretische Issue-Rate-Drehzahl in echten End-to-End-Pipelines niederschlägt.
In der Praxis variieren die Gewinne deshalb deutlich. Für ein Beispiel-Setup mit einer RTX 3090 Ti und ComfyUI wird von etwa 56% bis 59% höherem Durchsatz bei BF16-Image-Modellen gesprochen, während INT8 kaum messbar zulege. Bei lokalen Sprachmodellen (LLMs) werden für Prompt-Verarbeitung Zuwächse in der Größenordnung von etwa 14% bis 36% genannt; die Token-Generierung bleibt hingegen laut Darstellung weitgehend unverändert. Der Grund liegt in der Engpassanalyse: Token-Generierung werde hier offenbar stärker von der Speicherbandbreite und/oder dem Speicherzugriff limitiert als von der Tensor-Core-Ausführungstaktung. Genau damit lässt sich auch die eingangs erwähnte Begrenzung erklären: Wenn die Unlocks die Issue-Rate bestimmter Tensor-Core-Operationen erhöhen, aber die Speicherseite nicht “mitdreht”, dann verbessert sich vor allem der Teil der Pipeline, der tatsächlich rechenintensiv im FP16/BF16-Quadranten bleibt.
Für Unternehmen und Entwickler ergibt sich daraus ein zweigeteiltes Bild. Auf der einen Seite ist der Marktimpuls real: Wenn Consumer-RTX-Karten in bestimmten KI-Szenarien näher an das heranrücken, was sonst eher professionelle Karten liefern, sinken für Einzelentwickler oder Teams in kleinen Labs die Kosten pro Experiment. Auf der anderen Seite ist die Umsetzung nicht als “Knopf drücken und fertig” zu betrachten. Die Änderungen sollen laut Quelle teilweise nicht auf jedem System garantiert funktionieren; es wird sogar ein Fall genannt, in dem bei einer RTX 3080 Ti mit 20GB keine BF16-Gewinne zu beobachten gewesen seien. Zudem können “unsupported setups” Probleme beim Booten verursachen. Besonders relevant ist auch die Plattformlage: Die Projekte richten sich demnach vor allem auf Linux; eine experimentelle Windows-Variante wird zwar erwähnt, aber mit einem einzelnen Beispielwert (für eine RTX 3090 werden 82,5% BF16-Gewinn berichtet) statt breiter Konsistenz.
Ein weiterer Faktor ist die Risiko- und Betriebsseite. Jede GPU-Modifikation kann die Garantie in der Praxis ausschalten; das wird in der Meldung ausdrücklich als mögliche Konsequenz genannt. Außerdem bleiben die Änderungen temporär, weil die Registeranpassungen offenbar nach dem Abschalten verloren gehen. Für produktive Umgebungen heißt das: Wer solche Unlocks einsetzt, muss ein sauberes Betriebsmodell für Reproduzierbarkeit (inklusive Start-Routinen) schaffen und sollte besonders bei Deployments, die auf stabilen Zuständen beruhen, vorsichtig sein. Gleichzeitig schiebt die Story den Blick Richtung Zukunft: Für die RTX 50 (“Blackwell”) gibt es demnach noch keine bestätigten funktionierenden Unlocks. Damit ist die Botschaft weniger “alle Karten sind sofort frei”, sondern “es existieren Wege, die Rechenpfade in ausgewählten Workloads zu entkoppeln” – mit Nutzen, aber auch mit klaren Grenzen bei Speicherbindung, Softwareabhängigkeit und Systemstabilität.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Modder schalten FP16/BF16-Limits bei GeForce RTX frei – mehr KI-Throughput" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Modder schalten FP16/BF16-Limits bei GeForce RTX frei – mehr KI-Throughput" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Modder schalten FP16/BF16-Limits bei GeForce RTX frei – mehr KI-Throughput« bei Google Deutschland suchen, bei Bing oder Google News!