
REDMOND / LONDON (IT BOLTWISE) – Eine stundenlange Störung traf Microsofts Cloud-E-Mail und weitere Microsoft 365-Dienste und bremste damit Kommunikation und Zusammenarbeit. Besonders betroffen waren Exchange-Mailboxen in den USA; anschließend warnte Microsoft vor möglichen Auswirkungen weltweit. Der Konzern versuchte, den Datenverkehr an problematischen Servern vorbeizuleiten, stellte außerdem Prozesse auf betroffenen Systemen fest und isolierte Teile der Infrastruktur. Wie lange die Probleme dauern würden, blieb zeitweise unklar.
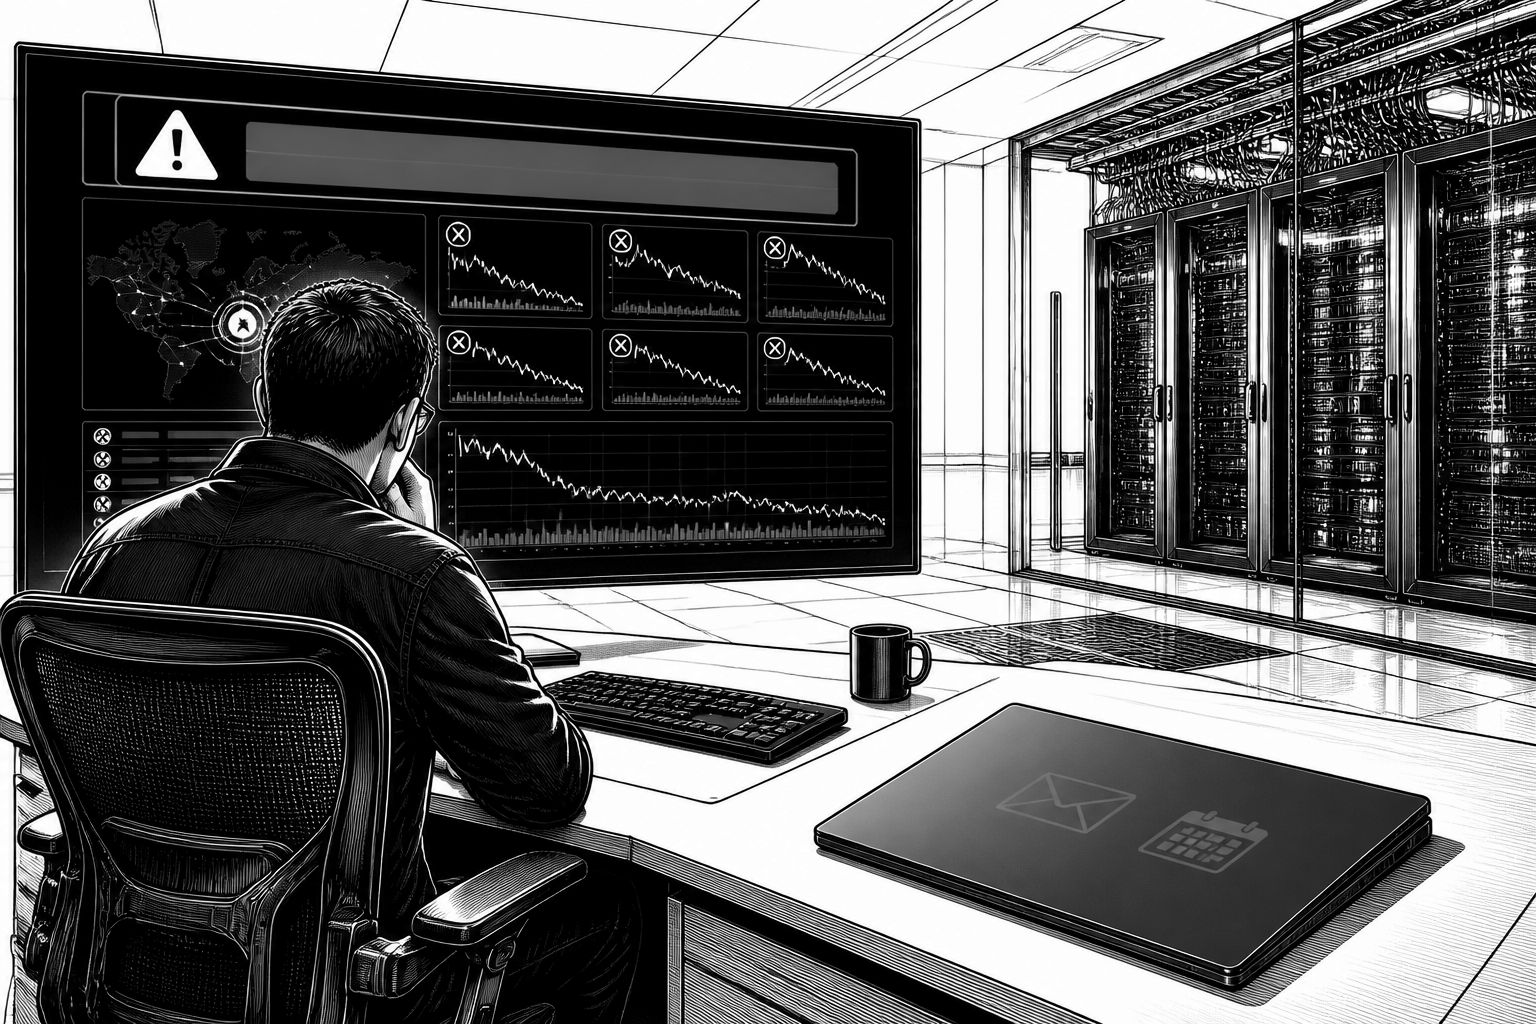
Bei Microsofts Cloud-Angeboten ist der nächste Betriebsstopp zur Realität im Unternehmensalltag geworden: Während viele Organisationen und Verbraucher auf den E-Mail-Dienst Outlook sowie weitere Microsoft-365-Komponenten angewiesen sind, fiel über Stunden hinweg eine ganze Reihe von Funktionen aus. Laut dem Vorfallbild kamen zunächst Exchange-Mailbox-Probleme in den USA an die Öffentlichkeit, bevor der Softwarekonzern den Kreis potenziell betroffener Nutzer ausdehnte und dabei einen weltweiten Einfluss auf den Dienst Microsoft 365 nicht ausschloss. Für die Betroffenen bedeutete das nicht nur verzögerte Kommunikation, sondern teilweise auch eine harte Nutzungsgrenze, weil bestimmte Workflows direkt von der Erreichbarkeit der Cloud-Backend-Dienste abhängen.
Technisch betrachtet wirkt eine solche Störung selten wie ein einzelner „Knopf“, der ausgeschaltet wird. Im beschriebenen Verlauf ging Microsoft von Problemen bei bestimmten Servern bzw. einem „problematischen“ Pfad im Datenverkehr aus, der danach angepasst werden sollte. Das Unternehmen sprach davon, den Datenverkehr an möglicherweise fehleranfälligen Servern vorbeizuleiten. Genau diese Art von Umleitung ist bei Cloud-Diensten gängig: Sie kann kurzfristig die Last auf gesunde Instanzen lenken und die Latenz stabilisieren, allerdings nur dann zuverlässig, wenn das zugrunde liegende Problem tatsächlich an einer klar eingrenzbaren Infrastrukturkomponente hängt und nicht in einem breiteren Abhängigkeitsgraphen (etwa Authentifizierung, Mailbox-Zugriff, Kalender-/Termin-APIs oder nachgelagerte Speicherschichten) sitzt.
Im Büroalltag machte sich das besonders bei Microsoft Teams bemerkbar, weil dort Aufgaben und Arbeitsabläufe an die Kalender-Anbindung gekoppelt sind. Wenn Kalender-Events oder Terminmetadaten aus der Cloud nicht konsistent bereitgestellt werden, schlagen Funktionsketten sofort durch: Aufgaben erscheinen dann nicht, werden nicht sauber aktualisiert oder bleiben in einem fehlerhaften Status hängen. Selbst für Unternehmenskunden, die Copilot einplanen, war der KI-Assistent zum Teil nicht nutzbar. Das ist ein weiterer Hinweis darauf, dass „KI im Frontend“ in der Praxis stark vom Zugriff auf zentrale Services im Hintergrund abhängt: Solange grundlegende Plattformfunktionen instabil sind, können auch die zugehörigen KI-Funktionen nicht zuverlässig antworten.
Microsoft dokumentierte den Incident-Vorschub öffentlich auf der Plattform X und meldete zunächst den Fortschritt bei der Ursachenfindung. Dabei fiel ein Prozess auf, der laut Microsoft auf betroffenen Servern eine Rolle spielte und sie in der Folge „lahmlegte“. Anschließend folgte der nächste Schritt: Ein Teil der Server sollte wieder ans Netz gebracht werden, mit der Erwartung, dass die Systeme stabiler laufen. Genau hier zeigt sich jedoch, wie dynamisch solche Störungen sind. Eine Stunde später musste Microsoft einräumen, dass die Server sich wieder aufhängen könnten, sobald wieder normaler Datenverkehr eintrifft. Diese Kombination aus „erst stabil, dann erneut instabil“ passt typischerweise zu Fällen, in denen Lastmuster oder bestimmte Anfragenstypen erst unter realistischem Traffic die Schwäche sichtbar machen.
Entsprechend wechselte der Konzern die Strategie: Teile der Infrastruktur wurden isoliert hochgefahren, um sie kontrollierter zu testen und den defekten Bereich enger einzugrenzen. Microsoft sprach dabei von „positiven Ergebnissen“, bevor der Rückschlag kam und klar wurde, dass die Maßnahme doch nicht in der erwarteten Weise greift. Solche Iterationen sind in der Incident-Response-Realität häufig, weil zwischen Diagnoseschritten, Cache-/State-Rücksetzungen und dem Wiedereinstieg von Nutzern ein zeitlicher Versatz entsteht: Was im kontrollierten Setup stabil wirkt, kann im Produktionsbetrieb unter typischen Nutzungsprofilen (Login-Raten, Mail-Client-Verhalten, Kalender-Abfragen, Hintergrund-Synchronisation) wieder kippen. Für Unternehmen erhöht das vor allem den Aufwand in der Betriebsplanung, weil man nicht nur einen „Wiederanlauf“, sondern mehrere Stabilitätswellen einkalkulieren muss.
Aus Marktsicht fügt sich der Vorfall in ein Muster ein, das viele Anbieter in der Cloud-Welt zwar kennen, das aber trotzdem jedes Mal spürbar ist: Störungen gehören zum Tagesgeschäft, dauern jedoch im Regelfall nur kurz. In diesem Fall war die Dauer offenbar lang genug, um Kommunikation und Planung spürbar zu beeinträchtigen. Zudem liegt die Erinnerung an einen ähnlichen Ausfall nahe: Microsofts E-Mail-Dienste hatten erst Ende August einen stundenlangen großflächigen Ausfall erlebt, bei dem Nutzer sich über Stunden nicht einloggen konnten und keine Nachrichten senden oder empfangen konnten. Damals nannte Microsoft ein Problem in der Cloud-Infrastruktur. Dass nun erneut ein Vorfall in diesem Umfeld beschrieben wurde, rückt die Frage in den Fokus, wie robust die Systeme gegen bestimmte Fehlerbilder sind und welche Lehren aus früheren Incidents in die Architekturpflege eingeflossen sind.
Für IT-Leitungen und Compliance-Verantwortliche ist dabei vor allem die operative Konsequenz relevant: Wenn Mail, Kalender und Kollaboration zusammenfallen, entsteht schnell ein „Kaskadeneffekt“ über mehrere Produkte hinweg. Neben der unmittelbaren Verfügbarkeit spielen auch Wiederherstellungsmechanismen eine Rolle, etwa wie schnell Clients wieder normal synchronisieren und wie lange Zwischendaten in Warteschlangen oder Caches hängen bleiben. Gleichzeitig zeigt der Verlauf, wie eng moderne KI-Funktionen mit Basisdiensten gekoppelt sind: Selbst wenn das KI-Modell selbst korrekt funktioniert, bleibt die Nutzererfahrung davon abhängig, ob Plattformfunktionen wie Authentifizierung, Datenzugriff und Service-Orchestrierung stabil laufen. Die nächsten Stunden des Vorfalls werden daher nicht nur technisch entscheiden, wann Outlook und Teams wieder zuverlässig arbeiten, sondern auch, wie gut Microsoft im Live-Betrieb mit der Erwartungssteuerung rund um Stabilität kommuniziert.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Störung bei Microsoft 365: Outlook, Teams und Copilot zeitweise nicht verfügbar" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Störung bei Microsoft 365: Outlook, Teams und Copilot zeitweise nicht verfügbar" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Störung bei Microsoft 365: Outlook, Teams und Copilot zeitweise nicht verfügbar« bei Google Deutschland suchen, bei Bing oder Google News!