
LONDON (IT BOLTWISE) – Während der XRP-Ledger-Operationsgruppe die Zustandswechsel im Konsens ungewöhnlich langsam vorkamen, haben Entwickler die Ursachen in der Validator-Infrastruktur untersucht. David Schwartz, Mitgründer von Ripple und ehemaliger CTO, beschreibt dabei vor allem schmaler werdende technische Sicherheitsreserven und zwei Kategorien möglicher Ausfälle. Er betont, dass bisher weder ein gezielter Angriff noch ein versteckter Softwarefehler als Ursache belegt sind. Für Teams, die Validatoren betreiben, rückt damit die Frage nach Monitoring-Resilienz unter Last in den Fokus.
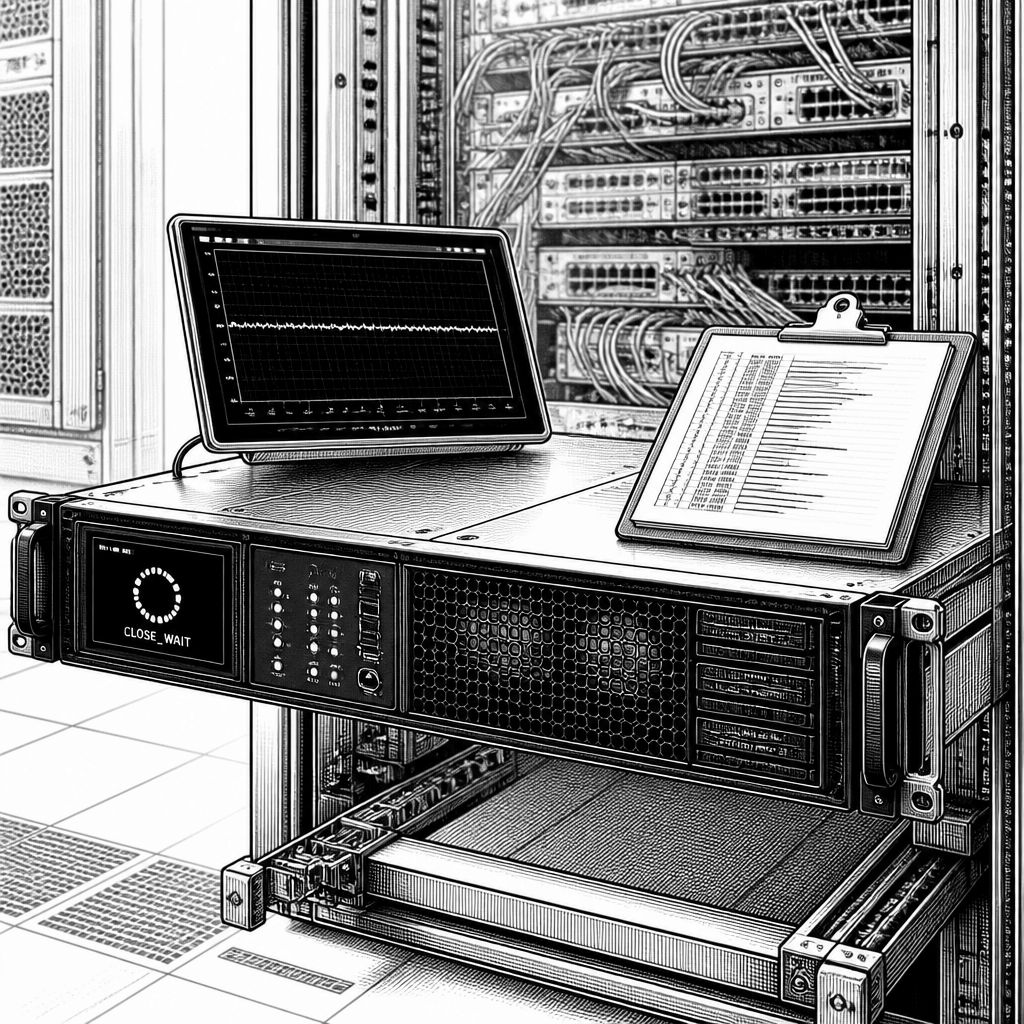
Der XRP Ledger ist während einer Phase verlangsamter Konsensrunden (am 21. Oktober) offensichtlich stärker in Richtung „kritischer Randbedingungen“ geraten als gewohnt. Laut den Schilderungen der beteiligten Ingenieure fielen die Abschlusszeiten von Ledger-Zuständen spürbar, woraufhin ein technisches Debugging-Setup gestartet wurde. David Schwartz, der als Ripple-Mitgründer und ehemaliger CTO eine technische Innenansicht in das System einbringt, ordnet das Ereignis weniger als isolierten Betriebsfehler ein, sondern als Hinweis darauf, dass die sogenannten Safety Margins enger geworden sein können. Genau diese Sicherheitsreserven sollen dafür sorgen, dass Netzwerk- und Protokollannahmen selbst dann halten, wenn einzelne Komponenten unter Stress geraten.
Schwartz hebt dabei zwei breitere Szenarien hervor, die den gesamten Betrieb eines verteilten Ledgers zum Stillstand bringen könnten: Erstens können weitreichende, gleichzeitige Ausfälle über viele Validator-Server hinweg eintreten. Zweitens kann eine Störung in Konsenslogik oder in einer anderen zentralen Protokollfunktion auftreten. Entscheidend ist jedoch die Abgrenzung zur Ursache: In den vorliegenden Angaben ist weder belegt, dass ein gezielter Angriff die Konsensrunden ausbremste, noch ist ein konkreter Softwarefehler als Auslöser identifiziert. Damit wird das Bild eher zu einem Belastungstest für die Betriebssicherheit als zu einem endgültigen „Root Cause“-Bericht.
Besonders praxisnah wird die Analyse an einem Detail, das viele Teams in der Infrastruktur unterschätzen: Monitoring ist selbst dann noch erreichbar, wenn die eigentliche Anwendung gerade am Limit läuft? Im konkreten Fall geriet ein Schwartz-Node unter Peak Load an maximale Auslastung, sodass lokale RPC-Verbindungen in einem CLOSE_WAIT-Zustand „hängen“ konnten. In diesem Zustand konnte das Monitoring offenbar keine Diagnosedaten mehr rechtzeitig erfassen und weiterleiten, gerade dann, als sie gebraucht worden wären. Dass Schwartz danach einen Neustart des Servers durchführte, ist dabei weniger eine spektakuläre Maßnahme, sondern eine Rückfalloption, um den Zustand aus einer Blockade zu lösen und erneut Messwerte zu gewinnen. Der Bericht liefert allerdings keinen eindeutigen Nachweis, welcher Aspekt der Last oder der Netzwerkkommunikation exakt zu diesem CLOSE_WAIT-Profil geführt hat.
Eine zweite Hürde lag im Logging-Setup. Schwartz’ Node habe Logs an einen veralteten Test-Host des XRP Ledger Foundation-Umfelds gesendet. Damit fehlten dem eigentlichen Debugging-Prozess zumindest Teile der „richtigen“ Logausgaben in der erwarteten Zielumgebung; gemeinsam mit dem Monitoring-Ausfall unter Last wurde das Sammeln und Korrelieren von Diagnosedaten zusätzlich erschwert. Wichtig: Diese Fehlleitung der Logziele wird im Bericht nicht als Ursache für die Verlangsamung des Ledgers dargestellt, sondern als Reibungsverlust bei der Ursachenfindung. Genau an solchen Stellen entscheidet sich bei verteilten Systemen die Geschwindigkeit von Incident Response: Nicht nur die Fehler selbst, sondern auch die Observability-Kette vom Prozess bis ins Auswertungssystem muss in Stresstests funktionieren.
Während der Fehleranalyse lief, wurde nach Angaben aus der Community und von Ingenieurteams deshalb manuell in den noch verfügbaren Logs gearbeitet, um einen Defekt einzugrenzen und zu eliminieren. Der Ton ist dabei vergleichsweise beruhigend: Schwartz habe keinen Grund zum sofortigen „Panikmodus“ gesehen und davon ausgegangen, dass das Netzwerk weiterhin genügend Reserve besitzt, um den Betrieb fortzusetzen. Gleichzeitig fehlt eine belastbare Aussage zu einer konkreten Reparaturmaßnahme oder zu einem genauen Zeitplan für Deployments. Für Betreiber von Validator-Setups bedeutet das: Selbst wenn der Ledger weiterarbeitet, kann ein Incident zeigen, welche Zustände in den eigenen Betriebsprozessen unter Last unzureichend beobachtet oder zu spät aufgelöst werden.
Auch der Markt nahm die Meldung wahr: XRP wurde am 21. Oktober zeitweise mit rund 1,36 US-Dollar gehandelt, was im 24-Stunden-Vergleich als deutlicher Anstieg beschrieben wurde. Solche kurzfristigen Kursreaktionen spiegeln häufig weniger die technische Endursache als vielmehr das wahrgenommene Risiko und die Hoffnung auf schnelle Stabilisierung wider. In der Technik betrachtet ist aber vor allem die Konsistenz der Validator-Performance im Zusammenspiel mit Monitoring entscheidend: Wenn RPC-Zustände wie CLOSE_WAIT die Diagnostik blockieren, verlieren Teams die Fähigkeit, aus Messdaten zu lernen. Für Unternehmen, die in der Praxis mit Blockchain-Infrastruktur umgehen (z. B. über eigene Validatoren oder Dienste mit festem Service-Level), lohnt sich deshalb ein Blick auf redundantes Monitoring, klare Log-Zielkonfigurationen und Tests, die Lastspitzen wie im Incident realistisch abbilden.
Rückblickend passt die Episode in eine breitere Entwicklung bei verteilten Systemen: Resilienz ist heute nicht mehr nur eine Frage von Konsensalgorithmen, sondern auch von Betriebsdisziplin. Wer Validatoren betreibt, muss sicherstellen, dass Observability in den gleichen Pfaden läuft wie die eigentliche Kommunikation unter Last. Daneben zeigt der Fall, wie schnell „kleine“ Konfigurationsabweichungen (wie ein veraltetes Logging-Ziel) aus einem normalen Debugging zu einem zähen Datenrekonstruktionsprozess werden. Ob die verlangsamten Konsensrunden letztlich durch einen systemischen Protokollzustand, durch einzelne Validator-Probleme oder durch eine Kombination aus Last und Konfigurationsdetails ausgelöst wurden, bleibt in den vorliegenden Informationen offen; das allein unterstreicht jedoch, wie wichtig belastbare Ursachenanalyse-Ketten für die nächste Betriebsphase sind.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "XRP Ledger-Langsamkeit legt Validator-Risiken offen: David Schwartz" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "XRP Ledger-Langsamkeit legt Validator-Risiken offen: David Schwartz" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »XRP Ledger-Langsamkeit legt Validator-Risiken offen: David Schwartz« bei Google Deutschland suchen, bei Bing oder Google News!