


SILICON VALLEY / LONDON (IT BOLTWISE) – Meta dreht seine Erwartungen rund um KI-Ausgaben: Das Unternehmen stellt eine mögliche Vermarktung eigener Rechenkapazität in Aussicht und führt gleichzeitig das KI-Modell Muse Spark 1.1 ein. Im Markt fällt vor allem das neue Preismodell auf, das Entwickler bei Input und Output-Token spürbar entlasten soll. Parallel kündigt Meta den Ausbau seines Rechenzentrums-Setups an, unter anderem mit einem neuen Standort in Kanada. Für Unternehmen und Entwickler bedeutet das: mehr Preisdruck im Model-Business, aber auch neue Optionen für KI-Infrastruktur.
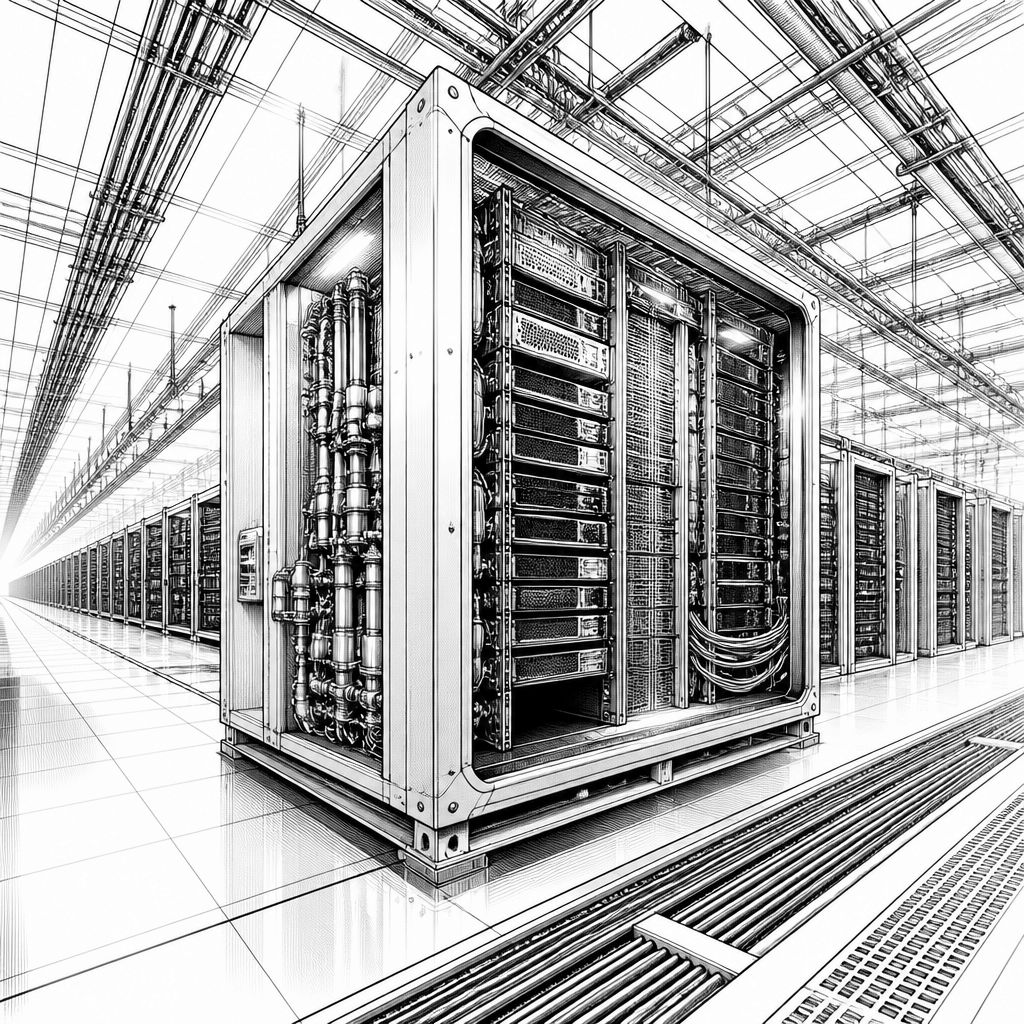
Meta versucht, zwei technische Kostenblöcke gleichzeitig gegenzusteuern: den steigenden Kapitalaufwand fürs KI-Backbone und die Frage, wie sich massive Recheninvestitionen in wiederkehrende Erlöse übersetzen lassen. Nachdem der Kurs am Freitag zeitweise um mehr als 5% zulegte und damit das Jahr über wieder ins Plus drehte, rückte die Strategie des Managements in den Vordergrund. Laut den bekannt gewordenen Aussagen prüft Meta, KI-Computing-Kapazität Dritten anzubieten. Damit würde der Konzern neben der Werbeplattform einen zweiten wirtschaftlichen Hebel erschließen, der auf Inferenz- und Trainingsbedarf reagiert.
Technisch ist der Gedanke naheliegend, aber keineswegs trivial. Ein „Data Center als Produkt“ bedeutet, dass Meta nicht nur Server im eigenen Betrieb bereitstellt, sondern auch die Betriebsprozesse für Lastverteilung, Job-Orchestrierung, Observability und Kapazitätsplanung industrialisiert. Genau diese Schritte entscheiden, ob sich aus Rechenzentren ein servicefähiger Layer für Kunden wird: von SLO-/SLA-Definitionen bis zum Umgang mit Spitzenlasten im Modellbetrieb. Meta kündigte zudem den Ausbau seines Rechenzentrumsportfolios an und plant ein weiteres Zentrum in Kanada als 33. Anlage dieser Art. Für die nächsten Quartale ist daher entscheidend, wie schnell sich solche Kapazitäten in nutzbare „Compute“-Pakete überführen lassen.
Als mögliche Vermarktungsform wird diskutiert, dass Meta entweder eigene Kapazitäten mitsamt der Ausführung von KI-Modellen an Kunden liefert oder Komponenten wie KI-Chips und Serverzugang als „neocloud-nahes“ Angebot bereitstellt. Im Kern läuft das auf einen Vergleich mit etablierten Cloud-Intermediären wie AWS hinaus: Wer ähnliche Services anbietet, muss sich in Sachen Ressourcencapacity, Netzwerk-Performance und Datenanbindung messen lassen. Auch wenn Meta bislang stark als Plattformbetreiber wahrgenommen wird, deutet die Richtung auf eine stärkere Positionierung im Infrastruktur-Wettbewerb hin. Aus historischer Sicht ist das ein vertrautes Muster: In den frühen Cloud-Phasen waren viele Anbieter zunächst Plattform-only, bevor sie später Rechen- und Speicherkompetenz als Service herausstellten.
Der zweite Hebel ist die Preisgestaltung für KI-Entwickler. Mit Muse Spark 1.1 bringt Meta ein neues Modell und veröffentlicht gleichzeitig ein Tokenbasiertes Preisschema. Dabei werden Input- und Output-Token getrennt bepreist: Meta nennt 1, 25 US-Dollar pro 1 Million Input-Token und 4, 25 US-Dollar pro 1 Million Output-Token. Diese Struktur soll die Kosten im Vergleich zu Wettbewerbern wie Anthropic und OpenAI deutlich drücken, insbesondere bei der Output-Bepreisung. In einem „post-tokenmaxxing“-Szenario, in dem nicht nur rohe Modellleistung zählt, sondern auch Grenzkosten pro abgegebener Antwort, kann das Preismodell für Teams mit hohen Nutzer- oder Batch-Volumes besonders attraktiv sein.
Marktseitig verschiebt Meta damit die Wettbewerbslogik zwischen Modellanbietern und Infrastrukturplattformen. Anthropic etwa positioniert seine Modelle gegen hohe Nachfrage mit höheren Tokenpreisen; OpenAI wiederum bleibt für viele Entwickler ein Referenzpunkt bei Tooling, Ökosystem und Systemintegration. Laut der beschriebenen Gegenüberstellung liegt Anthropics Input-Preis für das genannte Modell bei 5 US-Dollar pro 1 Million Input-Token und der Output-Preis bei 25 US-Dollar pro 1 Million Output-Token. Meta adressiert damit vor allem kostenbewusste Teams, die für viele Use Cases nicht zwingend Top-of-the-line-Modelle benötigen. Branchenanalysten ordnen solche Preiskorrekturen meist als Schub für Adoption ein, weil sie Hürden für Prototypen senken und die Wirtschaftlichkeit von KI-Assistenten oder Agentenfällen verbessern.
Gleichzeitig steckt in der Preisdynamik ein strategischer Trade-off. Niedrigere Tokenpreise bedeuten nicht automatisch niedrigere Gesamtkosten für den Nutzer, wenn dafür höhere Latenzen, mehr Prompts oder mehr Re-tries nötig werden. Deshalb wird in der Praxis die Qualität der Modell-Ausgabe, die Stabilität unter Last und die Effizienz der Inferenz in Verbindung mit dem Preismodell bewertet werden. Unternehmen, die bereits mit mehreren Modellanbietern experimentieren, könnten Spark 1.1 als „Kostenanker“ in Multi-Model-Architekturen einsetzen: ein günstigeres Modell für Standard-Workflows, während teurere Modelle für schwierige Fälle reserviert werden. So entsteht ein Komponenten-Mix, der sowohl Budget als auch Performance optimiert.
Aus Regulierungs- und Datenschutzsicht betrifft die Ankündigung besonders die Frage, wo Daten verarbeitet werden und wie strikt Meta die Kundenanforderungen trennt. Sobald ein Anbieter Rechenkapazität für Dritte bereitstellt, müssen technische und organisatorische Kontrollen zusammenpassen: Mandantentrennung, Logging mit Zweckbindung, Lifecycle-Policies für Trainings- oder Fine-tuning-relevante Daten und klare Regeln zum Umgang mit personenbezogenen Informationen. Für viele Enterprise-Kunden sind solche Punkte mindestens so wichtig wie der Tokenpreis. Wer Rechenzentren als Service vermarktet, wird außerdem stärker in Richtung Auditierbarkeit getrieben, etwa durch Nachweise zu Sicherheitsverfahren, Incident Response und Risikoanalysen entlang der Datenflüsse.
In die Zukunft gedacht, deuten die Signale auf einen breiteren Infrastrukturtrend hin: Modellpreise werden stärker fragmentiert, während „Compute als Produkt“ als weiteres Differenzierungsmerkmal in den Vordergrund rückt. Das könnte dazu führen, dass Plattformen wie Meta nicht nur im Model-Layer konkurrieren, sondern auch im Pricing- und Kapazitätsmodell ähnlich agiler Cloud-Anbieter. Für Entwickler ergibt sich daraus eine größere Gestaltungsmöglichkeit bei Kosten und Performance, etwa durch fein granulare Routing-Strategien zwischen Modellen und Inferenzumgebungen. Gleichzeitig wird der Ausbau des Rechenzentrumsnetzes in Kanada und darüber hinaus zur Grundlage für Skalierung: Wer Kapazität früh hochfährt, kann später aggressiver einkaufen oder selektiv weitergeben.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- NIEDLICHER BEGLEITER: Eilik ist der ideale Begleiter für Kinder und Erwachsene, die Haustiere, Spiele und intelligente Roboter lieben. Mit vielen Emotionen, Bewegungen und interaktiven Funktionen.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.




- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Meta öffnet Rechenkapazität für Dritte und senkt KI-Preise: Spark 1.1 im Fokus" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Meta öffnet Rechenkapazität für Dritte und senkt KI-Preise: Spark 1.1 im Fokus" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Meta öffnet Rechenkapazität für Dritte und senkt KI-Preise: Spark 1.1 im Fokus« bei Google Deutschland suchen, bei Bing oder Google News!