


LONDON (IT BOLTWISE) – Der bereitgestellte Text zur Meldung „Taiwan Military Drills“ enthält keine inhaltlichen Absätze, sondern hauptsächlich Navigations- und Seiten-Elemente. Damit bleibt offen, welche konkreten Trainings, Zeitpläne oder technischen Details gemeldet wurden. Für Teams, die Nachrichten verarbeiten, zeigt das Problem jedoch sehr klar, wie wichtig KI-gestützte Quellenprüfung vor der Weiterverarbeitung ist. Besonders relevant sind dabei Entitäts-Erkennung, Dublettenchecks und eine nachvollziehbare Provenienz-Logik in der Pipeline.
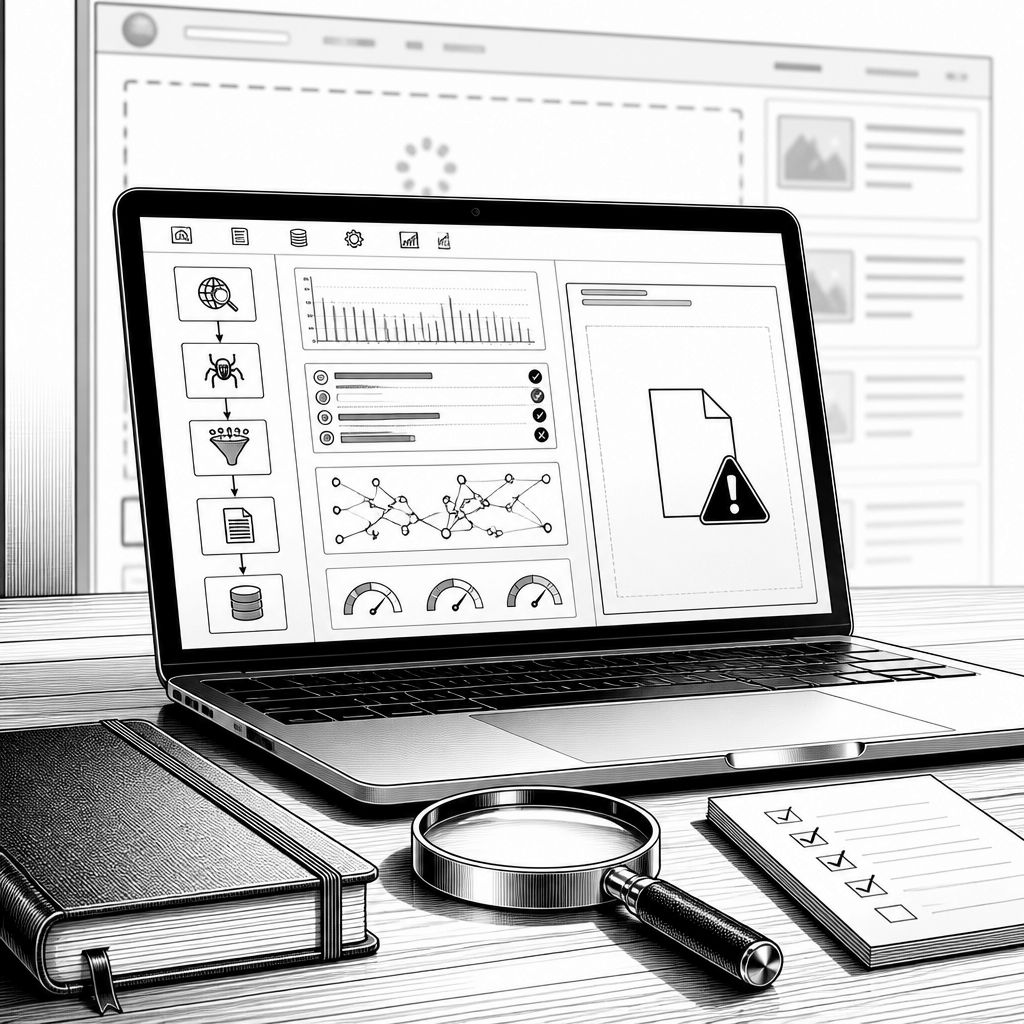
Die Meldung trägt den Titel „Taiwan Military Drills“, doch der eingelieferte Artikeltext besteht in weiten Teilen aus Seiten-UI wie „Home“, „Login“, „Subscribe“ und Copyright-Hinweisen. Inhaltliche Kernaussagen fehlen vollständig: Es gibt weder beschreibende Absätze noch Zahlen, noch technische Aussagen zu Übungen, beteiligten Systemen oder Zeitpunkten. Für Redaktionen und Technologie-Teams ist das kein Nebenschauplatz, sondern der praktische Beweis für ein typisches Risiko in automatisierten Nachrichten-Workflows: Wenn ein Feed- oder Scraping-Lauf nicht die eigentlichen Textkörper erfasst, können nachgelagerte Prozesse auf „Leerstellen“ bauen. Das führt dann nicht zu einem kleinen Fehler, sondern zu einem systematischen Qualitätsverlust, der sich bis in Monitoring-Dashboards, Zusammenfassungen oder Analyse-Modelle fortpflanzt.
Genau an dieser Stelle setzt KI-gestützte Verifikation an. In einer modernen Pipeline reicht es nicht, Text nur „zu parsen“; man muss auch die Struktur prüfen. Ein klassischer Ansatz ist die Erkennung von minimalen Content-Kriterien: etwa ob ausreichend lange Fließtexte vorhanden sind, ob Überschriften-zu-Text-Verhältnisse plausibel sind und ob Leerformate wie nur Navigationslisten dominieren. Algorithmen zur Entitäts-Erkennung (Named-Entity-Recognition) helfen zusätzlich, weil sie im echten Artikelkontext typischerweise Ortsangaben, Akteure oder Organisationsnamen extrahieren. Fehlt dieser Abruf vollständig, ist das ein Signal für eine wahrscheinlich defekte Quelle. Ergänzend spielt Duplikat- und Konsistenzlogik hinein: Wenn mehrere Abrufe derselben Meldung völlig unterschiedliche Textmengen liefern, steigt die Wahrscheinlichkeit, dass ein Teil der Seite dynamisch geladen wurde oder ein Layoutwechsel das Scraping gebrochen hat.
Technisch interessant ist dabei, wie man KI nicht als „Zaubertextgenerator“, sondern als Qualitätsschicht einsetzt. Bei der Zusammenfassung sollte das System zunächst die Textqualität bewerten und in einen konservativen Modus wechseln, sobald das Ausgangsmaterial unzureichend ist. Das kann bedeuten, dass die KI nur jene Informationen wiederholt, die im Input explizit vorhanden sind (hier wären das im Wesentlichen nur die Metadaten rund um den Seitenausschnitt) und ansonsten klar auf die fehlenden Inhalte verweist. Ebenso wichtig: Eine robuste Provenienz-Logik. Wenn ein System später behauptet, es „berichte“ über bestimmte Trainingsdetails, muss es diese Details im Ursprungstext finden können. Dafür nutzt man häufig ein Retrieval-über-Token-Nachweisprinzip: Die Textstelle, auf die sich eine Aussage stützt, wird intern mitgeführt und bei der Ausgabe protokolliert. So wird aus KI-Entwicklung keine Black-Box, sondern eine nachvollziehbare Assistenz.
Der Markt für solche Funktionen wächst seit Jahren, weil die Menge an Medieninhalten pro Sekunde steigt und gleichzeitig die Fehleranfälligkeit bei Seitenintegration zunimmt. Gerade bei Seiten, die Paywalls, dynamische Bereiche oder Client-Rendering enthalten, kann der reine HTML-Abruf nur einen Fragmentteil liefern. In der Praxis führt das dazu, dass sich unterschiedliche Content-Artefakte mischen: Navigationsleisten, Werbeeinblendungen, Querverweise oder „Most Read“-Module. KI kann hier zwar klassifizieren, welche Textsegmente wahrscheinlich zum Artikelkörper gehören, aber die sicherste Grundlage bleibt eine sorgfältige Pipeline-Architektur: zuverlässiges Content-Extraction-Design, Tests gegen Layoutänderungen und Alarmierung bei ungewöhnlich niedriger Textdichte. Unternehmen, die solche Systeme produktiv einsetzen, bauen deshalb meist Monitoring ein, das nicht nur „Ergebnisqualität“ misst, sondern auch „Inputqualität“.
Für die konkreten Folgeschritte in einem solchen Projekt heißt das: erst Stabilität im Datenzugriff, dann erst inhaltliche Verarbeitung. Wenn ein Trainings- oder Konfliktkontext wie „Taiwan Military Drills“ in der Überschrift steht, steigt zwar das Interesse der Anwender, doch ohne belastbaren Textkörper lassen sich keine seriösen technischen Details ableiten. Stattdessen ist es sinnvoll, die Nutzer direkt auf die Lücke im Input hinzuweisen und die nächste Abrufstrategie zu verbessern: andere Nutzeragenten, alternative Rendering-Strategien, serverseitige Parameter oder eine Rekonstruktion über strukturiertes Markup, sofern vorhanden. KI-gestützte Verifikation bedeutet in diesem Fall auch, dass das System lernt, wann es nicht liefern darf. Genau diese Zurückhaltung reduziert das Risiko von Fehlinterpretationen und macht die KI im Ergebnis vertrauenswürdiger.
Am Ende bleibt eine klare technische Lehre: KI ist dann am wertvollsten, wenn sie die Grenzen ihrer Datenlage respektiert. Ein unvollständiger Textkörper ist keine Randnotiz, sondern eine harte Constraint für die nachfolgende Verarbeitung. Wenn ein System diese Constraint erkennt, kann es dennoch Nutzen stiften – etwa durch Qualitätschecks, durch Hinweise zur Datenlücke und durch strukturierte Vorbereitung, sobald ein kompletter Artikeltext verfügbar ist. Das ist nicht nur wichtig für Leserinnen und Leser, sondern auch für Teams, die KI-Entwicklung in produktive Workflows überführen: Die Robustheit gegenüber Datenproblemen entscheidet über Betriebssicherheit, Kosten und vor allem über die Verlässlichkeit der Ausgaben.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "„Taiwan Military Drills“: Was man aus unvollständigen Quellen über KI-gestützte Verifikation lernt" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "„Taiwan Military Drills“: Was man aus unvollständigen Quellen über KI-gestützte Verifikation lernt" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »„Taiwan Military Drills“: Was man aus unvollständigen Quellen über KI-gestützte Verifikation lernt« bei Google Deutschland suchen, bei Bing oder Google News!