


OXFORD / LONDON (IT BOLTWISE) – Die Universität Oxford erlaubt der Firma hinter ChatGPT, Inhalte aus dem Bodleian Library-Umfeld zu digitalisieren und Medienmaterial zu Trainingszwecken zu nutzen. In internen Dokumenten ist die Rede davon, dass gescannte Bestände das Trainings-Set des Modells „populieren“. Gleichzeitig betont Oxford, die Materialmenge sei „modest in scale“ und betreffe nur urheberrechtlich freigegebenen Stoff. Über das Projekt hinaus wird auch ein „Ask the Bod“-Chatbot diskutiert, während intern Fragen zu Reputations- und Energieeffekten aufkommen.
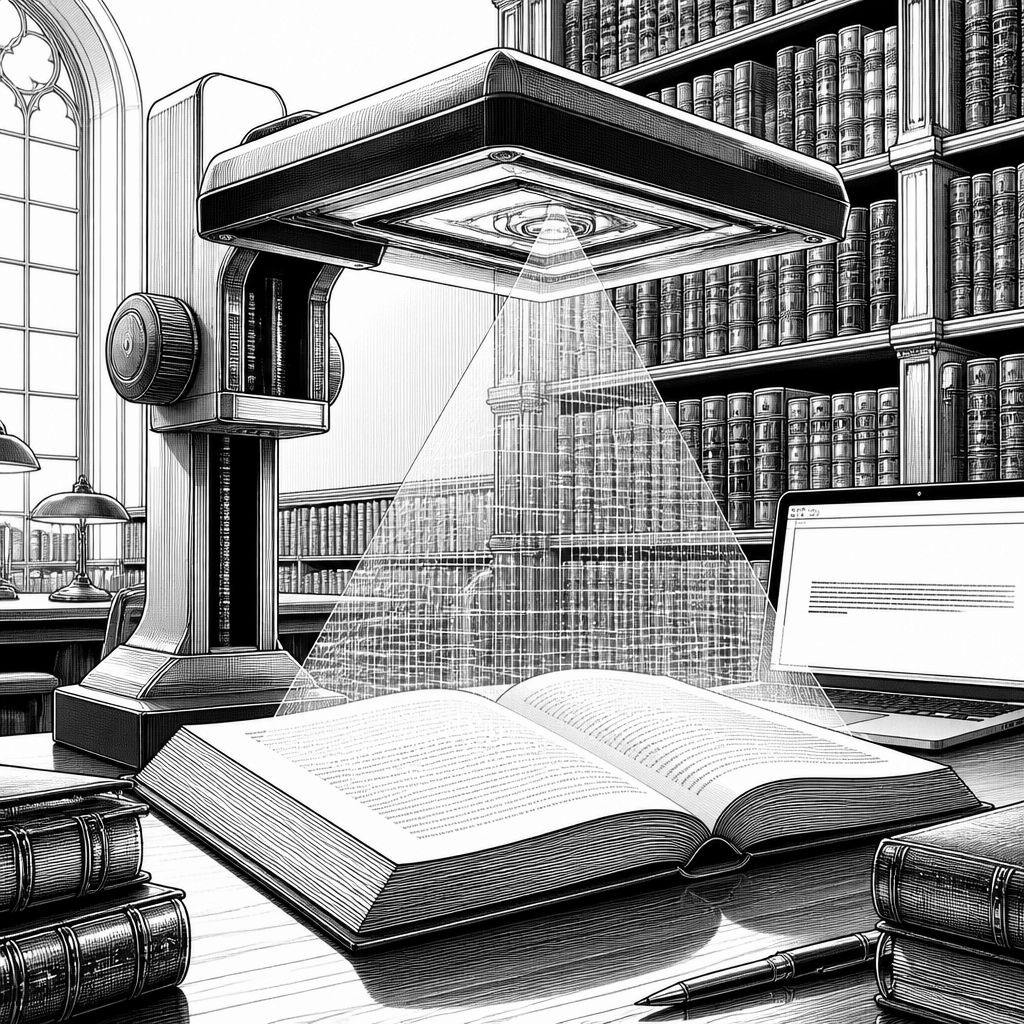
Die Entscheidung aus Oxford klingt auf den ersten Blick nach einem klassischen Digitalisierungsprojekt: Die Universität setzt auf moderne Software, um historische Bestände aus der Bodleian Library zu scannen und für Studium und Forschung verfügbar zu machen. Doch die technische Bedeutung geht weiter als reine Archivpflege. Laut internen Unterlagen soll der digitalisierte Bodleian-Stoff in das Training-Setup des Unternehmens hinter ChatGPT einfließen, also als Datenquelle dienen, mit der Sprachmodelle Muster in Texten lernen und daraus gesprochene wie geschriebene Sprache reproduzieren. Genau an dieser Schnittstelle zwischen „Zugang zu Wissen“ und „Daten fürs Modelltraining“ entzündet sich nun die Debatte – denn Oxford hatte zwar eine Partnerschaft im März 2025 angekündigt, aber zunächst nicht klar erklärt, dass das Material tatsächlich zum Trainieren der Modelle verwendet wird.
Technisch betrachtet ist der Schritt plausibel, weil Modelle ihre Fähigkeiten nicht durch einzelne Dokumente „verstehen“, sondern durch statistische Regularitäten, die sich aus großen Textmengen ergeben. Historische Texte sind dabei besonders wertvoll: Sie enthalten Wörter, Schreibweisen und Formulierungen, die in zeitgenössischen Korpora seltener werden, und sie spiegeln Perspektiven wider, die in moderneren Daten oft unterrepräsentiert sind. Die Bodleian-Digitalisate könnten so sowohl beim Erkennen von Sprache in historischem Kontext helfen als auch beim Generieren von mehrstufigen Antworten, die stilistisch an ältere Epochen angelehnt sind. In der öffentlichen Kommunikation verweist das Unternehmen zugleich auf den Mehrwert für die Bewahrung historischen Wissens; intern werden aber offenbar auch Risiken diskutiert, darunter der Rufschaden durch die Zusammenarbeit mit einer Tech-Organisation und die mögliche Belastung durch die energieintensive Seite von KI-Systemen.
Ein Blick auf den konkreten Umfang macht die Diskussion greifbarer. Bis Juni 2025 wurden dem Unternehmen den Angaben zufolge 125.000 Bilder gescannter Dissertationen aus der Bodleian-Sammlung bereitgestellt, darunter PhD-Thesen aus europäischen und amerikanischen Universitäten aus dem 19. und 20. Jahrhundert. Zusätzlich nennt der Kontext weitere gescannte Materialien: eine seltene Sammlung von 10.000 „broadside ballads“ aus dem 16. Jahrhundert, die nicht nur Liedtexte, sondern auch Noten enthalten. Damit ist die Datenlage nicht auf reinen Fließtext beschränkt; Scans mit Musiknotationen und Layout-Elementen erhöhen für Modelltraining und nachgelagerte Workflows typischerweise die Anforderungen an Texterkennung, Strukturierung und Qualitätskontrolle. Oxford und die Bodleian-Richtungen argumentieren zugleich mit Urheberrechtsgrenzen: Die Universität stellt klar, dass sich die Digitalisierung auf out-of-copyright Material beschränkt und die Menge als „modest in scale“ charakterisiert wird.
Der Marktbezug entsteht vor allem durch die Einordnung in ein größeres Programm. In den USA gibt es vergleichbare Vereinbarungen mit Forschungseinrichtungen und Bibliotheken unter einem Projekt namens NextGenAI; Oxford ist dabei die einzige britische Mitgliedseinrichtung. Für KI-Teams ist das ein attraktiver Weg, um Daten zu beschaffen, nachdem viele öffentlich verfügbare Webseiten durch KI-generierte Inhalte stärker „verrauscht“ sind und dadurch als Trainingskorpus weniger zuverlässig wirken können. Neben dem Datenaspekt spielt auch die Logistik eine Rolle: Bibliotheken verfügen über kuratierte, physisch konservierte Bestände, die sich systematisch scannen und klassifizieren lassen. In der Praxis führt das zu neuen Partnerschaftsmodellen, in denen Rechteinhaber und Wissenschaftsinstitutionen nicht nur Zugang schaffen, sondern auch darüber verhandeln, wer die digitalisierten Inhalte zu welchen Zwecken verwenden darf.
Gerade bei den Rechten und der Frage nach der „Integrität“ der Bestände zeigt sich ein weiterer Unterschied zu einigen anderen Vorgehensweisen in der Branche. Oxford betont, dass die Bodleian-Sammlungen unter der Vereinbarung intakt bleiben und die Bibliothek weiterhin die Rechte an den Scans hält. Zudem soll die Bodleian die digitalisierten Materialien innerhalb der nächsten Monate offen online veröffentlichen. Das steht in Kontrast zu Berichten über andere Ansätze: Ein Wettbewerber, Anthropic, habe – nach den in der Quelle beschriebenen Angaben – Bücher gekauft und deren physischen Rücken entfernt („slicing off their spines“), um Inhalte scannen zu können, bevor Bücher anschließend zerschnitten bzw. entsorgt wurden. Die Bodleian stellt dem eine Praxis gegenüber, bei der die Digitalisierung nicht die Vernichtung des physischen Originals voraussetzt, und sie verweist darauf, dass die Nutzung nicht exklusiv sei.
Die Debatte erhält zusätzlich Gewicht durch das, was über die reine Digitalisierung hinaus geplant sein könnte. In den diskutierten Unterlagen taucht die Idee eines „Ask the Bod“-Chatbots auf. Für Unternehmen und Entwickler ist das mehr als ein Produktname: Es bedeutet, dass ein Retrieval- oder „Grounded“-Ansatz in Richtung historischer Quellen wahrscheinlich wäre, bei dem Antworten auf eine kuratierte Basis zurückgreifen. In Verbindung mit der im Raum stehenden Gesamtperspektive – in den Minuten wird auch eine potenzielle Massen-Digitalisierung von insgesamt 23m Items erwähnt – wird deutlich, wie sehr die Partnerschaft die Datenpipeline einer Institution langfristig verändern könnte. Gleichzeitig bleibt die Herausforderung für alle Beteiligten sichtbar: Je größer der Bestand, desto wichtiger werden Governance, Qualität der OCR/Strukturierung, Versionierung der Digitalisate und klare Regeln, wie und wann Daten ins Training fließen.
Für die wissenschaftliche und unternehmerische Praxis folgt daraus ein Handlungsmuster: KI-Modelle brauchen nicht nur „mehr Daten“, sondern verlässliche, differenzierte Korpora mit Herkunftsnachweis. Universitäten wiederum müssen abwägen, wie sie den Nutzen für Studierende und Forschende maximieren, ohne Vertrauen und rechtliche Rahmenbedingungen zu beschädigen. Wenn Oxford die Digitalisate zeitnah offen publizieren will und zugleich die interne Zustimmungssituation dokumentiert, entsteht zumindest ein Prozessbild, in dem Transparenz und Datenzugang zusammen gedacht werden. Ob sich daraus neue Standards für KI-Trainingsdaten aus Bibliotheken ableiten, hängt allerdings davon ab, wie konsequent Rechte, Veröffentlichungszeitpunkte und technische Aufbereitung über mehrere Jahrgänge hinweg umgesetzt werden.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Oxford erlaubt OpenAI Training mit Bodleian-Texten – was bedeutet das für KI-Daten?" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Oxford erlaubt OpenAI Training mit Bodleian-Texten – was bedeutet das für KI-Daten?" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Oxford erlaubt OpenAI Training mit Bodleian-Texten – was bedeutet das für KI-Daten?« bei Google Deutschland suchen, bei Bing oder Google News!