


LONDON (IT BOLTWISE) – MIT und Sakana AI stellen mit SIFT ein Framework vor, das die Bewertung selbstverbessernder Coding Agents deutlich günstiger macht. Statt jede vorgeschlagene Codeänderung vollständig zu testen, lässt SIFT ein KI-Modell Kandidaten paarweise gegeneinander antreten. Die Ergebnisse werden danach über ein regularisiertes Bradley-Terry-Modell zu einer Rangliste zusammengeführt. In Benchmarks wie Polyglot erreicht SIFT 35,1 % nach 30 Erweiterungsschritten und liegt damit bei weniger Suchaufwand über einem früheren Vergleichsansatz.
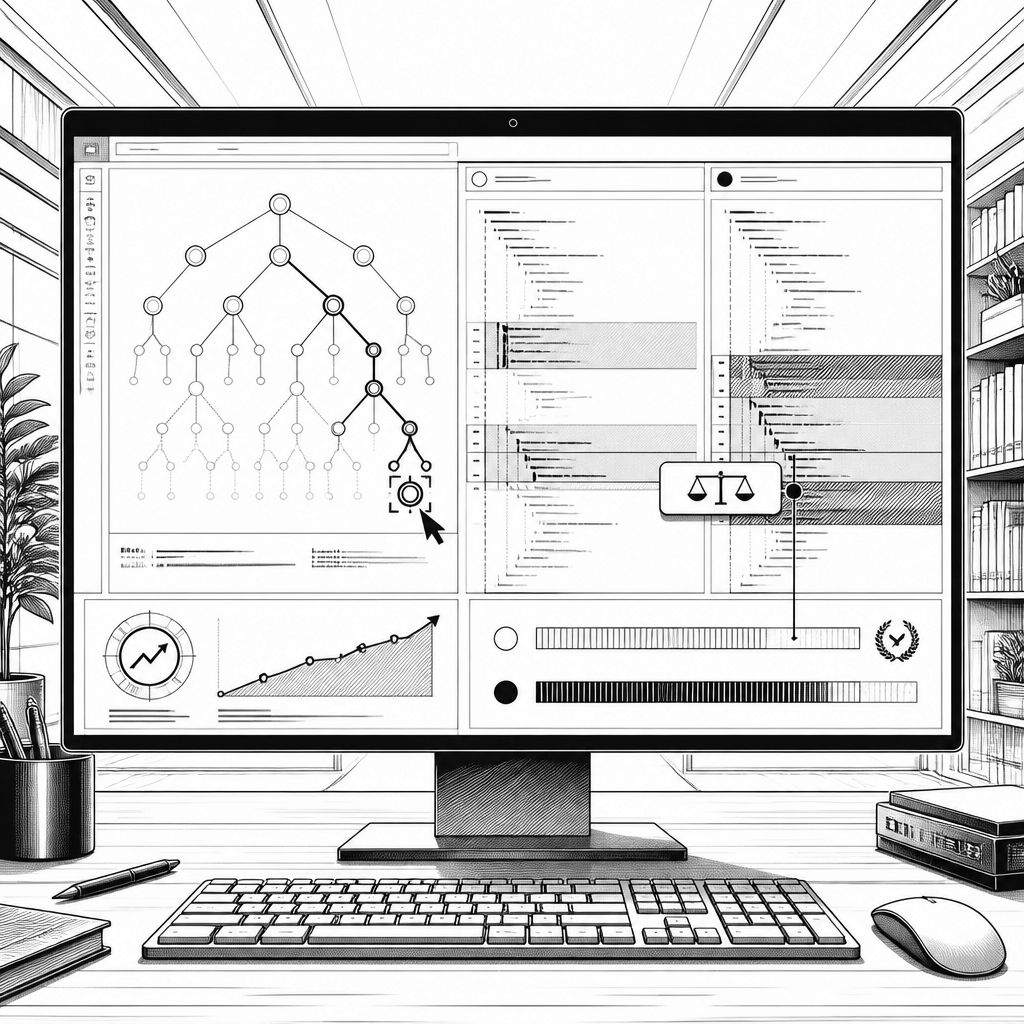
Selbstverbessernde Coding Agents haben einen leisen Engpass: Sobald ein Agent seinen eigenen Code anfasst, muss jemand prüfen, ob die Änderung wirklich besser ist. Das ist nicht nur ein methodisches Detail, sondern bestimmt massiv, wie weit sich solche Systeme in die Praxis hochskalieren lassen. Denn wenn ein Agent viele Kandidaten erzeugt, wächst die Zahl der nötigen Volltests gegen einen Benchmark schnell so stark, dass die Rechenkosten zum dominierenden Kostenblock werden. Genau an dieser Stelle setzt SIFT an, ein auf „Self-Improvement via Fast Tree-search“ getriebener Ansatz, der das teure Prüfen reduziert, ohne auf die Logik der iterativen Selbstoptimierung zu verzichten.
Technisch betrachtet arbeitet SIFT an der Schnittstelle zwischen Suche und Bewertung. Wie bei vielen „Recursive self-improving“-Setups schlägt der Agent eine Änderung an der eigenen Quellbasis vor und hofft, dass die neue Version bei realen Aufgaben besser abschneidet. Der Haken bleibt jedoch die Verifikation: Ein vollständiger Benchmark pro Kandidat würde jede Suchexplosion direkt in Hardware- und API-Kosten übersetzen. SIFT umgeht das, indem nicht jede einzelne Code-Variante vollständig durchgerechnet wird, sondern ein „Referee“ aus einem großen Sprachmodell zunächst zwei Kandidaten gegeneinander vergleicht. In dieser Phase muss das System nicht das gesamte Bewertungsprogramm durchlaufen; es reicht, die relative Qualität zweier Modifikationen zu schätzen.
Die eigentliche Entscheidungslogik entsteht aus der Kombination vieler solcher Head-to-Head-Vergleiche. SIFT nimmt die paarweisen Urteile des Sprachmodells und übersetzt sie in eine übergreifende Rangordnung mit einem regularisierten Bradley-Terry-Modell. Dieses Modell ist dafür bekannt, Präferenzen aus paarweisen Tests statistisch in eine Gesamtbewertung zu überführen. Damit wird aus einer großen Menge an „A wirkt besser als B“-Signalen ein konsistentes Auswahlkriterium, das anschließend die Suchrichtung bestimmt. Zusätzlich bettet SIFT die Evaluationsschritte asynchron ein: Kandidaten müssen nicht in einer starren Reihenfolge warten, bis die Testbank sie „der Reihe nach“ abarbeitet. Dadurch entsteht eine hybride Pipeline, in der das Sprachmodell als günstiger Filter wirkt und nur eine Shortlist der viel teureren downstream Evaluations wirklich durch den vollständigen Prüfpfad schickt.
Die Effizienzbehauptung lässt sich an konkreten Benchmark-Zahlen festmachen. Laut den im Kontext genannten Ergebnissen erzielte ein o3-mini Coding Agent mit SIFT auf dem Polyglot-Coding-Benchmark 35,1 % nach nur 30 Expansion-Schritten. Der Vergleichspunkt ist nicht zufällig gewählt: Der frühere Darwin-Gödel-Machine-(DGM)-Ansatz kam auf 30,7 % auf demselben Benchmark, benötigte aber eine deutlich längere Suche mit 80 Nodes. Der Unterschied ist zweifach relevant. Erstens zeigt er, dass weniger Suchaufwand nicht zwangsläufig schlechtere Ergebnisse bedeutet; zweitens deutet er darauf hin, dass die Bewertung über einen KI-Judge in der Zwischenstufe tatsächlich einen großen Teil der Qualitätsarbeit übernimmt.
Noch schärfer wird die Kostenstory bei Konfigurationen mit Open-Weight-Modellen. In einer beschriebenen Ausführung auf Basis von Qwen3-Coder-30B lief die gesamte Suche in 224 CPU-Stunden und verursachte ungefähr 34 US-Dollar an API-Kosten. Diese Größenordnung wird explizit mit einem etwa zehnfach höheren Ressourcenverbrauch für den DGM-Ansatz kontrastiert. Auch über Polyglot hinaus signalisiert SIFT konsistente Verbesserungen: Auf TerminalBench 2.1 stieg die Leistung von 29,2 % auf 36,7 %, also um 7,5 Prozentpunkte. Auf SWE-60 fiel die Steigerung mit 12,1 Prozentpunkten noch stärker aus: Die Werte kletterten von 40,0 % auf 52,1 %. Für Entwickler ist das mehr als nur ein Score-Vergleich; es legt nahe, dass SIFT nicht auf eine einzelne Aufgabenart überoptimiert wirkt, sondern als generisches Kürzungsmuster für den Evaluationsaufwand funktionieren kann.
Wer steckt dahinter und wie ordnet sich das ein? Die Arbeit wird Xinghong Fu vom MIT zugeschrieben, gemeinsam mit Aravinth Kulanthaivelu und Yutaro Yamada, während Sakana AI als kollaborierendes Labor genannt wird. Veröffentlicht wurde das Papier auf arXiv, datiert um den 18. September 2026; die Diskussionen begannen anschließend in der zweiten Septemberhälfte breiter zu zirkulieren. Inhaltlich passt SIFT in eine Linie, die Sakana AI mit „evolutionären“ Entdeckungsansätzen statt reiner Hardware-Brute-Force-Strategien verbindet: Die zentrale Idee ist, die Such- und Auswahlmechanik so zu formen, dass Rechenbudget in wirklich vielversprechende Kandidaten fließt. Gleichzeitig baut SIFT direkt auf die Grundidee der Darwin-Gödel-Machine-Generation auf, die iteratives Selbstverbessern über Suchprozesse möglich machen sollte – nur eben mit dem Fokus, genau den Bewertungsteil zu entschärfen, der in der Praxis oft die Kosten treibt.
Für die KI-Entwicklung bedeutet das vor allem eine verschobene Zugänglichkeit. Wenn eine vollständige self-improvement Suche in einer Größenordnung von rund 34 US-Dollar an API-Kosten abgebildet werden kann, dann wird das Feld realistischer auch für Teams außerhalb großer Compute-Clusters. Gleichzeitig bleibt ein wichtiger Haken: Die Effizienz hängt unmittelbar von der Güte des KI-Judges ab. Der „Judge“ entscheidet ja, welche Kandidaten in die teuren Volltests weitergereicht werden. Ein konsequent falsches Urteilsverhalten kann die Suche zwar günstiger machen, aber eben auch in die falsche Richtung lenken – und dann summieren sich die Fehler über viele Suchschritte. Diese Abhängigkeit macht „Judge Quality“ zu einem zentralen Engineering-Ziel: Nicht nur die Code-Generierung, auch die Bewertungsfunktion muss robust sein, sonst optimiert das System unter falschen Selektionskriterien.
Für Unternehmen und Teams, die solche Agenten in Software-Workflows integrieren wollen, ergibt sich daraus eine pragmatische Schlussfolgerung: Der größte Hebel liegt nicht ausschließlich in größeren Modellen oder mehr Suchbreite, sondern im Design einer mehrstufigen Pipeline, in der günstige Urteile die teure Evaluation steuern. SIFT liefert dafür ein konkretes Muster – paarweise Vergleichsurteile, statistische Aggregation und asynchrone Execution. Ob dieses Muster in jeder Umgebung 1:1 funktioniert, hängt davon ab, wie gut der Judge die tatsächliche „Nützlichkeit“ von Codeänderungen abbildet und wie stabil die Urteilskonsistenz über verschiedene Aufgaben bleibt. Unterm Strich verschiebt SIFT den Kostenanteil weg vom reinen Benchmarking und hin zur Qualität einer verlässlichen Bewertungsinstanz, und genau dort wird sich die nächste Runde im Wettbewerb um selbstverbessernde Coding Agents entscheiden.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "SIFT: So senkt ein neues Framework die Kosten selbstverbessernder Coding Agents" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "SIFT: So senkt ein neues Framework die Kosten selbstverbessernder Coding Agents" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »SIFT: So senkt ein neues Framework die Kosten selbstverbessernder Coding Agents« bei Google Deutschland suchen, bei Bing oder Google News!