


LONDON (IT BOLTWISE) – Eine Studie in „Current Biology“ zeigt, dass aktuelle KI-Visionmodelle die visuelle „Motion-Aftereffect“-Illusion nicht nachbilden. Menschen und Makaken erleben dabei eine scheinbare Ortsverschiebung stationärer Ziele nach vorheriger Bewegungsadaptation. Im Gehirn verlagert sich dafür laut den Messungen im inferioren Temporallappen (IT) die räumliche Kodierung dynamisch. Das wirft eine klare Benchmark-Frage für die NeuroAI-Entwicklung auf: Wie trainiert man Wahrnehmung, die von kürzlicher visueller Historie abhängt?
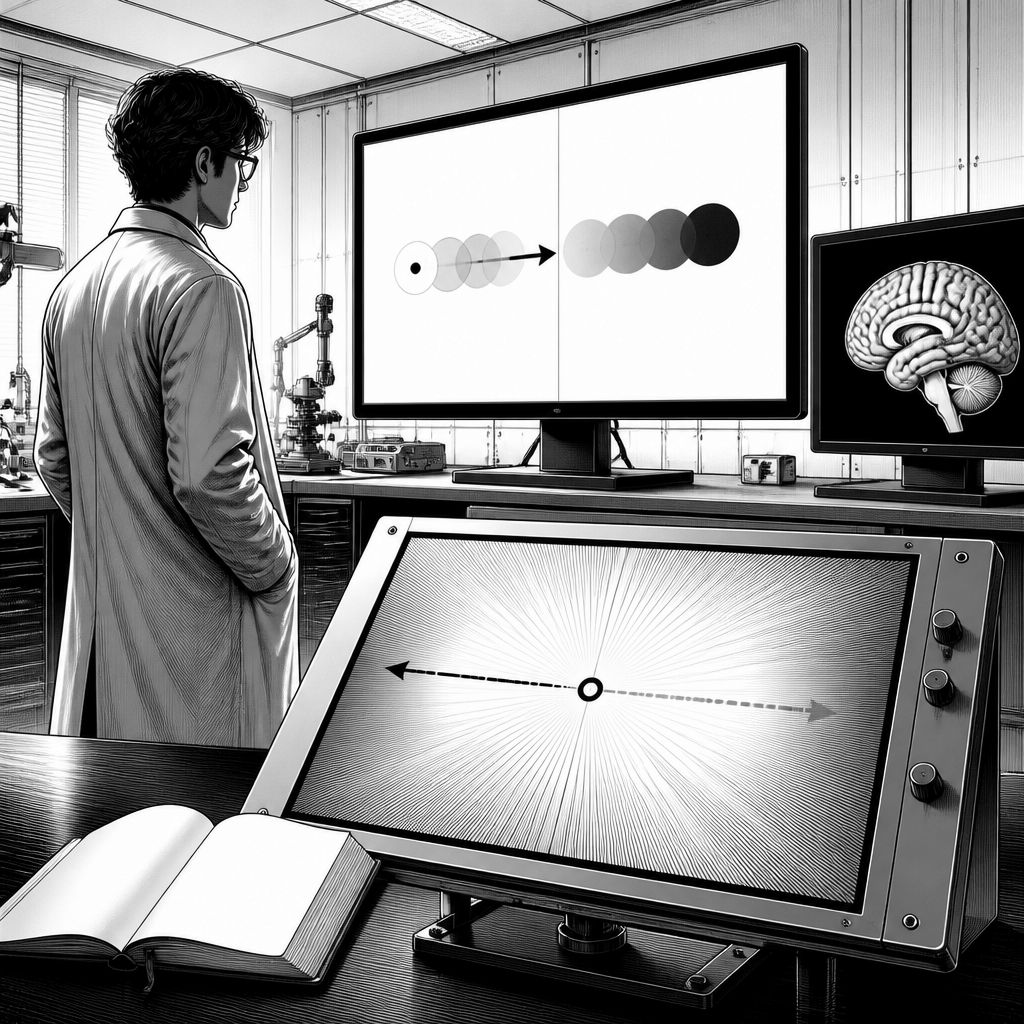
Räumliche Wahrnehmung wirkt für uns wie eine stabile Eigenschaft der Welt – dabei ist sie im biologischen Sehen offenbar ein laufender Rechenprozess. Genau an dieser Stelle setzt eine Untersuchung aus „Current Biology“ an: Forschende um Kohitij Kar von der York University untersuchen, ob KI-Modelle die gleiche Art von „Geschichte im Sehen“ besitzen wie Menschen und nicht-menschliche Primaten. Konkret nutzen sie den Motion-Aftereffect, eine klassische Illusion, bei der ein zuvor durch gerichtete Bewegung „adaptiertes“ visuelles System ein nachfolgendes, eigentlich stationäres Ziel scheinbar in die Gegenrichtung versetzt wahrnimmt. Die physikalische Projektion auf die Retina bleibt dabei unverändert – die bewusste Lokalisierung aber verschiebt sich. Dass biologische Systeme solche systematischen „Fehler“ nicht einfach vermeiden, sondern als Folge effizienter, adaptive Rechenwege akzeptieren, macht die Illusion zugleich zu einem Prüfstein für die Qualität von KI-Perzeption.
Für die technische Einordnung ist entscheidend, dass das Experiment nicht bei der Frage stehenbleibt, ob ein Modell „Objekte“ erkennt, sondern ob es „Wo“ im wahrnehmungsnahen Sinn korrekt repräsentiert. Während moderne Deep-Learning-Ansätze in der Bildverarbeitung stark auf feedforward Verarbeitung setzen und damit in vielen Benchmarks vor allem statische, pixelbasierte Eigenschaften auswerten, verlangt das biologische Sehen nach dynamischer, zeitabhängiger Anpassung. Das Team kombiniert dazu menschliche Psychophysik mit intrakortikalen Ableitungen bei Makaken im inferioren Temporallappen (IT). Die Logik ist elegant: Menschen und Tiere werden einer Bewegungsadaptation ausgesetzt, anschließend wird ein stationäres Ziel präsentiert, und das Experiment prüft, ob die interne Positionskodierung die wahrgenommene Gegenverschiebung widerspiegelt. In der Darstellung der Forschenden berichten menschliche Beobachter die Illusion, und die neuronalen Repräsentationen der Zielposition im IT verschieben sich in derselben Richtung – obwohl sich die Bildinhalte auf der Retina nicht ändern.
Genau hier liegt der gemessene Bruch zu heutigen KI-Visionmodellen: Als die Arbeitsgruppe standardisierte KI-Netzwerke mit dem identischen Paradigma testete, zeigten die Modelle keine vergleichbare Adaptation-induzierte Ortsverschiebung. Ihre internen räumlichen Repräsentationen bleiben in der Beschreibung der Studie an „objektiven“, unverschobenen Pixelkoordinaten verankert. Das ist kein Detailfehler, sondern berührt die Architekturprinzipien: Aktuelle Systeme können zwar über Kontext und Training bessere Detektions- und Klassifikationsleistungen erzielen, reproduzieren aber nicht zwangsläufig die Art von repräsentationaler Umformung, die biologische Systeme während adaptiver Zustandsänderungen durchführen. Interessant ist dabei, dass die Studie nicht nur ein „Versagen“ konstatiert, sondern die Lücke als funktionales Benchmark-Problem formuliert: Wenn KI-Systeme mit Menschen interagieren sollen, darf „räumliches Verstehen“ nicht nur die korrekte Zuordnung zu einer Bildkoordinate liefern, sondern muss die wahrnehmungsnahe Koordinatenlogik abbilden, die durch unmittelbare visuelle Historie geprägt wird.
Aus NeuroAI-Sicht verschiebt sich damit die Messlatte. Die Forschenden leiten aus den Ergebnissen ab, dass das IT-Gehirn nicht lediglich Identitäten speichert, sondern Objektpositionen in Koordinaten repräsentiert, die zur bewussten Wahrnehmung passen. Historisch war die räumliche Verarbeitung im Sehsystem lange vor allem „where“-Mechanismen in dorsalen Pfaden zugeschrieben; neuere Arbeiten zeigen aber, dass auch ventrale Pfade und insbesondere der inferior temporale Kortex Positionssignale enthalten können. Die Studie adressiert dabei außerdem die methodische Unsicherheit vieler früherer Paradigmen: Wenn Positionssignale an pixelbasierte Kopplungen gebunden sind, bleibt unklar, ob sie wirklich perzeptuell relevant sind oder nur retinotopische Nebenprodukte reproduzieren. Der Motion-Aftereffect hilft, diese Kopplung aufzubrechen, weil die Eingabe konstant gehalten wird, die Wahrnehmung sich aber ändert. Über solche Illusionsbasierte Tests entsteht damit ein geeigneter Benchmark, um dynamische und rekurrente Aspekte von Modellen gezielt zu bewerten – statt nur statische Encoder-Leistungen zu optimieren.
Besonders praxisnah wird die Argumentation durch Beispiele für reale Umgebungen, in denen Menschen und Maschinen räumlich koordiniert handeln müssen. Wenn autonome Systeme, Robotik-Assistenz oder Computer-Vision-Komponenten in Alltagskontexte eingebettet sind – etwa beim Fahren in unmittelbarer Nähe menschlicher Verkehrsteilnehmer oder beim Mitlesen und Lokalisieren in Echtzeit bei medizinischen Abläufen – können Unterschiede in der Art, wie „räumliche Beziehungen“ repräsentiert und interpretiert werden, zu Fehlanpassungen führen. Die Studie formuliert dazu die Kernfrage hinter „Human-Machine Alignment“: Geht es bei KI nur darum, am Ende das richtige Ergebnis zu liefern, oder muss das Modell auch die Berechnungsketten besitzen, die menschliche Wahrnehmung und Verhalten entstehen lassen? Für den Entwicklungsprozess bedeutet das, dass reine Zielgrößen wie pixelnahe Lokalisationsfehler zu kurz greifen können, wenn die entscheidende Eigenschaft eine adaptive, zustandsabhängige Repräsentation ist. In der Studie wird zudem beschrieben, dass es reicht, empirisch abgeleitete Transformationen aus den IT-Daten auf Modellfeatures aufzulegen, um den Effekt zu simulieren – ein Hinweis darauf, dass ein fehlendes Rechenelement im Transformieren und Verformen von Repräsentationen liegen kann, nicht zwangsläufig in der generellen Fähigkeit zu „Positions-Encoding“.
Damit erhält NeuroAI einen konkreten Prüfmodus: Wie gut kann ein Modell Zustandswechsel durch kürzliche Erfahrung in eine neue räumliche Kodierung übersetzen? Für Entwicklungsteams ist das zugleich eine Architekturfrage und eine Trainingsfrage. Feedforward-Modelle lassen solche Zustandsänderungen häufig nur über explizite Sequenzmodellierung oder rekurrente Mechanismen zu; selbst video-basierte und state-of-the-art Netzwerke bleiben in der Studie jedoch ohne die Adaptation-induzierten Ortsverschiebungen. Das legt nahe, dass nicht jede Zeitdimension automatisch die richtige Form von repräsentationaler Umformung erzeugt. Als nächste Schritte bietet sich eine gezielte Evaluation an, bei der Illusionen nicht als Kuriosität gelten, sondern als messbares Signal für dynamische, historyabhängige Rechenoperationen. Die wissenschaftliche Basis ist dafür bereits gelegt: Die Arbeit nennt als DOI 10.1016/j.cub.2026.09.019, benennt die beteiligten Autorinnen und Autoren (Elizaveta Yakubovskaya, Hamidreza Ramezanpour, Matteo Dunnhofer, Kohitij Kar) und ordnet die Ergebnisse als Open-Access-Forschung in „Current Biology“ ein. Für die industrielle Umsetzung folgt daraus eine klare Konsequenz: Wer KI-Vison „menschennah“ machen will, sollte Benchmarks einführen, die nicht nur Genauigkeit auf statischen Bildern messen, sondern die adaptive Geometrie von Wahrnehmung unter realistischen zeitlichen Bedingungen.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Studie zeigt blinden Fleck: KI-Vision lernt keine bewegungsabhängige Wahrnehmung" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Studie zeigt blinden Fleck: KI-Vision lernt keine bewegungsabhängige Wahrnehmung" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Studie zeigt blinden Fleck: KI-Vision lernt keine bewegungsabhängige Wahrnehmung« bei Google Deutschland suchen, bei Bing oder Google News!