
LOS ANGELES / LONDON (IT BOLTWISE) – Kindo stellt mit Deep Hat Sift einen „decision model“ vor, der bei Alert-, Ticket- und Log-Workflows entscheidet, welche Ereignisse tatsächlich einen LLM-Check brauchen. Das System lernt aus den Urteilen der Agenten im Betrieb, statt für jede Verbesserung neue Trainingsdaten zu labeln. In einem Shadow-Mode bewertet es zunächst alle Events, filtert dann aber nur nach genehmigten Schwellenwerten. Ziel ist, LLM-Kosten bei hohen Datenraten zu senken, ohne die Verarbeitung der wichtigsten Signale zu verlangsamen.
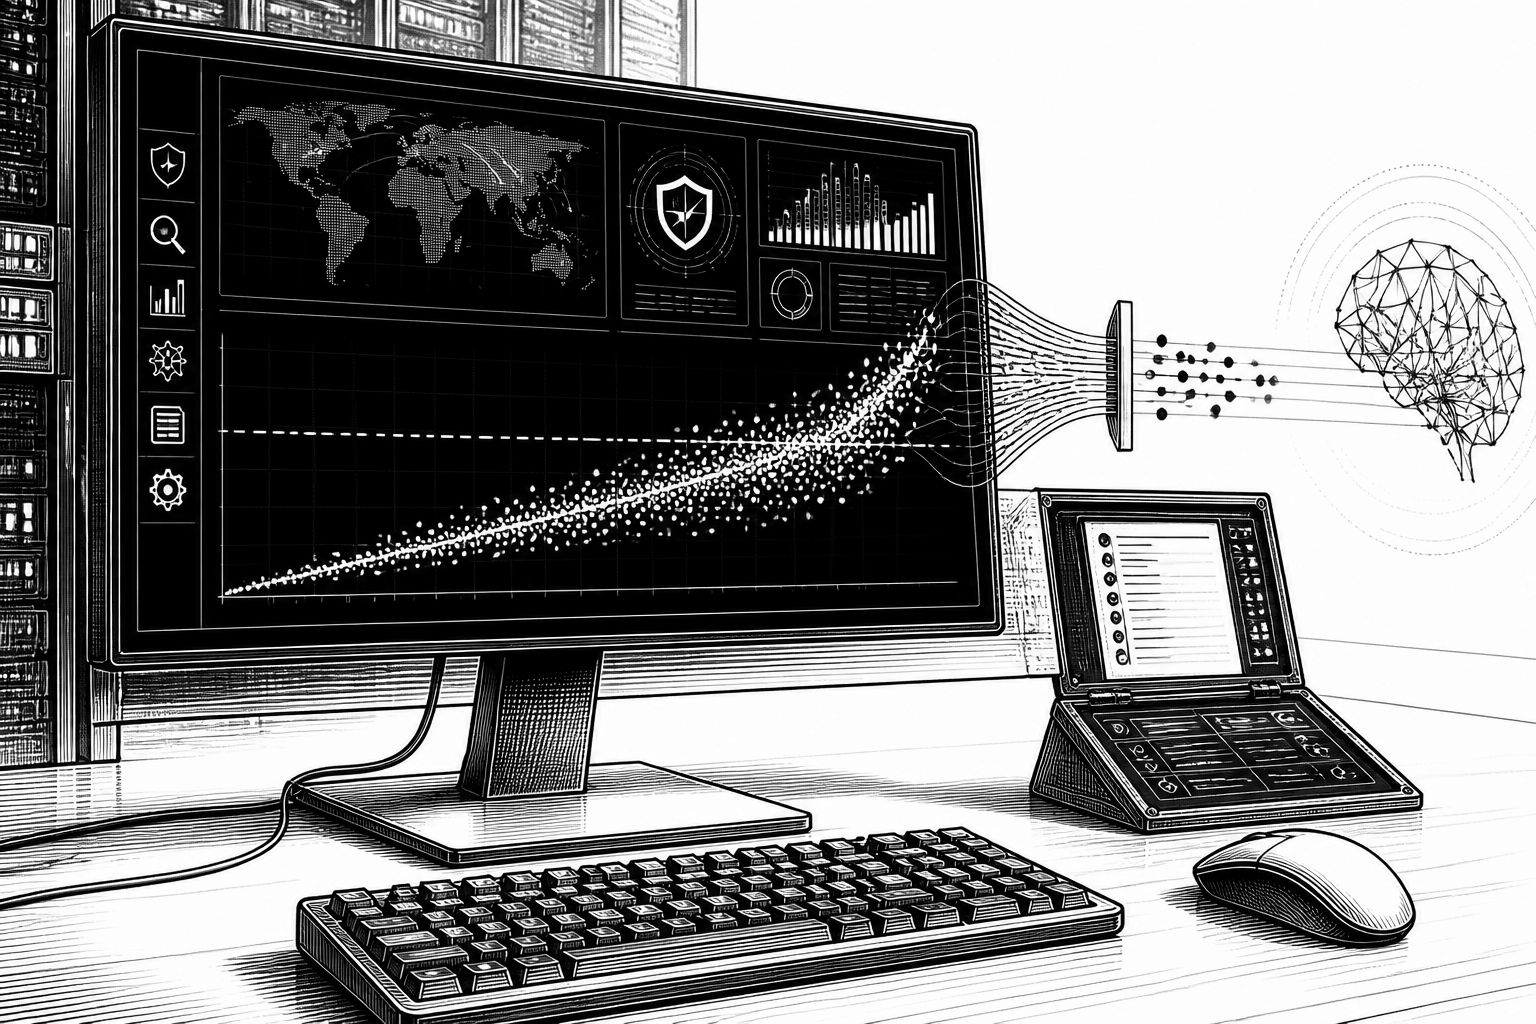
Kosten für große Sprachmodelle geraten bei Unternehmen mit sehr hohen Datenraten schnell außer Kontrolle. Genau an dieser Stelle setzt Kindo mit Deep Hat Sift an: Das neue „System One“-Entscheidungsmodell soll nicht Text erzeugen, sondern im Kern nur ein Ja oder Nein liefern, ob ein bestimmtes Ereignis überhaupt an ein LLM weitergereicht werden muss. In typischen Umgebungen landen Alert-Streams, Ticket-Queues und Log-Plattformen in hoher Frequenz beim Security- oder IT-Betrieb; wer jedes Event vollständig per LLM analysiert, zahlt entsprechend. Deep Hat Sift verspricht, diese binäre Brücke zwischen „anreichern“ und „überspringen“ so zu steuern, dass Agenten die relevanten Datenströme priorisieren und gleichzeitig die LLM-Last sinkt.
Technisch betrachtet ist das Konzept eine Abkürzung innerhalb einer Agenten-Pipeline: Statt jedes Ereignis konsequent durch ein kostenintensives Modell zu schieben, wird eine schnelle Filterebene vorgeschaltet. Kindo beschreibt Deep Hat Sift als selbst-improvinges Modell, das sich an die Entscheidungen der Agenten anlehnt, denen es dient. Entscheidend ist dabei, wie das Lernen im Betrieb stattfindet: Das Modell erhält als Trainingssignal ausschließlich die Urteile der Agenten, also die Information, ob ein Event in der Praxis als relevant eingestuft wurde. Damit entfällt laut Anbieter ein klassisches Labeling-Projekt, bei dem Teams manuell Kategorien vergeben oder Daten kuratieren, und es entfällt auch die Wartezeit auf ein neu trainiertes Vendor-Modell, das wieder ausgerollt werden müsste.
Damit Vertrauen in das „Überspringen“ entsteht, adressiert Deep Hat Sift zudem das häufige Dilemma von festgewichteten Filtern. In der klassischen Betriebsrealität sind einfache Modelle nur so gut wie der Stand bei ihrer Veröffentlichung; ohne regelmäßiges Retraining kann ihre Abdeckung mit neuen Mustern sinken. Deep Hat Sift soll dieses Problem durch fortlaufende Anpassung an die realen Rückmeldungen aus dem laufenden System entschärfen. Dabei wird laut Beschreibung jede einzelne Entscheidung nachvollziehbar aufgezeichnet: Eine Person setzt Schwellenwerte einmal fest, und jedes gefilterte Event wird für Transparenz und Compliance dokumentiert. Für IT-, Security-, Finance- und Compliance-Teams ist das mehr als ein Komfortfeature, weil es den Kostenvorteil an einen auditierbaren Entscheidungsprozess koppelt.
Operativ sieht der Rollout laut Kindo eine kontrollierte Lernphase vor, bevor echte Filter wirklich „hart“ greifen. Das Modell startet im Shadow-Mode: Es bewertet zunächst jedes Event und „punktet“ es, sendet aber weiterhin sämtliche Ereignisse an den Agenten, damit parallel überprüfbar bleibt, was tatsächlich ausgelassen würde. Erst wenn ein Mensch einen Schwellenwert freigibt – und zwar mit einer schriftlichen Begründung –, beginnt das Modell aktiv zu filtern. Gleichzeitig soll ein Zufallsanteil von Ereignissen, die andernfalls withheld würden, trotzdem weiterlaufen. Dadurch bleibt die Miss-Rate messbar, also wie oft ein Event, das später relevant gewesen wäre, vom Filter zu früh unterdrückt wird.
Für die Markt- und Architekturlogik ist die Idee naheliegend: Unternehmen wollen LLMs dort einsetzen, wo sie Mehrwert liefern, und sie nicht als „Immer-an“-Motor in jeder Auswertung missbrauchen. Genau diese Binarität beschreibt Kindo als bisherige Falle: Entweder man betreibt ein großes Modell auf allem und verliert Tempo sowie Kostenkontrolle, oder man hält Agenten von den wichtigsten Quellen fern und blockiert Optimierungen in Prozessen. Deep Hat Sift zielt darauf, die Arbeit wieder dorthin zu verschieben, wo die Datenmengen hoch sind, ohne den bisherigen Grundsatz „Lieber zu viel als zu wenig“ vollständig aufzugeben. In der Praxis bedeutet das: Die wirtschaftliche Engstelle verlagert sich weg von „LLM auf jedem Event“ hin zu „LLM nur auf ausgewählten Ereignissen“, während die Filterentscheidung aus dem Betriebswissen gespeist wird.
Auch für die IT-Governance kann der Ansatz Relevanz entfalten, weil sich ein Entscheidungspfad zwischen Agenten und Modellen besser modellieren lässt als ein undurchsichtiger End-to-End-Block. Wenn Schwellenwerte pro Use-Case gesetzt und die gefilterten Events geloggt werden, können Teams nachvollziehen, warum bestimmte Klassen von Alerts, Tickets oder Logs nicht weiterverarbeitet wurden. Zudem wird die Trainingslogik auf interne Betriebsurteile reduziert: Es gibt keine zusätzliche Label-Iteration, kein separates Daten-Programm und keine externe Modell-Wiederveröffentlichung, die zeitlich mit Verantwortlichkeiten kollidiert. In einer Welt, in der Model Cost, Latenz und Risiko fast immer gegeneinander ausgespielt werden, versucht Deep Hat Sift diese Zielkonflikte in einer einzigen, kontrollierbaren Schleife zusammenzubringen.
Offen bleibt, wie Kindo die Grenzen des Systems im Detail auslotet: Wie stabil die Filterleistung über längere Zeiträume bleibt, wie schnell sich das Modell an neue Muster anpasst und wie genau die Messung der Miss-Rate in unterschiedlichen Event-Klassen funktioniert. Ebenso hängt der Nutzen stark vom Zusammenspiel mit dem jeweiligen Agenten-Setup ab, denn die „Urteile“, aus denen Deep Hat Sift lernt, sind letztlich die operativen Ground-Truths. Wenn diese Agenten bereits produktionsnah entscheiden und ihre Ergebnisse sauber verwalten, kann ein solches Entscheidungssystem besonders wirksam werden. Für Unternehmen, die LLM-Einsatz bereits in Security- oder Operations-Workflows planen, ist Deep Hat Sift daher weniger ein neues „KI-Tool“ als vielmehr ein Kosten- und Qualitätsregler für die gesamte Agenten-Pipeline.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Kindo bringt Deep Hat Sift: KI entscheidet, welche Events LLM-Checks brauchen" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Kindo bringt Deep Hat Sift: KI entscheidet, welche Events LLM-Checks brauchen" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Kindo bringt Deep Hat Sift: KI entscheidet, welche Events LLM-Checks brauchen« bei Google Deutschland suchen, bei Bing oder Google News!