
LONDON (IT BOLTWISE) – Die Kostenstruktur von Bitcoin-Mining teilt sich laut der vorliegenden Einordnung ungefähr im Verhältnis 50:50 auf Rechenleistung-Capex und Strom. Bei KI-Inferenz verschiebt sich das Bild deutlich: Rechen-Capex bestimmt nahezu vollständig die laufenden Kosten. Für Betreiber bedeutet das, dass sich Wirtschaftlichkeitsrechnungen weniger über den Stromtarif und stärker über Kapazitätsplanung, GPU-Auslastung und Abschreibungen drehen. Gleichzeitig verändert das, wie Unternehmen ihre KI-Services skalieren und Preislogik für Inferenz setzen.
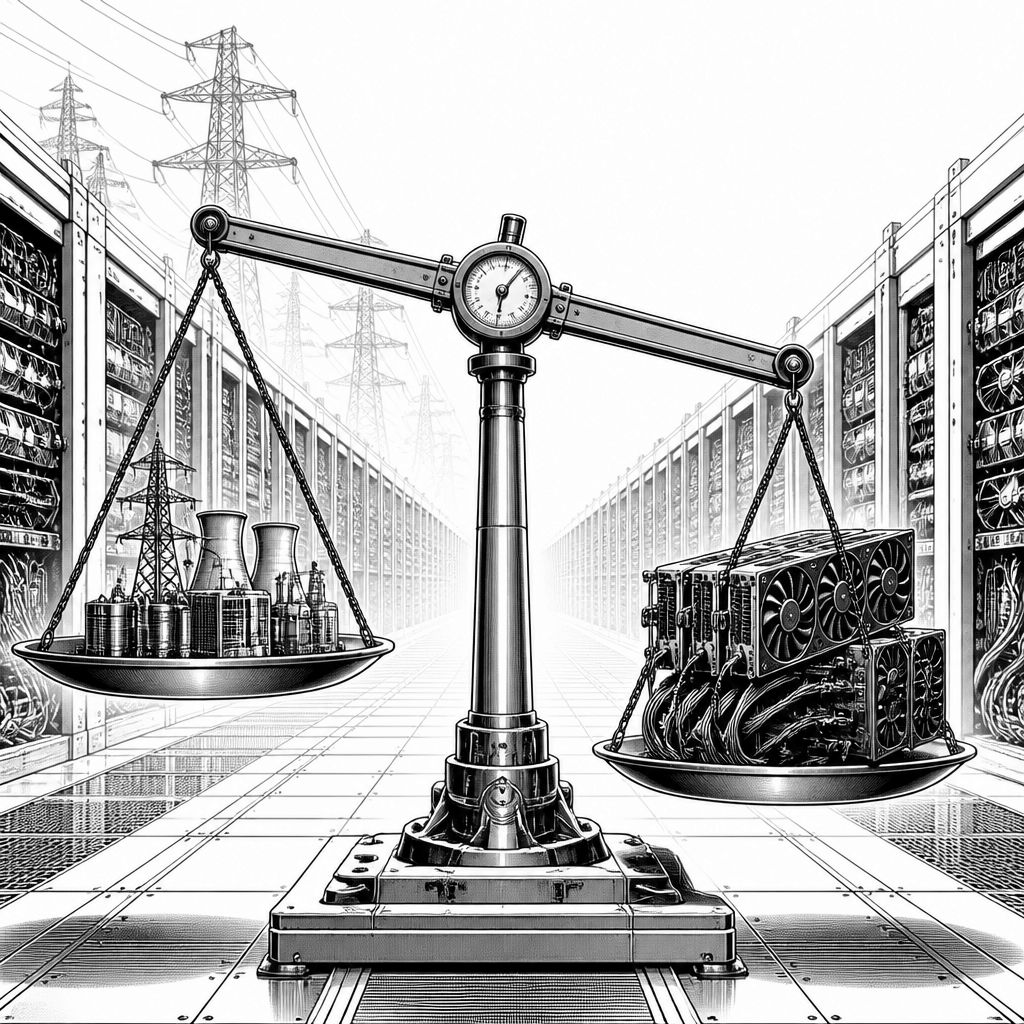
Die scheinbar kleine „Fun Fact“-Aussage zur Kostenstruktur hat in der Praxis eine große Sprengkraft: Beim Bitcoin-Mining wird die Kostenlast offenbar zu etwa gleichen Teilen durch die Anschaffung beziehungsweise den Aufbau der Recheninfrastruktur (Compute-Capex) und durch die Betriebskosten Strom geprägt. Genau an diesem Punkt setzt die zweite Beobachtung an, die man in der KI-Welt oft genauso spürt wie in den eigenen Kostenstellen: Bei der KI-Inferenz werden die laufenden Ausgaben fast vollständig durch Compute-Capex-getriebene Faktoren dominiert. Entscheidend ist dabei weniger die Schlagzeile als die dahinterliegende Mechanik, denn sie erklärt, warum zwei scheinbar ähnliche „Rechen-Workloads“—Mining und Inferenz – wirtschaftlich völlig unterschiedlich gesteuert werden.
Technisch betrachtet liegt der Unterschied vor allem in der Art, wie Kapital in Leistung „übersetzt“ wird. Beim Mining kauft man Maschinen, die – vereinfacht gesagt – pro Zeiteinheit eine bestimmte Rechenrate liefern und dabei direkt Strom verbrauchen. Die Stromkosten variieren häufig mit Energiepreisen und Betriebsbedingungen, während die Capex-Komponente über Anschaffung, Upgrade-Zyklen und Abschreibung läuft. Bei KI-Inferenz dagegen zahlt man für die wiederholte Ausführung eines Modells auf oft hochgradig parallelisierten Beschleunigern. Diese Kosten entstehen nicht „aus dem Nichts“: In der Regel liegen sie in der notwendigen Hardware, inklusive GPUs oder spezialisierter Beschleuniger, deren Beschaffung und Lebensdauer die Kostenbasis formen. Selbst wenn man Stromkosten betrachtet, ist die dominante Rolle häufig die verfügbare Rechenleistung, die ausgelastet und amortisiert werden muss – und die dafür nötige Kapazität ist eben Capex-getrieben.
Damit ändert sich die betriebswirtschaftliche Steuerungslogik. Im Mining kann ein Wechsel des Strombezugs, ein anderer Standort oder ein anderes Lastprofil die Gesamtkosten deutlich beeinflussen, weil der Strom ein sichtbarer Block ist. Bei Inferenz ist der Hebel oft anders gelagert: Die Frage lautet weniger „wie teuer ist der Strom“, sondern „wie effizient nutzt man die teure Rechenleistung“. Das heißt konkret: Wie hoch ist die effektive Inferenzrate pro GPU bei gegebener Batch-Größe oder bei Streaming-Workloads? Wie viel Leerlauf entsteht durch Antwortzeiten, Wartezeiten in der Queue und durch Lastspitzen? Wie stark wirkt sich Modellgröße, Sequenzlänge und Precision-Strategie (etwa quantisierte Varianten oder effizientere Kernel) auf die tatsächlich abgerechneten Tokens pro Sekunde aus? Wenn nahezu „Capex dominiert“, dann wird jede Verbesserung in Auslastung, Scheduling und Modelloptimierung zu einer direkten Kostensenkung.
Aus Markt- und Betriebs-Sicht erklärt das auch, warum sich Anbieter von KI-Services so häufig über Latenz, Durchsatz und Kosten pro Anfrage unterhalten – und warum „Pricing“ in Inferenzprodukten oft eng an technische Auslastungskennzahlen gekoppelt ist. Die Aussage, KI-Inferenz sei fast vollständig von Compute-Capex geprägt, passt zu der typischen Infrastrukturrealität: Rechenzentren stellen nicht nur Strom, sondern vor allem Kapazität bereit, die in Hardwareinvestitionen gebunden ist. Selbst wenn die Energiekosten in absoluten Zahlen relevant sind, entscheidet die Abschreibung der Hardware plus Betrieb der Infrastruktur darüber, wie schnell sich eine Plattform rechnet. Bei Skalierung kommt hinzu, dass der Bedarf schwer planbar sein kann: Marketingwellen, Produktfeatures oder saisonale Effekte erhöhen die Nachfrage und zwingen zu kurzfristigen Kapazitätsentscheidungen, die wiederum die Capex-Logik tangieren. In solchen Szenarien wirkt sich die Fähigkeit, Skalierung sanft über mehrere Ebenen zu gestalten – etwa durch reservierte Kontingente, dynamische Ressourcenallokation und belastbare Kapazitätsmodelle – unmittelbar auf die Marge aus.
Ein historischer Blick macht die Unterschiede noch verständlicher. Beim Mining hat sich die Kostenrechnung über Jahre hinweg stark über Effizienzkennzahlen wie Hashrate pro Watt entwickelt, weil Strom und Gerätequalität zusammen die Wirtschaftlichkeit bestimmten. In der KI-Inferenz-Ökonomie dagegen war lange Zeit das Thema „Modelltraining“ dominanter: Wer die größten Modelle trainiert, investiert massiv in Capex, aber das Training ist relativ selten im Vergleich zu den massiven Wiederholungen im Produktivbetrieb. Sobald ein Modell in einer Anwendung dauerhaft genutzt wird, verlagert sich die Kostenrealität: Inferenz ist die wiederkehrende Operation, und damit wird die Hardwarebasis zur dauerhaften Kostenquelle. Genau deshalb sieht man bei vielen KI-Setups Bemühungen rund um bessere Serving-Stack-Designs – beispielsweise optimierte Inferenz-Engines, effizientes Speicher-Management und Strategien zur Reduktion von Overhead – weil sie die „Hardwarekosten pro sinnvoller Rechenleistung“ drücken.
Für Unternehmen bedeutet das eine klare Konsequenz in der Architektur- und Beschaffungsplanung. Wenn KI-Inferenz nahezu capex-getrieben ist, sollten Teams ihre Wirtschaftlichkeitsrechnung an Capex-Nähe koppeln: nicht nur an Strompreise, sondern an Hardware-Lifecycle, Auslastung, SLA-Anforderungen und an die Frage, wie schnell sich ein Bereitstellungspfad ändern lässt. Das betrifft auch die Wahl zwischen eigenen Inferenzressourcen und dem Bezug über Anbieter, denn beides beeinflusst, wie die Abschreibung in die Endkosten durchgereicht wird. Gerade für Use Cases mit schwankender Nachfrage ist wichtig, dass Modelle nicht nur „genau“, sondern auch steuerbar sind: Input-Längen begrenzen, Caching nutzen, Prompt- und System-Overhead reduzieren und bei Bedarf auf kleinere Modelle umschalten. Damit lässt sich die teure Rechenleistung so lange effizient auslasten, bis der nächste Hardwarezyklus wirklich nötig wird.
Interessant ist dabei, dass die Quelle für die Kostenkennzahlen im vorliegenden Material zwar keinen detaillierten Zahlenbeleg liefert, aber die Struktur der Aussagen im Kern plausibel ist: Bitcoin-Minern tragen sichtbar sowohl Strom als auch Investitionskosten, während KI-Inferenz typischerweise stärker durch die benötigte Rechenkapazität bestimmt wird. Für die Praxis sollte man solche „Fun Facts“ jedoch als Anstoß verstehen, die Annahmen im eigenen Betrieb zu verifizieren. Eine saubere Herleitung bedeutet: Kostenblöcke trennen (Hardwareabschreibung, Strom, Kühlung, Personal, Kapazitätsmieten), Lastprofile messen und dann auf die Kennzahlen herunterbrechen, die man wirklich steuern kann – Tokens pro Sekunde, GPU-Auslastung, Queue-Latenz und Kosten pro erfolgreich verarbeiteten Request. Dann wird aus der abstrakten Gegenüberstellung „Mining vs. Inferenz“ eine konkrete Planungsgröße.
Am Ende entscheidet nicht die Metapher, sondern die Ausführung. Wer KI-Inferenz produktiv betreibt, muss Kapazität so dimensionieren, dass sich Capex in wiederkehrenden Durchsatz verwandelt, statt Hardware im Leerlauf zu finanzieren. Wer Mining betreibt, optimiert dagegen besonders die Verbindung aus Geräteeffizienz und Energieeinsatz. Genau diese beiden Steuerungsprinzipien – Auslastung und Kapazitätsnutzung auf der einen Seite, Strom- und Geräteeffizienz auf der anderen – machen aus einer kurzen Kostenbeobachtung einen belastbaren Leitfaden für Architektur, Betrieb und Pricing. Und je stärker Unternehmen KI als Service in Produkte integrieren, desto mehr rückt Inferenz als „dauerhafter Betrieb“ in den Fokus, nicht mehr nur als experimenteller Rechenjob.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Bitcoin-Mining vs. KI-Inferenz: Warum Capex bei KI oft dominiert" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Bitcoin-Mining vs. KI-Inferenz: Warum Capex bei KI oft dominiert" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Bitcoin-Mining vs. KI-Inferenz: Warum Capex bei KI oft dominiert« bei Google Deutschland suchen, bei Bing oder Google News!