


LONDON (IT BOLTWISE) – Coding Agents könnten Datenplattformen bis 2028 zur primären Datenschnittstelle für Business User machen. Der Kern ist dabei weniger die Oberfläche als die Art, wie ein Agent Kontext, Semantik und Kontrollen in seinen Workflow einbindet. Statt nur abzufragen sollen Daten in wiederverwendbare und überprüfbare Abläufe überführt werden. Für Unternehmen bedeutet das: semantische Single-Source-of-Truth, Evaluationsroutinen und DataOps-Praktiken rücken in den Mittelpunkt.
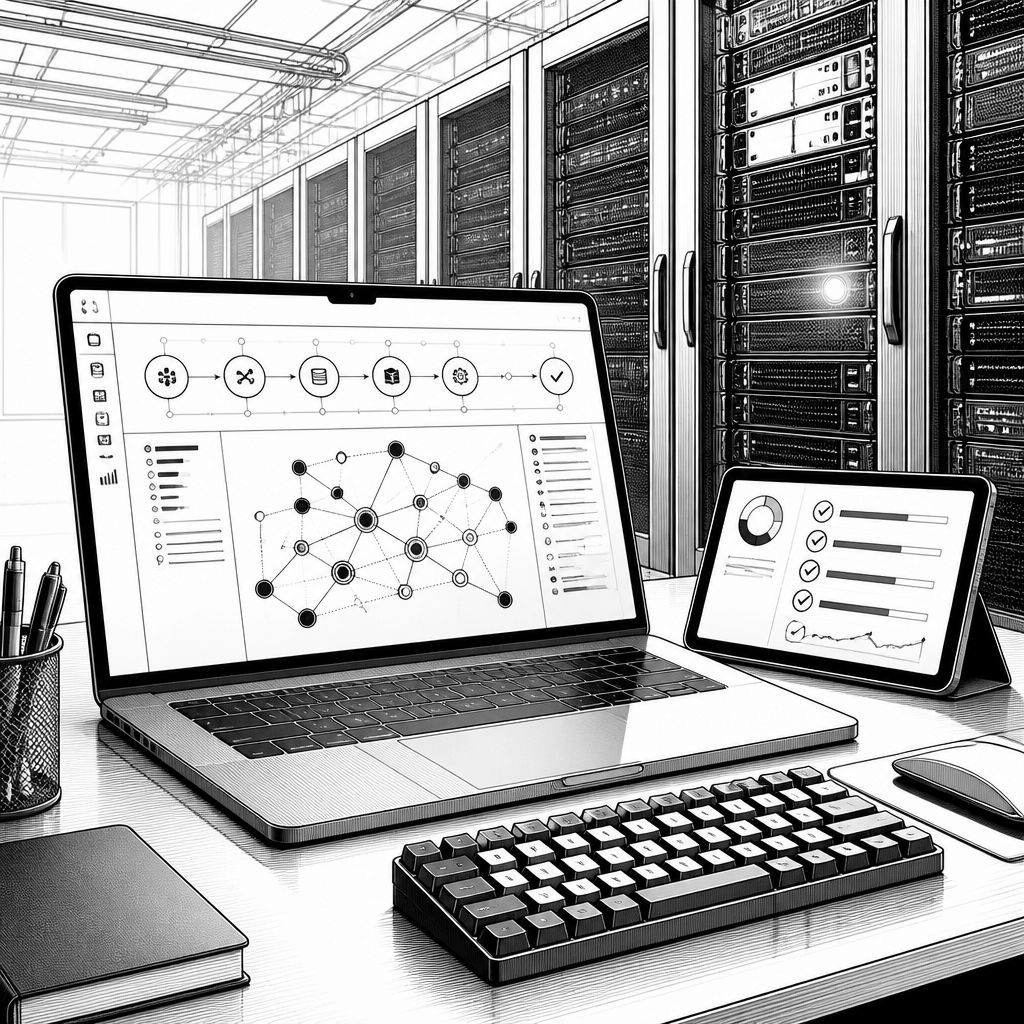
Coding Agents verschieben den Schwerpunkt in Datenprojekten vom Berichtswesen hin zu ausführbaren Arbeitsabläufen. Wenn KI-gestützte Programmieragenten Aufgaben wie Analyse, Anwendungsentwicklung oder die Ausführung von Datenprozessen übernehmen, brauchen sie nicht nur Zugriff auf Daten. Sie müssen auch zuverlässig verstehen, welche Informationen im jeweiligen Kontext relevant sind, was die Begriffe in der Organisation bedeuten und welche Regeln bei der Verarbeitung gelten. Genau hier setzt der Ansatz „Agentic Data Coding“ an: Er beschreibt eine Architektur, in der Daten und Semantik nicht nur als Rohmaterial betrachtet werden, sondern als Grundlage für kontrollierte, nachvollziehbare Agenten-Workflows.
Warum das mehr ist als ein UX-Upgrade, zeigt der Vergleich zur traditionellen Code-Entwicklung. Code lässt sich häufig über Tests eindeutig verifizieren, während datenbezogene Aufgaben oft keine klar definierte „richtige Antwort“ liefern. Stattdessen braucht es Vergleichswerte oder Evaluationsdatensätze, damit ein Agent Ergebnisse bewerten und iterativ verbessern kann. Die Quelle ordnet diese Herausforderungen in drei Dimensionen ein: Kontext (welche Geschäftslogik und Definitionen gelten), Veränderungsdynamik (wie schnell sich Schemas und Semantik weiterentwickeln) und Überprüfbarkeit (wie sich die Qualität von Ergebnissen belastbar belegen lässt). Diese drei Achsen werden zur technischen Leitplanke für die Datenplattform, sobald Agenten nicht mehr nur lesen, sondern schreiben, ausführen und verfeinern.
Technisch betrachtet läuft der Kreislauf des Agentic Data Coding über mehrere Stationen: Kontext erfassen, planen, Code erzeugen, ausführen und bewerten. Die Bausteine des Kontexts können aus Ontologien stammen, also strukturierten Beschreibungen von Begriffen und ihren Beziehungen, ergänzt um „AI-Skills“ oder Schnittstellen wie das Model Context Protocol (MCP). Zusätzlich spielen Datenzugriffs- und Kontextmechanismen wie RAG (Retrieval-Augmented Generation) sowie Kommandozeilenschnittstellen eine Rolle, weil sie dem Agenten gezielt relevante Informationen liefern, statt nur breite Datenmengen bereitzustellen. Evaluation und Observability liefern anschließend Rückmeldungen an Plattform und Semantik zurück, sodass sich Definitionen und Verarbeitungsschritte mit der Zeit anpassen können. In diesem Modell bleibt der Mensch Teil des Regelkreises: Er setzt Ziele, klärt Mehrdeutigkeiten, priorisiert Abnahmekriterien und überprüft Resultate, wenn es auf fachliche Gültigkeit ankommt.
Für die Datenplattform lassen sich die Anforderungen in drei Fähigkeitsblöcke gliedern. Erstens braucht die Plattform eine strukturierte Sicht auf Unternehmensdaten und Geschäftslogik: Ontologien, Semantik, Metadatenmanagement, Governance und Security. Zweitens muss sie Veränderungen kontrolliert nachverfolgen, und genau hier übernimmt Agentic Data Coding Prinzipien aus der Softwareentwicklung. Versionskontrolle, Git-Integration und CI/CD schaffen vergleichbare Arbeitsweisen für Code, Daten und semantische Definitionen. Dazu kommen Branching- und Sandbox-Umgebungen, damit parallel an Varianten getestet werden kann, ohne produktive Systeme sofort zu beeinflussen; Simulationen erweitern die Testmöglichkeiten, bis sich Ergebnisse zuverlässig bewerten lassen. Drittens steht die Überprüfbarkeit im Fokus: Eine integrierte Evaluation und Observability sollen transparent machen, wie Ergebnisse zustande kommen und ob sie fachliche Anforderungen erfüllen. Die Quelle beschreibt dabei ein „halbautomatisches“ Vorgehen als Zielbild, bei dem automatisierte Tests durch menschliche Validierung ergänzt werden, etwa bei Datenverträgen, Analytics-Anforderungen und Kennzahlen.
Eine zentrale Rolle spielt dabei die semantische Schicht als gemeinsame Referenz, im Text als „Single Source of Truth“ bezeichnet. Unternehmen sollen demnach einen belastbaren Semantic Layer etablieren, der nicht nur Begriffe bündelt, sondern auch Zusammenhänge so abbildet, dass Agenten über unterschiedliche Anwendungsfälle hinweg konsistente Ergebnisse liefern. Der Haken: Semantik altert nicht nur technisch, sondern organisatorisch. Deshalb muss der Semantic Layer anhand von Evaluationsergebnissen, Feedback und veränderten Anforderungen fortlaufend gepflegt werden. Bleiben widersprüchliche oder veraltete Definitionen bestehen, entsteht „Semantic Debt“ – semantische Altlasten, die Agenten in plausible, aber fachlich falsche Richtungen führen können. Damit wird Semantik zu einem Betriebsmodell, nicht zu einem einmaligen Datenmodellprojekt.
In der Architekturentscheidung wird außerdem sichtbar, wie stark Unternehmen sich binden oder entkoppeln können. Der plattformeigene Ansatz integriert semantische Schicht, Coding Agent und Anwendungsbereitstellung eng im jeweiligen Ökosystem. Das kann Anpassungsaufwand reduzieren und vorgefertigte Funktionen liefern, birgt aber das Risiko eines Vendor Lock-in und erschwert plattformübergreifende Integration. Der herstellerunabhängige Weg verspricht mehr Flexibilität, erfordert dafür jedoch deutlich mehr Entwicklungs- und Integrationsarbeit: Semantische Schichten, Governance, Evaluation und Testumgebungen müssen selbst aufgebaut oder orchestriert werden. In der Praxis entstehen zudem hybride Modelle, weil die Grenzen zwischen beiden Ansätzen durch die zunehmende Kopplung von Semantik und Agenten-Tooling weiter verschwimmen.
Nicht zuletzt nennt die Quelle Risiken, die über Vendor-Entscheidungen hinausgehen. Dazu gehören steigende Rechen- und Entwicklungskosten sowie die Tatsache, dass viele Werkzeuge noch nicht für den direkten Unternehmenseinsatz „out of the box“ ausreichend geeignet sind. Externe MCP-Server, Plug-ins oder Skills müssen in abgeschotteten Testumgebungen geprüft werden, bevor sie in produktive Workflows gelangen. Genannt werden außerdem Angriffsflächen wie Prompt- und Tool-Poisoning, also manipulierte Anweisungen oder kompromittierte Tools, sowie Angriffe auf die technische Lieferkette. Parallel entwickeln sich Governance-Mechanismen für Agentic Data Coding erst; eine zu starke Automatisierung ohne geeignete menschliche Kontrolle kann Fehler nicht nur ausführen, sondern verstärken. Ebenso riskant ist fehlende organisatorische Abstimmung: Wenn Teams keine gemeinsame Semantik herstellen, wird selbst die beste Technik zur Hürde für eine unternehmensweit konsistente Datenbasis.
Für die Umsetzung empfiehlt sich ein schrittweiser Einstieg über operative Anwendungsfälle im Datenmanagement, statt direkt die komplette Plattform umzubauen. Mit wachsender Erfahrung kann der Umfang ausgeweitet werden, wobei AI-Skills, Evaluation, Schutzmechanismen und DataOps-Praktiken wie CI/CD und Observability von Beginn an als Anforderungen an den produktiven Betrieb betrachtet werden sollten. Entscheidend ist zudem die Zusammenarbeit zwischen Data Platform Engineers, AI Engineers und Fachexperten: Sie müssen gemeinsam eine semantische Schicht schaffen, die auch bei veränderten Geschäftsanforderungen vertrauenswürdig bleibt. Dazu gehören im Entwicklungsprozess Versionsmanagement, Tests, Governance und feste Evaluationspunkte; parallel müssen Unternehmen Kosten sowohl in der Entwicklungsphase als auch im laufenden Betrieb sichtbar steuern. Genau in diesem Zusammenspiel zeigt sich die eigentliche Konsequenz der Gartner-Einordnung: Datenplattformen werden damit weniger „Ort zur Ablage“ und stärker „laufende Entwicklungs- und Validierungsumgebung“ für KI-gestützte Programmieragenten.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Coding Agents machen die Datenplattform zur Entwicklungs- und Semantikschicht" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Coding Agents machen die Datenplattform zur Entwicklungs- und Semantikschicht" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Coding Agents machen die Datenplattform zur Entwicklungs- und Semantikschicht« bei Google Deutschland suchen, bei Bing oder Google News!