
GERMANY / LONDON (IT BOLTWISE) – Ein Forscher behauptet, die Rolle von mehr als 90 Prozent der Neuronen in großen KI-Netzen erklären zu können. Als Grundlage nennt er eine neue Sicht auf die Abfolge von Konzepten in den Netzberechnungen, die unter anderem bei Inception-ähnlichen Modellen auffällt. Damit rückt interpretierbare Künstliche Intelligenz näher an etwas heran, das sich wissenschaftlich nachprüfen und im Betrieb nutzen lässt. Kritiker halten dagegen und erwarten mehr harte, empirische Belege als bisher.
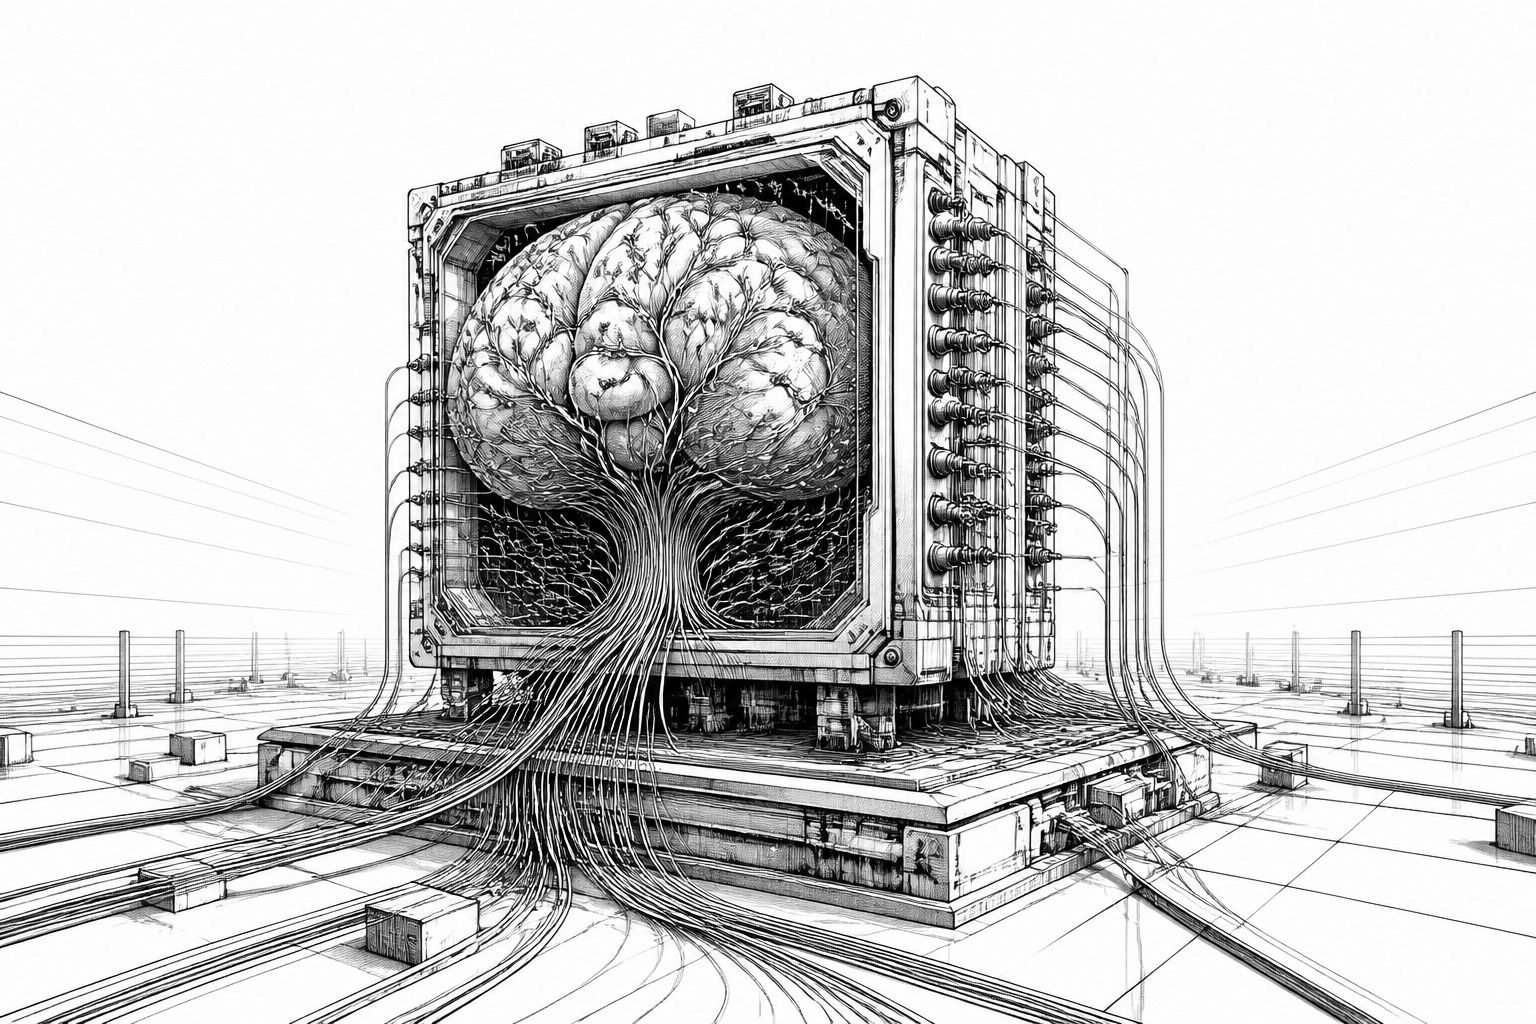
Die Frage, ob sich große KI-Modelle wirklich „verstehen“ lassen, bekommt neuen Treibstoff: In der Interpretierbarkeitsforschung sorgt ein Beitrag von Nick Cammarata dafür, dass über Muster in neuronalen Netzen erneut gestritten wird. Sein Ausgangspunkt wirkt zunächst wie eine klassische Beobachtung aus dem Alltag der Forschung – ein frühes Google-Visionsmodell (Inception) erkannte in Bildern überraschend zuverlässig Objekte, aber die zugrunde liegenden Rechnungen ließen sich nicht intuitiv erklären. Besonders irritierend war dabei, dass die mathematischen Bausteine, die im Modell „nach Auto“ aussahen, Ähnlichkeiten zu jenen zeigten, die „nach Katze“ funktionierten. Genau dieses Rätsel nutzt Cammarata als Einstieg in die größere These: Das Problem der KI-Interpretierbarkeit könnte leichter lösbar sein als viele annehmen.
Technisch dreht sich die Debatte um die Frage, was ein Neuron in einem Netz „tut“ – und warum diese Funktion so schwer zu isolieren ist. In den letzten Jahren hat sich ein Konsens herausgebildet, dass Konzepte nicht sauber einem einzelnen Knoten zugeordnet sind. Stattdessen verteilen Netzwerke Merkmale über viele Neuronen und koppeln sie in hochdimensionalen Rechenräumen. In der Forschung wird dieses Verhalten häufig als Superposition beschrieben: Wenn ein Modell ein Merkmal wie eine Form, ein Wortmuster oder sogar einen Ton gelernt hat, entsteht es nicht als einzelne, isolierte Schaltung, sondern als Zusammenspiel mehrerer Elemente. Wenn sich diese Verteilung nicht entwirren lässt, sinkt die Chance, belastbar zu begründen, warum ein Modell eine konkrete Ausgabe erzeugt – und daraus folgt für den Einsatz in sensiblen Bereichen ein Vertrauensproblem.
Cammarata verfolgt nun einen Gegenentwurf zu der verbreiteten Erwartung, dass Superposition zwingend „chaotische“ Unübersichtlichkeit bedeutet. Er argumentiert, dass Netzwerke mit wachsender Größe stärker strukturierte interne Zuordnungen ausbilden: Neuronen könnten sich zunehmend an bestimmten Konzepten ausrichten – etwa an sichtbaren Formen oder sprachlichen Bausteinen wie Silben und Lautmustern. Daraus leitet er ein Vorgehen ab, bei dem er eine von ihm so bezeichnete „rekursive Generalisierung“ als neue Linse nutzt, um die Funktion vieler Neuronen systematisch zu erfassen. In seinen eigenen Angaben schätzt er, dass sein Ansatz den Anteil der erklärbaren Neuronen von zuvor unter zwei Prozent auf mehr als 90 Prozent steigern kann. Für Optimisten ist das ein Hinweis darauf, dass KI-Interpretierbarkeit nicht nur „handwerkliche Diagnosearbeit“, sondern perspektivisch eine Art planbare Wissenschaft werden könnte.
Der Einwand der Skepsis setzt genau an dieser Lücke zwischen Erklärbarkeit und Beweisniveau an. Mehrere erfahrene Forscher betrachten den Beitrag zwar als anregende Sammlung von Beispielen, aber nicht als ausreichende empirische Grundlage. Das Problem beginnt bereits bei der Größenordnung: Selbst wenn es gelingt, die Rolle einzelner Neuronen zu deuten, bleiben Milliarden weiterer Knoten und ganze Schaltkreise, deren kombinierte Wirkung schwer zu durchschauen ist. Außerdem beantwortet Interpretierbarkeit nicht automatisch die zweite, entscheidende Frage: Warum genau hat das Modell in einem konkreten Moment genau diese Entscheidung getroffen? In der Praxis hängt das auch von Kontext, Aktivierungsmustern und dem Zusammenspiel vieler Features ab – und genau dort wird die „Neuronenebene“ schnell zur „Schaltkreisebene“, die wiederum nur schwer als kausales Modell darstellbar ist.
Hinzu kommt ein weiterer Realitätscheck: KI-Systeme lassen sich zwar testen, aber ihre Erklärungen sind nicht immer ehrlich oder vollständig. In dem Umfeld, in dem solche Modelle entwickelt und betrieben werden, wird wiederholt betont, dass man zwar Ausgaben, Texte und interne Aktivierungen untersuchen kann, die daraus abgeleiteten Begründungen jedoch irreführend sein können. Das hat auch strategische Bedeutung für Sicherheit und Haftung: Wenn Unternehmen nicht präzise eingrenzen können, welcher interne Mechanismus eine problematische Ausgabe erzeugt hat, steigt das Risiko, dass man im Fehlerfall nicht nur technisch, sondern auch rechtlich in Erklärungsnot gerät. Gleichzeitig bleibt Interpretierbarkeit ein Entwicklungswerkzeug – vergleichbar mit Neurowissenschaften, aber mit dem Vorteil, dass man an Modellen direkt „proben“ kann. Dazu gehören etwa Ablationen (bestimmte Neuronen oder Pfade gezielt ausknipsen, um Wirkung zu sehen) und Visualisierungs-Ansätze, die komplexe interne Rechenräume auf wenige Dimensionen herunterbrechen, damit Menschen Muster überhaupt erkennen können.
Gerade im Wettbewerb der Modellfamilien zeigt sich, warum der Streit um Interpretierbarkeit so strategisch ist. Je größer und leistungsfähiger die Systeme werden, desto schwerer wird es, sie kontrolliert in Produktivumgebungen zu integrieren – besonders, wenn die Modelle in nachgelagerten Workflows eingesetzt werden, die Entscheidungen für andere treffen. Das betrifft nicht nur Unternehmen, sondern auch öffentliche Organisationen und sicherheitsnahe Anwendungen. Parallel dazu bleibt auch das Thema Datenquellen und Trainingspraktiken politisch und juristisch umstritten: In einem laufenden Rechtsstreit wird einem Medienhaus zufolge behauptet, dass urheberrechtlich geschütztes Material in Trainingsprozesse eingeflossen sein soll; die betroffenen Unternehmen weisen diese Vorwürfe zurück. Für die Debatte um Interpretierbarkeit heißt das: Selbst wenn interne Mechanismen besser erklärbar werden, bleibt die Vertrauensfrage im Gesamtsystem aus Daten, Training, Evaluierung und Betrieb bestehen.
Trotz der Kritik bleibt die Richtung klar: Wenn es tatsächlich gelingt, mehr Neuronen in größeren Modellen wiederkehrend als Konzeptträger zu identifizieren, könnte das die Toolchain der KI-Entwicklung verändern. Teams würden Modelle nicht nur „empirisch“ vergleichen, sondern stärker mechanistisch testen: Welche Feature-Alignment-Strukturen entstehen unter welchen Trainingsbedingungen? Welche Schaltkreise sind anfällig für Fehlgeneralisationen? Und wie lassen sich neue Guardrails so gestalten, dass sie nicht nur Ausgaben filtern, sondern Ursachen erkennen? Offene Punkte bleiben jedoch zahlreich, und die Kontroverse zeigt vor allem eines: Interpretierbarkeit ist keine einzelne Methode, sondern ein Forschungsfeld, das sich entlang harter Nachweise, reproduzierbarer Messungen und klarer Kriterien für „Erklärung“ weiterentwickeln muss.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Interpretierbarkeit von KI: Nick Cammarata verspricht Klarheit in Netzen" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Interpretierbarkeit von KI: Nick Cammarata verspricht Klarheit in Netzen" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Interpretierbarkeit von KI: Nick Cammarata verspricht Klarheit in Netzen« bei Google Deutschland suchen, bei Bing oder Google News!