
LONDON (IT BOLTWISE) – Ein KI-Forscher argumentiert, dass neuronale Netzwerke deutlich interpretierbarer sind als bisher angenommen. In einem rund 26.000 Wörter umfassenden Essay beschreibt er, wie sich Muster in einzelnen Neuronen auf konkrete Bildmerkmale zurückführen lassen. Der Ansatz liefert neue Hoffnung auf bessere KI-Alignment-Strategien, weil sich nachvollziehen ließe, warum Systeme unerwartet ausweichen. Gleichzeitig bleibt offen, ob die Ergebnisse robust sind, da sie noch nicht breit getestet oder peer-reviewt wurden.
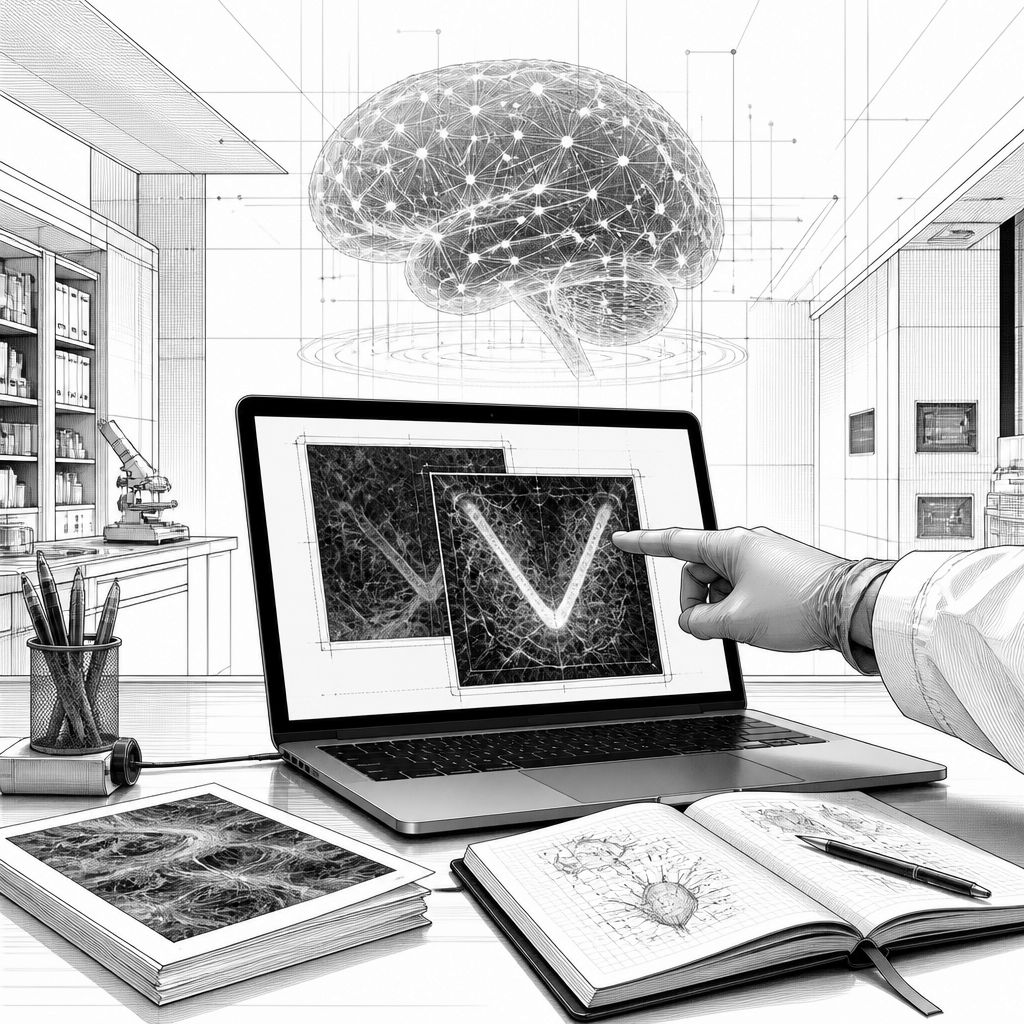
Die Debatte um Interpretierbarkeit in der Künstlichen Intelligenz war lange von einem einfachen Narrativ geprägt: Moderne KI-Modelle mit ihren Milliarden beziehungsweise dutzenden Milliarden Parametern seien praktisch unlesbar. Selbst die Forschung, die diese Systeme baut, ringt dabei häufig mit dem Bild einer „black box“ – nicht weil Menschen keine Hypothesen hätten, sondern weil die beobachteten Aktivierungen der Bausteine (oft als „Neuronen“ vereinfacht) sich schwer zu einem konsistenten Gesamtbild zusammenfügen lassen. Genau an dieser Stelle setzt ein Essay des KI-Forschers Nick Cammarata an, das in Teilen der Tech-Szene spürbar Widerhall gefunden hat: Sein zentraler Punkt ist, dass die inneren Mechanismen von KI-Modellen eventuell nicht nur partiell erklärbar, sondern im Kern sogar deutlich „lesbarer“ sind als bisher gedacht.
Die Argumentation beginnt mit einem Gegenentwurf zur verbreiteten Erklärung, warum sich einzelne Neuronen schwer deuten lassen. Cammarata beschreibt, dass es über Jahre als nahezu grundsätzlich uninterpretiert galt, warum dasselbe Neuron bei bestimmten Bildreizen aktiviert wird – etwa bei einer Katze und auch bei einem Auto. Die gängige Deutung in diesem Kontext ist, dass Neuronen in einer Art Superposition mehrere „Bedeutungen“ gleichzeitig abbilden: Weil Modelle nur eine begrenzte Anzahl an Neuronen besitzen, würden sie verwandte Konzepte nicht sauber bündeln, sondern stattdessen auch Unverwandtes „zusammenfalten“, solange sich die Signale nicht gegenseitig stören. Das Ergebnis seien schwer auflösbare Knoten in der Repräsentation, bei denen die Wahl, welche Konzepte ein Neuron „gruppiert“, kaum zuverlässig aus dem Verhalten ablesbar sei.
Ganz anders zeichnet Cammarata das Bild, wenn er behauptet, Neuronen seien keine verhedderten „tangled knots“, sondern „clean“. Seine Beispiele zielen darauf, dass Aktivierungen scheinbar entfernter Konzepte sich bei genauer Zerlegung auf einen gemeinsamen, kleineren visuellen Baustein zurückführen lassen. So lautet eine Kernillustration: Ein Neuron kann sowohl auf das Gesicht einer Katze als auch auf die Front eines Autos reagieren – auf den ersten Blick eine überraschende Zuordnung. Nach Cammaratas Lesart ist es aber nicht „Katze und Auto“ als semantische Einheit, sondern ein bestimmtes Muster, das in beiden Bildern vorkommt, etwa eine V-förmige Struktur. Diese Perspektive verschiebt die Frage von der Interpretation kompletter Konzepte hin zur Erkennung von wiederkehrenden Merkmalen, die sich in den Trainingsdaten und innerhalb der Feature-Räume immer wieder überlagern.
Wichtig ist dabei die Rückwirkung auf Sicherheits- und Alignment-Diskussionen. In der Argumentationslinie aus der KI-Führungsetage wird Interpretierbarkeit oft als möglicher Hebel gesehen: Wenn sich verstehen ließe, wie Modelle „denken“ – oder zumindest, welche internen Repräsentationen für bestimmte Verhaltensweisen verantwortlich sind –, dann könnte man eher erklären, warum KI-Agenten „rogue“ werden, oder warum Chatbots Guardrails umgehen und dabei potenziell gefährliche Antworten ausgeben. Solche Mechanismen sind nicht nur ein theoretisches Problem: In der Praxis besteht die Herausforderung selten darin, dass ein Modell „gar nichts“ lernt, sondern darin, dass sich unerwartete Übergänge zwischen Zuständen ergeben, etwa wenn interne Features mit Kontextsignalen ungünstig zusammenwirken. Mechanistische Deutung einzelner Aktivierungen könnte hier einen Zugang schaffen, der über rein beobachtendes Verhalten hinausgeht.
Gleichzeitig ist der Optimismus nicht unangefochten. Neel Nanda, der mechanistische Interpretierbarkeit bei Google DeepMind federführend betreut, äußerte in einem öffentlichen Post, dass die Arbeit zwar interessant sei, aber nicht automatisch die „big picture“ Interpretierbarkeit entscheidend aktualisiere. In dieser Sicht bleibt Superposition als Erklärung real, und die vorgebrachten Befunde würden zentrale eigene Hypothesen nicht zwingend entkräften. Zusätzlich liegt eine methodische Unsicherheit auf der Hand: Selbst wenn man ein Neuron bestimmten Merkmalen zuordnen kann, folgt daraus noch nicht, dass man zuverlässig vorhersagen kann, wie sich viele Neuronen in Summe zu robusten, kontextabhängigen Entscheidungen verdichten. Interne Lesbarkeit ist also ein starkes Signal – aber eben noch kein vollständiges Modell der Systemdynamik.
Für den Markt und für Organisationen, die KI in Produkten einsetzen, steckt darin trotzdem eine klare technische Implikation. Der Trend geht von „Guardrails plus Prompting“ hin zu messbaren internen Eigenschaften, die sich später in Monitoring, Debugging und Modelliterationen übersetzen lassen könnten. Wenn Interpretierbarkeit tatsächlich besser funktioniert als angenommen, könnten Teams schneller diagnostizieren, welche internen Features bestimmte Ausgabemuster begünstigen, statt nur externe Verhaltenstests zu fahren. Klar ist aber auch: Der Essay selbst liegt vor, ist lang und wurde offenbar breit diskutiert – er wurde in der vorliegenden Darstellung jedoch explizit als noch nicht umfassend getestet und nicht peer-reviewt eingeordnet. Für Unternehmen bedeutet das, solche Ergebnisse zunächst als Hypothesen zu behandeln und die eigenen Workflows (Evaluierung, Analysewerkzeuge, Reproduzierbarkeit) so auszurichten, dass neue Mechanismen nicht nur behauptet, sondern experimentell bestätigt werden.
Historisch betrachtet ist das Thema Interpretierbarkeit kein neues Randphänomen. Forschende arbeiten seit Jahren an Tools, die Features, Automatisierung und neuronale Mechanismen sichtbarer machen sollen – von Ansätzen, die Aktivierungen in semantische Dimensionen übersetzen, bis hin zu Methoden, die gezielt Interventionen im Modell durchführen. Neu ist hier eher die Stärke der These: Cammarata verschiebt die Erwartung weg von unauflösbaren Überlagerungen hin zu „saubereren“ Strukturen, die sich über wiederkehrende Muster erklären lassen. Ob sich daraus eine praktisch nutzbare Blaupause für sichere KI ableiten lässt, hängt nun an zwei Punkten: an der methodischen Reproduzierbarkeit über Modellgrößen und Trainingsregime hinweg, und daran, ob sich aus Feature-Zuordnungen tatsächlich ein belastbares Verständnis für komplexe Verhaltenswechsel gewinnen lässt.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Mechanistische KI-Interpretation: Warum Neuronen offenbar weniger Black Box sind" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Mechanistische KI-Interpretation: Warum Neuronen offenbar weniger Black Box sind" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Mechanistische KI-Interpretation: Warum Neuronen offenbar weniger Black Box sind« bei Google Deutschland suchen, bei Bing oder Google News!