
LONDON (IT BOLTWISE) – Eine lang beschriebene Arbeit des KI-Forschers Nick Cammarata stellt die verbreitete Black-Box-These zu generativen Modellen infrage. Er behauptet, dass sich einzelne Neuronen samt ihren Funktionen konsistent verstehen lassen. Die Diskussion reicht bis zu Fragen nach KI-Sicherheit, also ob sich damit Risiken wie Fehlverhalten oder irreführende Modellverhalten besser kontrollieren lassen. Gleichzeitig bleiben wichtige Grenzen, weil die Ergebnisse vorerst nicht peer-reviewt und stark an Vision-Modelle gebunden sind.
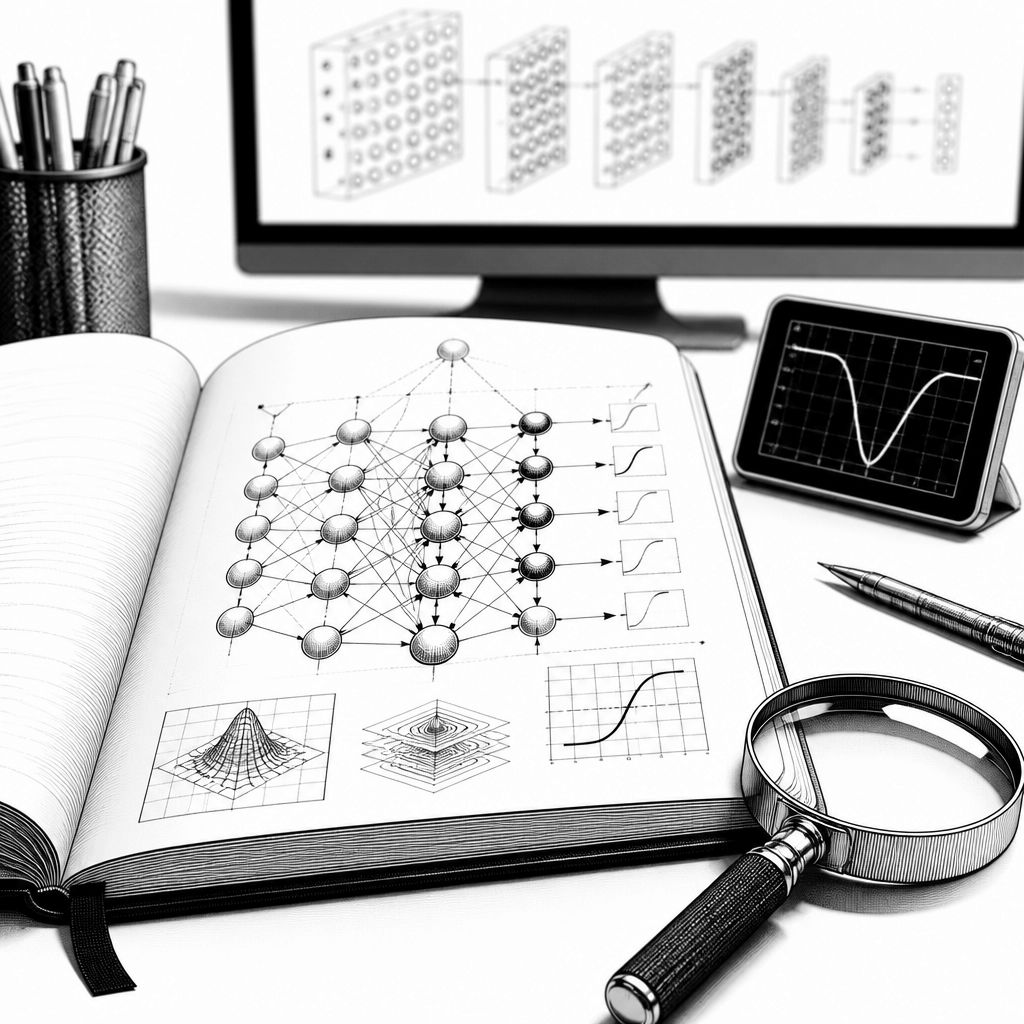
Seit über einem Tag kreist die KI-Community um eine außergewöhnlich lange Abhandlung von Nick Cammarata, die in den letzten Jahren entstandene Annahmen über die Nachvollziehbarkeit neuronaler Netze herausfordert. Ausgangspunkt ist die verbreitete Vorstellung, dass große generative Systeme wegen ihrer schieren Komplexität praktisch undurchschaubar seien. Cammarata argumentiert dagegen, dass es einen methodischen Pfad gibt, um die inneren Mechanismen nicht nur irgendwie zu beobachten, sondern strukturiert zu verstehen. Genau dieser Anspruch trifft einen wunden Punkt der Branche: Nach Monaten intensiven Experimentierens, mit wachsender öffentlicher Skepsis gegenüber den Folgen von KI-Systemen, suchen viele Teams nach Werkzeugen, die Kontrolle nicht nur über die Nutzungsoberfläche, sondern über die Modelllogik ermöglichen.
Technisch setzt der Ansatz bei der Forschung zur mechanistic interpretability an. In neuronalen Netzen sind Neuronen keine symbolischen Bausteine im klassischen Sinn, sondern Taktgeber in einem Rechengraphen: Sie werden durch Muster in den Trainingsdaten aktiviert und leiten dann Informationen weiter. Frühere Arbeiten – einschließlich der eigenen Vorarbeiten von Cammarata – hatten gezeigt, dass einzelne Neuronen überraschend vielfältig reagieren können. Ein Neuron kann etwa nicht nur auf eine Kategorie wie „Katze“ ansprechen, sondern innerhalb derselben Modellinstanz ebenso auf Bildteile wie Beine oder selbst auf ganz andere visuelle Kontexte, etwa bestimmte Strukturen in Fahrzeugdarstellungen. Die naheliegende Erklärung war bislang, dass diese Knoten ihre Rolle umverteilen müssen, weil die Zahl der „Neuronen“ in der Modellarchitektur viel geringer ist als die Menge an Informationen, die das Modell insgesamt verarbeitet.
Das neue Argument dreht diese Deutung um: Cammarata beschreibt die Aktivierung einzelner Neuronen als nicht willkürlich, sondern als funktional konsistent. Seine Kernmetapher lautet, dass neuronale Netze nicht wie ein „verhedderter Knoten“ funktionieren, sondern wie ein „sauberes“ System. Als anschauliches Beispiel nennt er Neuronen, die formal zwar „katzen- oder wagenbezogen“ wirken, in der Tiefe aber auf konkrete visuelle Merkmale reagieren – etwa auf V-förmige Strukturen. Interessant ist dabei weniger die einzelne Beobachtung als die Konsequenz: Wenn sich die Funktion von Neuronen tatsächlich auf nachvollziehbare Signalmerkmale reduzieren lässt, wird die innere Mechanik potenziell erheblich weniger geheimnisvoll. Aus Sicherheitssicht ist das ein erheblicher Unterschied zu einer reinen Black-Box-Interpretation, weil sich dann Hypothesen über Fehlverhalten überhaupt erst systematisch prüfen lassen.
Allerdings ist die Fachdebatte ebenso schnell in die Methodik- und Bewertungsfrage geraten. Cammaratas 26.000 Wörter werden in der Darstellung selbst als Arbeitsannahme beschrieben, die auf eine zukünftige technische Veröffentlichung zielt; der Blog-Post ist damit nicht der klassische Startpunkt für eine begutachtete Studie. Außerdem liegt der Fokus laut Diskussionen besonders auf Vision-Modellen – also auf Modellen, die oft weniger komplexe interne Strukturen als große Sprachsysteme zeigen als die Grundlage vieler verbreiteter KI-Assistenten. Das heißt nicht, dass die Schlussfolgerungen falsch sein müssen, aber es verschiebt die Beweiskraft: Was an einem Modelltyp plausibel wirkt, lässt sich nicht automatisch auf große Sprachmodelle übertragen. Genau hier setzt eine zweite Ebene der Skepsis an: Selbst wenn man die Funktion möglichst vieler Neuronen annähert, könnte das noch immer nicht bedeuten, dass man versteht, wie sich die einzelnen Teile zu einem Gesamtverhalten verdichten.
In der Debatte wird diese Grenze von mechanistischer Interpretierbarkeit deutlich gemacht. Neel Nanda, der bei mechanistic interpretability bei Google DeepMind federführend ist, beschreibt sinngemäß, dass ein approximiertes „Wissen über Teile“ nicht automatisch ein vollständiges Verständnis des Zusammenspiels ergibt – ähnlich wie Physiker zwar gute Modelle für Atome haben, aber nicht aus Prinzip jedes Ereignis exakt vorhersagen können. Der Vergleich zielt auf ein fundamentales Problem: Sicherheit hängt nicht nur davon ab, wie gut man die inneren Zustände erklärt, sondern ob sich daraus stabile, verifizierbare Zuverlässigkeit ableiten lässt. Zudem zeigt die Diskussion ein weiteres Spannungsfeld der Branche: In Silicon Valley trifft ein Sicherheitsnarrativ oft auf den Wunsch nach schnellen technischen Lösungen und auf eine Historie, die gemischte Ergebnisse beim „Nachziehen“ von Versprechen liefert. In diesem Licht wird es für viele schwer, die Begeisterung um den Essay ohne Vorbehalt zu teilen.
Gleichzeitig gehen Befürworter davon aus, dass ein echter Durchbruch bei Interpretierbarkeit mehr als nur akademischen Wert hätte. Adam Majmudar, ebenfalls als KI-Forscher bekannt, kommentierte in der Debatte: „This is truly one of the greatest cases for optimism in years!“ Zudem bleibt die Reichweite des Versprechens konkreter, als man es von reinen Spekulationen erwarten würde: Wenn Teams ihre Modelle „lesbar“ machen können, könnte das die Grundlage für gezieltere Audits, für weniger Überraschungen im Betrieb und für neue Entwicklungsprozesse liefern. Cammarata selbst ordnete seine Ergebnisse für größere moderne Sprachmodelle vorsichtig ein und schrieb, sein Ansatz „seems promising so far“ für „bigger modern language models“. Genau diese vorsichtige Formulierung wirkt wie ein Richtungsmarker: Interpretierbarkeit könnte ein Baustein sein – aber sie ersetzt nicht die Notwendigkeit, Systeme über alle Ebenen hinweg zu testen.
Für die Industrie bedeutet das vor allem einen Organisations- und Prozesswechsel. Wenn die Hypothese stimmt, müssen Anbieter nicht nur Modelle trainieren, sondern auch dauerhaft in der Lage sein, interne Mechanismen mit Methoden der mechanistischen Interpretierbarkeit zu dokumentieren und zu verifizieren. Solche Arbeiten sind selten „einmal erledigt“, weil neue Modellversionen, Datenmischungen und Trainingsregime schnell zu neuen Aktivierungsmustern führen. Dazu kommt eine zweite Realität: Ohne ernsthafte Regulierung liegt der Schritt von der Forschung zum Produkt derzeit primär bei den Unternehmen selbst. Der Kern der Debatte ist daher weniger das „Ob“ der Wissenschaft, sondern das „Wie schnell“ und „Wie verlässlich“ sich Erkenntnisse in robuste Produkte übersetzen lassen. Gerade bei sicherheitsrelevanten Themen wird der Unterschied zwischen Erklärbarkeit und tatsächlicher Verlässlichkeit entscheidend.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Maschinelle Interpretierbarkeit: Warum Generative KI angeblich keine Black Boxes sind" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Maschinelle Interpretierbarkeit: Warum Generative KI angeblich keine Black Boxes sind" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Maschinelle Interpretierbarkeit: Warum Generative KI angeblich keine Black Boxes sind« bei Google Deutschland suchen, bei Bing oder Google News!