


FRANKFURT / LONDON (IT BOLTWISE) – Am 1. Juli 2026 verdichten sich europa- und US-getriebene Konjunktursignale: PMI- und Verbraucherpreis-Veröffentlichungen treffen auf Unternehmens-Calls und Vorabzahlen. Für Unternehmen zählt dann nicht nur der Inhalt der Daten, sondern vor allem, wie schnell und zuverlässig sie in Analyse- und Reporting-Workflows ankommen. Der Artikel zeigt, wie event-getriebene Datenpipelines, Validierungsschichten und Datenschutzkontrollen dabei helfen, Marktbewegungen früh zu erkennen – ohne Compliance-Risiken zu erhöhen.
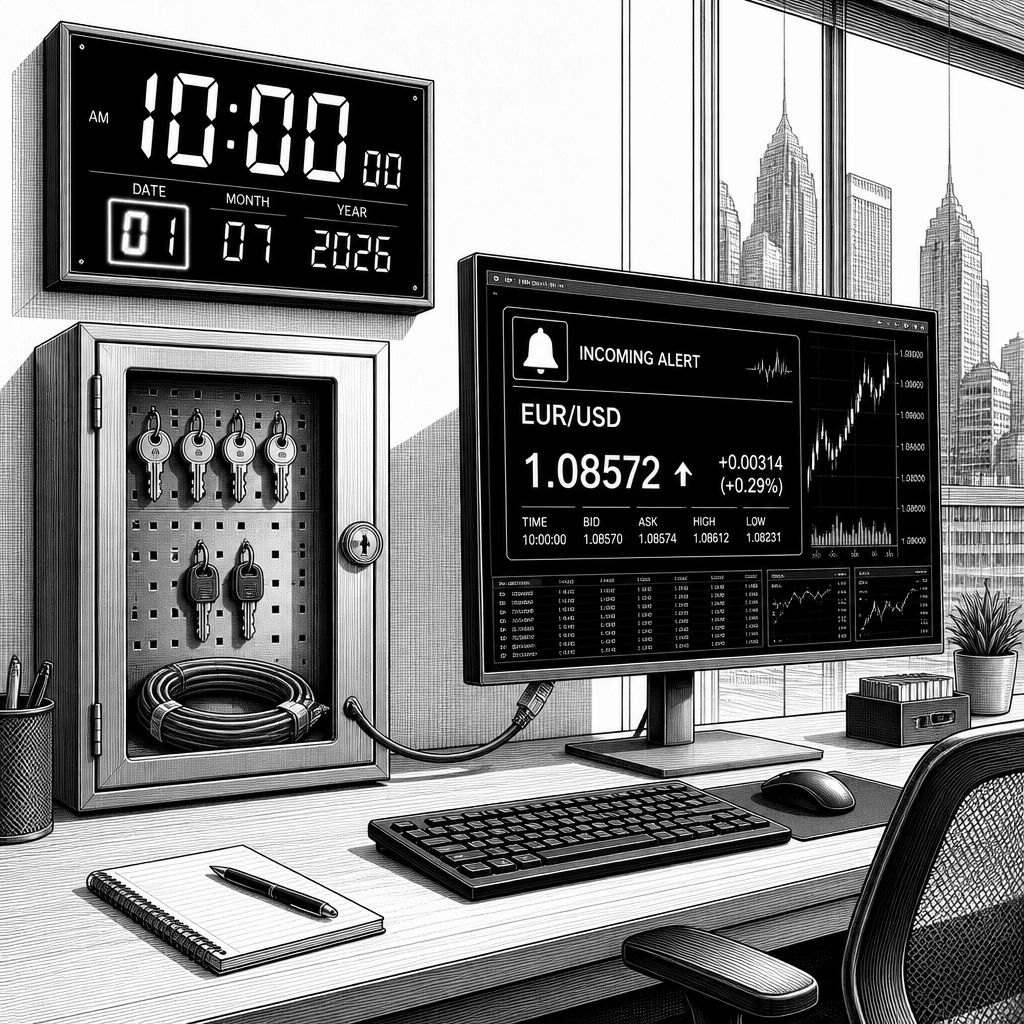
Am Mittwoch, dem 1. Juli 2026, wird aus einer reinen Terminliste ein operatives Stresstest-Szenario für datengetriebene Unternehmen. Zwischen Unternehmensmeldungen wie Q3-Umsätzen, Hauptversammlungen und Pre-Close-Calls sowie Konjunkturankern wie S&P-Global-PMIs, Verbraucherpreisen und Industrieproduktionszahlen entsteht über mehrere Zeitzonen hinweg ein dichter Takt. Für Treasury, Controlling, Risiko-Teams und Handelsnahe Bereiche entscheidet dann weniger die “richtige” Interpretation als die Fähigkeit, Daten in Echtzeit zu erfassen, gegen Referenzwerte zu prüfen und in Dashboards oder Entscheidungsmodelle einzuspeisen. Genau hier wird der Unterschied zwischen manuellem Copy-&-Paste und robusten Event-Workflows sichtbar.
Technisch betrachtet ist so ein Börsentag ein Paradebeispiel für eine event-getriebene Architektur. Anstatt feste Batch-Zeitpläne zu fahren, können Unternehmen “Termine” als Trigger in einer Pipeline modellieren: Sobald eine Veröffentlichung fällig ist (z. B. PMI-Ergebnisse in mehreren Währungen oder erneute Veröffentlichungen zu einem Index), werden automatisch Datenquellen abgefragt, Normalisierungen durchgeführt und Konsistenzchecks ausgeführt. Praktisch heißt das: Zeitstempel (MESZ), Währungsumrechnung, Länderzuordnung und Datenversionierung müssen identisch zu den historischen Referenzen sein. Ergänzend sollten Guardrails greifen, etwa Schema-Validierung (Feldtyp, Einheiten), Plausibilitätsgrenzen (z. B. Wachstumsraten) und eine Idempotenz-Strategie gegen doppelte Event-Zustellungen.
Historisch zeigen Kalender-Tage wie dieser, warum sich Unternehmensdatenplattformen vom reinen “Reporting am Tag danach” zu nahezu synchroner Entscheidungsunterstützung entwickelt haben. Noch vor einigen Jahren standen viele Teams vor der Lücke zwischen Informationsbeschaffung und Modellaktualisierung: Kurs- und Datenanbieter lieferten Informationen, aber die interne Verarbeitung war zu langsam. Moderne Ansätze setzen dagegen stärker auf KI-gestützte Vorverarbeitung oder Regelwerke für die Event-Klassifikation, ohne die faktische Quelle zu ersetzen. So lassen sich beispielsweise Headlines, die “zweite Veröffentlichung” oder “vorläufig” kennzeichnen, automatisch in Prioritäts- und Qualitätsstufen übersetzen. Das reduziert Reibung, wenn parallel mehrere Veröffentlichungen laufen, etwa Verbraucherpreis-Daten in EUR- und Landesdimensionen.
Im Marktumfeld geht der Wettbewerb längst über die Frage “Welche Quelle hat die schnellsten Zahlen?” hinaus. Neben großen Anbietern für Marktdaten und News-Feeds werden auch Plattformen für Datenintegration und Observability stärker genutzt, weil sie Abdeckung und Nachvollziehbarkeit verbessern. Als Wettbewerbsbezug nennen Experten häufig Bloomberg und Refinitiv, wenn es um Monitoring und Time-to-Insight geht, während spezialisierte Datenräume und Regelmotoren versuchen, diese Stärken in Unternehmensarchitekturen zu spiegeln. Ein Analyst brachte es sinngemäß auf den Punkt: “Wer am Veröffentlichungstag nur einen Feed abonniert, verliert Zeit an Validierung und Prozessbrüche.” Für Unternehmen bedeutet das: Die Differenz entsteht in der internen Pipeline, nicht im Abonnement.
Auch regulatorisch und datenschutzseitig ist ein solcher Tag kein Nebenthema. Zwar handelt es sich häufig um öffentliche Makrodaten und Unternehmensankündigungen, doch in der Realität mischen sich solche Informationen in Arbeitsabläufe mit internen Positionen, Kundendaten oder personenbezogenen Metadaten aus Nutzer-Interaktionen (z. B. wer welche Auswertung genehmigt hat). Darum sollten Zugriffsrechte granular sein, insbesondere auf Audit-Logs, die zeigen, welche Entscheidungsvorlagen wann entstanden sind. Selbst wenn keine sensiblen Personendaten verarbeitet werden, gelten in vielen Unternehmen interne Governance-Regeln: Datenherkunft dokumentieren, Quellen-IDs speichern und “Lineage” sicherstellen. Das wird besonders wichtig, wenn Analysen später in Risikoberichten oder Compliance-Fragen eingeordnet werden müssen.
Der konkrete Tag setzt außerdem auf eine klare Roadmap für Prioritäten. Unternehmensseitig fallen etwa Zeitpunkte wie 08:00 für Umsatzmeldungen, 10:00 Uhr für Hauptversammlungen oder am Nachmittag Pre-Close-Events zusammen, während Konjunkturdaten bereits deutlich früher durch die Nacht- und Morgenfenster laufen. Wer hier effizient sein will, braucht ein abgestimmtes Timing: Vor Veröffentlichung sollten Modelle auf Erwartungswerte und historische Volatilität kalibriert sein; nach Veröffentlichung müssen sie schnell aktualisieren, aber auch erkennen, ob es sich um eine “vorläufige” oder “zweite” Version handelt. Ein bewährter Vergleich ist dabei Cloud-native Verarbeitung gegenüber On-Premise: Cloud skaliert für Lastspitzen, während On-Premise bei strikten Latenz- oder Compliance-Vorgaben punktet. Viele Unternehmen kombinieren beide über eine Hybrid-Pipeline.
Auf der Marktimpact-Seite zeigt sich häufig ein Muster: Makrodaten (PMIs, Verbraucherpreise, Industrieproduktion) erzeugen breite Reaktionen, während Unternehmensveranstaltungen die “lokale” Volatilität verstärken können. Wenn am 1. Juli mehrere Index-Ergebnisse gleichzeitig in EUR und Landeswährungen nachgezogen werden, steigt die Wahrscheinlichkeit widersprüchlicher Interpretationen in Analystenteams. Deshalb hilft eine einheitliche Übersetzungsschicht: Aus Rohzahlen werden normalisierte Features, etwa Abweichungen zum Konsens oder Richtungssignale für Risikoindikatoren. Wichtig ist, dass diese Interpretation nicht “blind” automatisiert wird. Stattdessen sollte das System Konfidenzen ausgeben und Entscheidern ermöglichen, Schwellenwerte anzupassen. So wird aus dem Kalender ein steuerbares Instrument für Scalability und Security.
Für die Zukunft zeichnet sich ab, dass Termin- und Eventdaten zunehmend als Grundlage für Modelltraining und -betrieb genutzt werden. KI-gestützte Systeme können aus historischen Veröffentlichungstagen Muster ableiten, etwa welche Datenkombinationen in der Vergangenheit bestimmte Marktsegmente stärker bewegt haben. Doch der technische Engpass bleibt: Qualitätssicherung und Versionierung der Daten. Ohne konsistente Schemas, eindeutige IDs für Ereignisse und saubere Dokumentation der “vorläufigen” oder “finalen” Stufe wird das Training instabil. Eine realistische Entwicklungsperspektive ist daher, dass Unternehmen mehr in Datenverträge investieren: feste Felder, klar definierte Einheiten und automatische Regressionstests auf Pipeline-Ebene.
Wenn Sie solche Tage operativ vorbereiten, lohnt sich ein Fokus auf drei Dimensionen: robuste Event-Erkennung, sichere Verarbeitung und nachvollziehbare Auswertung. Erkennung bedeutet: Trigger, die exakt zur Terminlogik passen (mit MESZ-Umrechnung und Zeitzonenbehandlung). Sicherheit bedeutet: Rechte- und Log-Management, damit auch bei erhöhter Systemlast keine Regeln umgangen werden. Nachvollziehbarkeit bedeutet: Ergebnis-Cache mit Versionen, damit Sie später erklären können, welche Datenbasis zu welcher Zeit in welchem Modell genutzt wurde. Genau damit können Unternehmen auch an einem einzigen Veröffentlichungstag wie dem 1. Juli 2026 die Geschwindigkeit erhöhen, ohne Governance und Datenschutz zu vernachlässigen.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- NIEDLICHER BEGLEITER: Eilik ist der ideale Begleiter für Kinder und Erwachsene, die Haustiere, Spiele und intelligente Roboter lieben. Mit vielen Emotionen, Bewegungen und interaktiven Funktionen.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Börsentermin-Update am 1. Juli 2026: Daten- und Auswerteprozesse für Unternehmen unter Druck" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Börsentermin-Update am 1. Juli 2026: Daten- und Auswerteprozesse für Unternehmen unter Druck" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Börsentermin-Update am 1. Juli 2026: Daten- und Auswerteprozesse für Unternehmen unter Druck« bei Google Deutschland suchen, bei Bing oder Google News!