


NORTHERN CALIFORNIA / LONDON (IT BOLTWISE) – In den Gerichtsunterlagen zu Bartz v Anthropic PBC wird „Project Panama“ als Ansatz beschrieben, bei dem gedruckte Bücher destruktiv gescannt werden sollen, um ein KI-Sprachmodell zu trainieren. Das Dokument nennt als Kernargument die benötigten Datenmengen und die hohe Textqualität für ein Training vor allem vor 2022. Der Richter wertete das „Training“ eines LLM durch das Unternehmen nicht automatisch als Urheberrechtsverletzung. Damit rückt für KI-Teams weniger die juristische Erlaubnis als vor allem die Logistik in den Mittelpunkt.
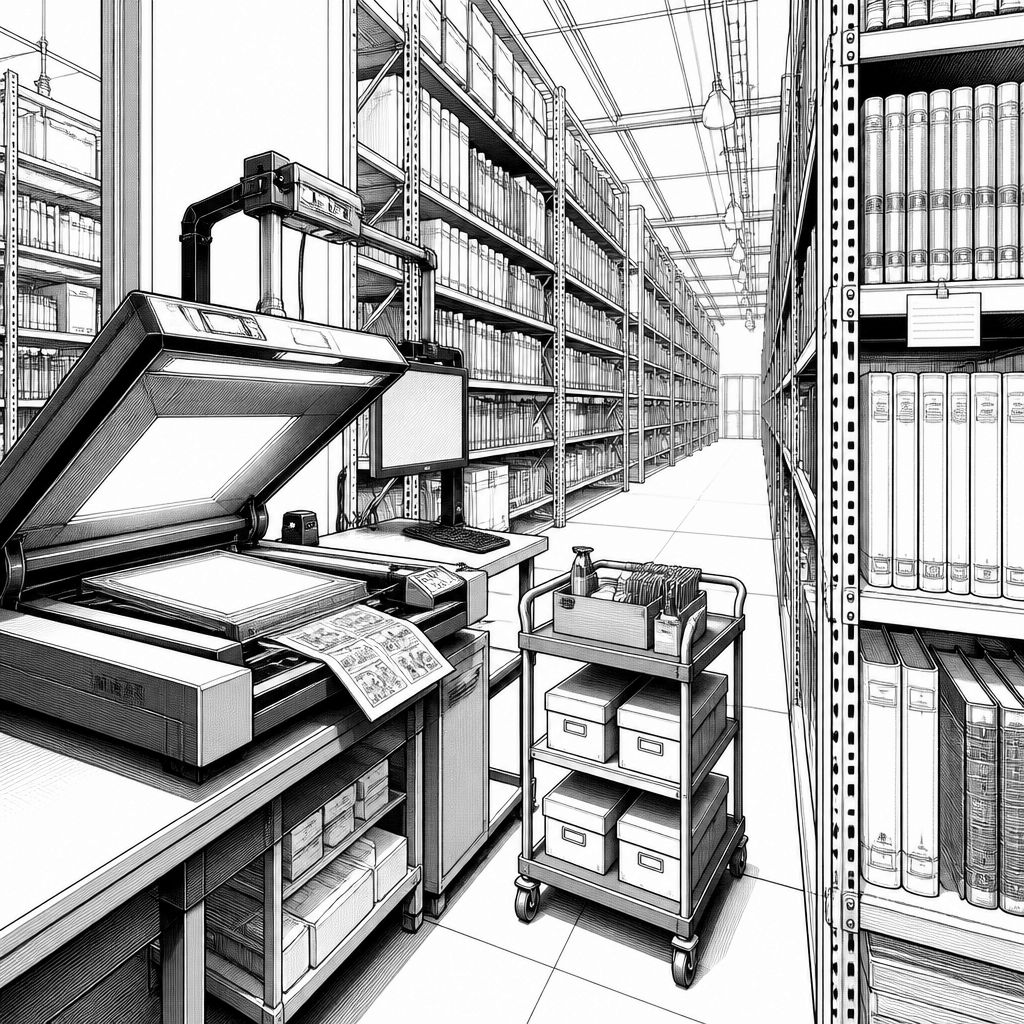
Der Fall Bartz v Anthropic PBC macht eine Frage sichtbar, die viele KI-Teams im Alltag nur abstrakt diskutieren: Wie beschaffen sich Sprachmodelle wirklich große, qualitativ hochwertige Textmengen, und was passiert dabei mit den physischen Quellen? In den Unterlagen wird hierfür „Project Panama“ genannt, ein interner Ansatz, der laut Exhibit 21 und begleitendem Memo nicht nur auf das Scannen, sondern ausdrücklich auf das „destruktive“ Vorgehen abzielt. Der Kern der Begründung ist weniger ein einzelnes Werk, sondern die Datenfrage: Für das Training von Claude brauchte das Unternehmen große Mengen an Sprache mit hoher Qualität und möglichst ohne den „corrupting influence“ moderner generativer Texte. Bücher gelten dabei als besonders geeignet, weil sie komplexe, langformatige Texte in hoher redaktioneller Qualität bündeln.
Technisch betrachtet geht es bei dieser Art Beschaffung um eine Grundvoraussetzung moderner KI-Entwicklung: Sprachmodelle profitieren stark davon, welche Form von Text in welcher Vielfalt ins Training gelangt. Die Unterlagen beschreiben, dass Anthropic besonders auf viele „language combinations“ setzte, um die Fähigkeit zu verbessern, sprachliche Ausgaben konsistent vorherzusagen. Damit wird auch verständlich, warum der Weg über gedruckte Werke in den Blick gerät: Im digitalen Raum sind Quellen häufig fragmentiert, uneinheitlich oder durch Lizenzen gebremst. Gedruckte Bücher liefern dagegen zusammenhängende Argumentationsketten, Stilmerkmale über viele Seiten hinweg und wiederkehrende Muster in Dialogen, Erzählungen oder Fachtexten. Allerdings verschiebt diese Logik die Problemzone: Wenn man „viel Text“ braucht, entscheidet nicht nur das Modelltraining über Erfolg oder Misserfolg, sondern ebenso die Datenpipeline – bis hin zur Frage, wie die Inhalte physisch in maschinenlesbare Daten umgewandelt werden.
Das juristische Zentrum des Konflikts liegt dabei auf dem Zusammenspiel von Urheberrecht, „fair use“ und der konkreten technischen Transformation. Im Text heißt es, der Richter habe das reine „Training“ eines Unternehmensprodukts anhand von proprietärem Material nicht automatisch als Infringement gewertet. Aus Sicht des Gerichts ist „training“ dabei vergleichbar mit dem menschlichen Lernen: Man macht aus Eingabe eine Fähigkeit zum Schreiben. Unter US-Recht erlaubt die „fair use“-Doktrin eine „transformative“ Nutzung, sofern die Bearbeitung über eine reine Reproduktion hinausgeht. Entsprechend beschreibt der Fall das Vorgehen als Remediation: Gedruckte Bücher werden aufgenommen, in eine neue elektronische Form überführt und die ursprüngliche gedruckte Kopie wird anschließend entsorgt – daher der Begriff „destructive scanning“. In den Unterlagen wird außerdem erwähnt, dass die Lieferanten die Bücher bereits in einem Vorprozess „von Bindungen befreien“ und die Seiten zugeschnitten hätten, damit das Scannen einfacher wird; der digitale Scan gilt danach als neu erzeugte Kopie, ohne dass der neue Stand außerhalb des Unternehmens gezeigt, geteilt oder verkauft worden sei.
Für den Markt ist das vor allem deshalb relevant, weil diese Entscheidung die Hürde für Nachahmung senken kann. Wenn das „transformative“ Argument und die konkrete Ausgestaltung der Datenbeschaffung als vertretbar gelten, wird der Engpass für andere generative KI-Anbieter deutlich stärker operational als rechtlich: Lagerkapazität, Vendor-Management, Qualitätskontrolle des Digitalisats, Skalierung der Scanprozesse sowie die Kontrolle, was nach dem Scannen tatsächlich mit dem physischen Bestand passiert. Der Fall beschreibt in diesem Zusammenhang eine Art Industrialisierung der Datenakquise: erfahrene Logistik, Bücher aus Vendor-Quellen, Personal im Warehouse und ein Digitization-Partner, der den destruktiven Teil umsetzt. In den Gerichtsbildern sieht man gestapelte Bücherregale; das „Cleanup“-Szenario – also das Zerlegen und Entsorgen der Papieroriginale – wird im Material eher als nachgelagerte, nicht sichtbare Aufgabe adressiert. Genau diese Trennung macht das Thema für KI-Produktverantwortliche brisant: Wer die Pipeline auf „maximale Datenmenge“ optimiert, braucht eine robuste Lieferkette für analoge Inhalte, selbst wenn der Ursprung physisch verschwindet.
Gleichzeitig öffnet sich damit eine breitere Diskussion über kulturelle Schutzmechanismen, die im Text ausdrücklich mit dem US-Kontext verknüpft wird: Es gebe nur wenige rechtliche Vorgaben, die die Behandlung oder den Export amerikanischen kulturellen Erbes umfassend regeln. Aus dieser Perspektive ist die Digitalisierung allein noch nicht das Problem – problematisch wird die Kombination aus Skalierung und fehlendem formalen Verständnis des Buchs als schützenswertes Kulturobjekt. Der Artikel betont, dass es keine klaren Listen für „gefährdete“ gedruckte Werke gibt und dass es wenig reguliert sei, was als Überleben seltener oder einzigartiger Bestände gilt. Daraus folgt eine Frage, die auch für Unternehmen praktisch ist: Ab wann behandeln Organisationen Textquellen nicht mehr nur als Rohstoff für Training, sondern als potenzielles Erhaltungs- und Stewardship-Thema? Diese Logik berührt auch das, was der Fall als 2022er Schwelle rahmt: In einer Phase, in der KI-generierter Text stärker in den Textbestand eintritt, könnte sich das Verständnis dessen verändern, was wir als „gut bewahrtes“ Sammlungsgut betrachten.
Für KI-Organisationen bleibt dennoch der konkrete Engineering-Teil entscheidend. Wenn destruktives Scannen als skalierbarer Weg gilt, steht am Ende die gleiche technische Notwendigkeit wie zuvor: Modelle brauchen saubere, langformatige, möglichst unverzerrte Trainingsdaten. Genau hier liegt auch der Spannungsbogen, den die Unterlagen indirekt setzen: Der Zugang zu komplexem, unkorruptem Langtext wird als wertvoll beschrieben, und damit steigt der Druck, die Produktionsmittel für „große Sprachwelten“ kontrollierbar zu machen. In der Praxis bedeutet das: Datenbeschaffung wird zur strategischen Funktion, nicht nur zur Beschaffungstätigkeit – inklusive Nachweisbarkeit der Transformationsschritte, Prozessdisziplin in der Qualitätssicherung und klare Regeln, welche Datenklassen in Training, Evaluierung und Fine-Tuning einfließen. Wenn sich dieses Muster bei mehreren Anbietern durchsetzt, könnte sich die Datenpipeline grundlegend verändern: weniger Lizenzmanagement als operatives „Scanning-at-scale“ und mehr Infrastruktur für die Umwandlung analoger Quellen in Trainingskorpora.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "„Project Panama“: Destruktives Scannen von Büchern für KI-Training – was der Fall zeigt" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "„Project Panama“: Destruktives Scannen von Büchern für KI-Training – was der Fall zeigt" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »„Project Panama“: Destruktives Scannen von Büchern für KI-Training – was der Fall zeigt« bei Google Deutschland suchen, bei Bing oder Google News!