
LONDON (IT BOLTWISE) – CISOs planen den Sprung von teilweiser Autonomie hin zu weitgehend selbstständigen Aktionen in Security-Workflows. In einer Umfrage fühlen sich 36% heute für autonome „low-risk“-Schritte bereit, nach 12 Monaten erwarten 60% diese Sicherheit. Entscheidend ist dabei nicht die reine Leistungsfähigkeit der KI, sondern ein Stufenmodell aus Evidence Collection, Analyse, Empfehlung und Ausführung. Wer Autonomie ohne klare Belege, Reversibilität und Auditierbarkeit freischaltet, riskiert Eskalation statt Entlastung.
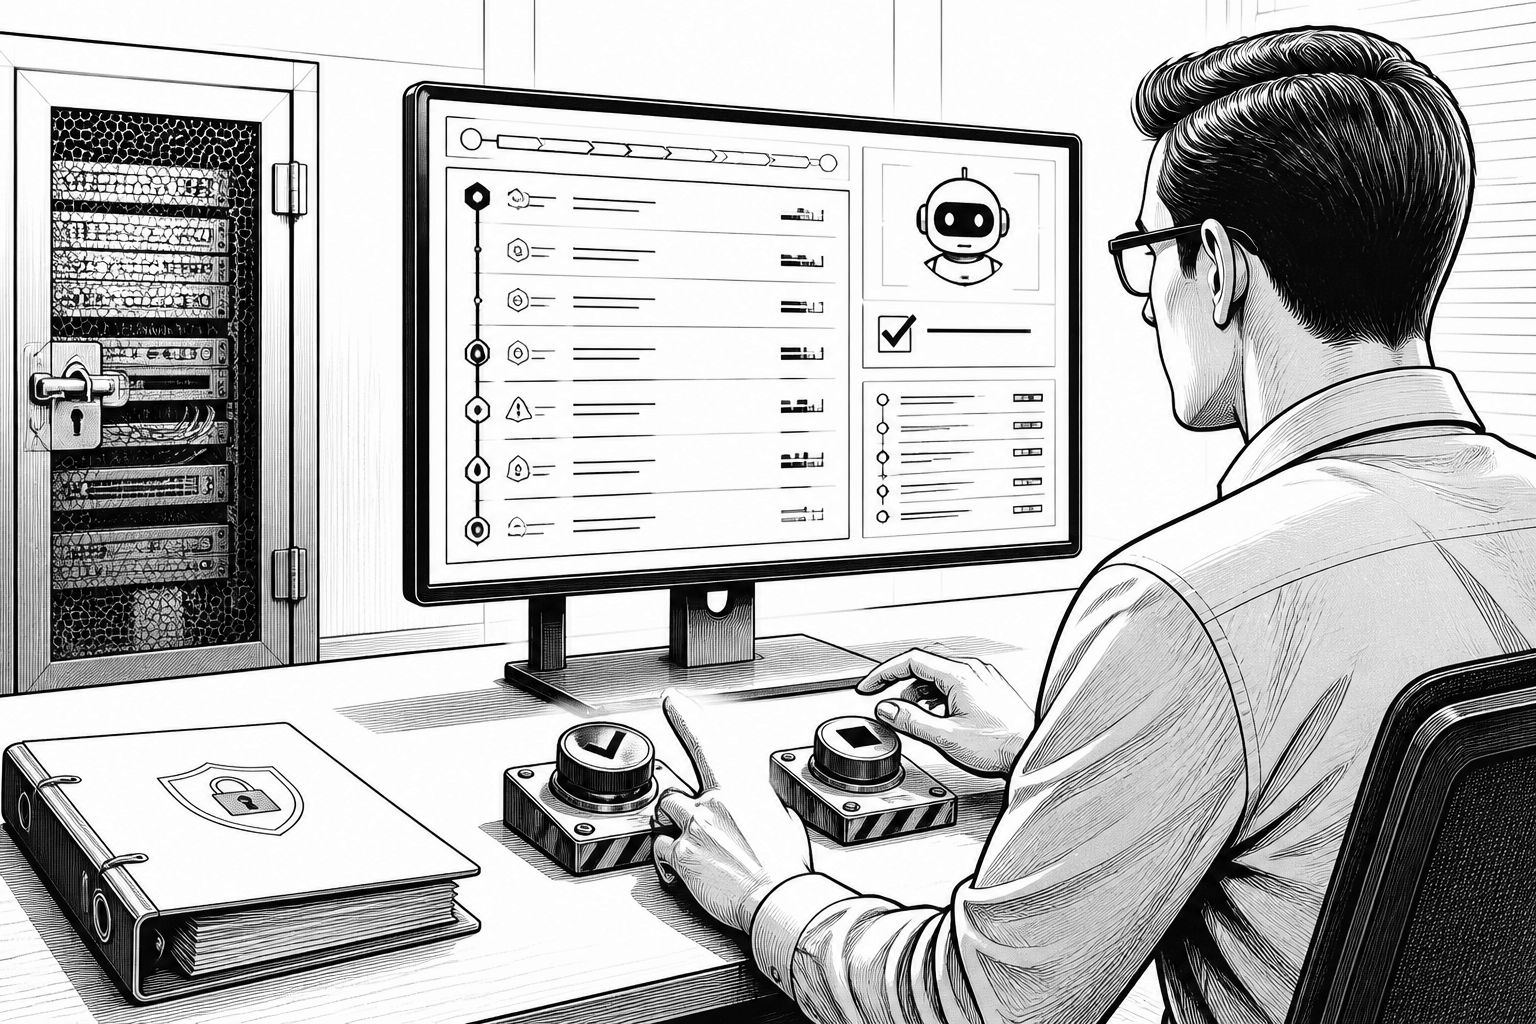
Security Operations Center (SOC) stehen vor einer Schlüsselfrage: Wie viel Handlungsfreiheit sollen KI-gestützte Agenten im laufenden Betrieb bekommen, ohne dass gleichzeitig die Angriffsfläche und der potenzielle Schaden durch Fehlentscheidungen wachsen? Die Debatte wird aktuell stark durch eine Umfrage unter CISOs geprägt, in der 36% der Befragten heute sagen, sie seien mit autonomen Handlungen von KI-Agenten bei low-risk-Security-Aktionen vertraut. Für die Erwartung in die nahe Zukunft ist genau das relevante Gegenstück: Innerhalb von 12 Monaten gehen 60% davon aus, dass sie diese Autonomieebene unterstützen werden. Gleichzeitig bleibt der Engpass im SOC offensichtlich: Selbst eine einzelne Warnmeldung erzeugt typischerweise Arbeit in mehreren Systemen, vom Nachziehen von Evidenz bis zur Rekonstruktion des Verlaufs und der Entscheidung, ob ein Incident wirklich zählt. In derselben Erhebung gilt deshalb als häufigste Sorge, dass KI-accelerierte Angriffe die Reaktionsfähigkeit des Teams überholen könnten; 55% der Teilnehmenden wählten diesen Punkt.
Viele Programme scheitern jedoch nicht an mangelnder KI-Kompetenz, sondern an der Art, wie Autonomie geplant wird. Häufig wird sie in der Praxis wie ein einzelner Regler behandelt – von „KI schlägt vor“ bis „KI handelt“. Der Beitrag argumentiert dagegen: Autonomie ist kein Schieberegler, sondern eine Folge von Entscheidungen entlang der konkreten Schritte im Workflow. Für Struktur liefert der Text ein älteres, in der Luftfahrt und im Air-Traffic-Kontext breit eingesetztes Referenzmodell: Automation lässt sich auf vier Funktionen verteilen – Informationsaufnahme, Informationsanalyse, Entscheidungs- und Aktionsauswahl sowie die konkrete Umsetzung. Übertragen auf Security Operations lässt sich daraus ein klares Mapping ableiten: Evidenzsammlung (z. B. SIEM- und EDR-Abfragen, Process-Tree-Extraktion, Anreicherung von Indikatoren sowie Identity- und Cloud-Kontext), Analyse und Urteil (Korrelation der gesammelten Daten, Rekonstruktion des Geschehens, Einordnung als echter Threat oder False Positive), Response Recommendation (z. B. Vorschläge wie Host isolieren, Credentials zurücksetzen oder den Fall schließen) und Response Execution (die tatsächliche Änderung im Zielsystem oder in der Umgebung). Genau dieses Staging macht es möglich, einzelne Stufen bewusst konservativer oder aggressiver zu behandeln.
Für die Praxis ergibt sich daraus ein zweigeteilter Steuerungsansatz: Wo Analystenzeit besonders teuer ist und Fehler vergleichsweise schnell erkannt werden, lässt sich Autonomie meist früher erhöhen. Das betrifft vor allem die ersten Stufen – Evidenzsammlung und oft auch Teile der Analyse. Wo jedoch ein falscher Schritt unmittelbar geschäftliche Wirkung entfaltet, sollten Teams die Ausführung stärker begrenzen. Um außerdem klarer zu kommunizieren, wie Menschen im Prozess eingebunden sind, nennt der Text eine Vokabel aus der Forschung der University of Washington: Fünf Autonomie-Level, die den menschlichen Modus beschreiben. Von Operator (L1) bis Observer (L5) reicht die Spanne: Der Mensch kann die Richtung vorgeben, gemeinsam mit der KI planen und ausführen, sich beraten lassen, als Approver auf Risiko- und vordefinierte Fälle beschränkt sein oder nur überwachen und jederzeit stoppen. Wichtig ist dabei die Trennung zwischen „kann“ und „darf“: Eine sehr leistungsfähige Agent-Implementierung kann trotzdem auf L2 laufen, wenn die Stakes oder die erwartete Fehlerfolgen das nahelegen. Der Text kombiniert das zusätzlich mit der in Unternehmen etablierten Unterscheidung „Human in the loop“ versus „Human on the loop“ – erstere bedeutet explizite Freigabe pro Aktion, letztere eher strategische Aufsicht. Für Anbieter- und Tool-Auswahl heißt das konkret: Nicht nur die Modellausgabe zählt, sondern ob beide Betriebsmodelle im SOC-Design sauber aufsetzbar sind.
Entscheidend wird die Frage, wie Teams für jede einzelne SOC-Aktion entscheiden, ob die KI nur unterstützt oder ob sie die nächsten Schritte selbst ausführen darf. Dafür nennt der Beitrag eine Art Rubrik aus drei überprüfbaren Dimensionen. Erstens: Reversibility, also wie schnell und vollständig sich eine Entscheidung rückgängig machen lässt. Zweitens: Blast radius, sprich wie viele Nutzer, Systeme oder Geschäftsprozesse die Aktion berührt. Drittens: Receipts – wie stark und verifizierbar ist die Evidenz, auf der die Entscheidung basiert. Das klingt im Abstract nach Governance, wird aber im Text an konkreten Beispielen greifbar. So wird etwa das reine Abfragen von SIEM/EDR- oder Identitätslogs als Schritt mit „nichts rückgängig zu machen“ beschrieben und startet deshalb oft bei einem sehr hohen Autonomielevel. Auch das Anreichern von Indikatoren oder das Ziehen von Process Trees kann demnach weitgehend eigenständig laufen. Umgekehrt werden Aktionen wie das Isolieren eines Produktionsservers oder eines Domain-Controllers als schwer rückgängig und mit „Business-wide“-Wirkung eingeordnet, weshalb hier eher niedrigere Autonomie bis hin zu einer Entscheidung durch Menschen plus Ausführung durch die KI gefordert wird. Das zentrale Argument: Die Rubrik erzwingt für jede Aktion eine explizite Platzierung im Prozess – statt eine einzige, zu lockere oder zu enge Standardpolitik für alles zu fahren.
Besonders kritisch wird es laut Text dort, wo „Human approval“ in der Praxis zur reinen Formalität verkommt. Eine Umfragekomponente zeigt: 52% der CISOs möchten, dass KI-Agenten nur mit menschlicher Freigabe handeln. Das kann sinnvoll sein – aber nur, wenn der Reviewer den notwendigen Kontext bekommt. Wenn eine Approval-Stufe ohne klare Kriterien oder Evidenz kommt, steigt der Druck, schnell „durchzuklicken“, um die Queue zu entlasten. Dann kippt Aufsicht in eine Illusion: Der Mensch genehmigt am Ende eine Schlussfolgerung, die er nie nachvollziehen konnte, weil der KI-Schritt die für ihn prüfbaren Zwischenbelege nicht liefert. Der Text beschreibt deshalb ein Mindestpaket für Approval-Requests: Welche Evidenz wurde gesammelt und aus welchen Quellen stammt sie? Wie lässt sich daraus die Verbindung zum Urteil herleiten? Und welche Prüfungen hat die KI durchgeführt, um Alternativen auszuschließen? Ein zusätzlicher Qualitätsmarker ist die Zeit: Wenn ein Reviewer die Entscheidung nicht innerhalb von ein bis zwei Minuten verifizieren kann, ist die Freigabe eher „zeremoniell“ als wirksam. In Summe wird so Autonomie zu etwas, das man verdient: Sie wächst, wenn die Belege belastbar sind, und schrumpft wieder, wenn die Übereinstimmung sinkt oder sich die Systemumgebung verändert.
Das Konzept „Autonomy you earn, autonomy you lose“ wird im Beitrag über drei praktische Kriterien konkretisiert. Erstens: Measured agreement, also eine vordefinierte Messung, wie oft die Agent-Verdikte mit Analystenbewertungen übereinstimmen, inklusive klarer Schwellenwerte. Zweitens: Dry runs zuerst, wobei neue Aktionsklassen in einem Testmodus laufen, der Logik demonstriert, aber Schreibzugriffe simuliert. Drittens: Ein vollständiger Evidence Trail und eine definierte Rollback-Strategie, damit Rückgängig-Machbarkeit im Ernstfall real und organisatorisch verankert ist. Diese Richtung deckt sich auch mit dem in der Agentic-Welt verbreiteten Prinzip „least privilege“ – im Text wird es erweitert zu „least agency“, also minimal notwendige Handlungsfreiheit. Gleichzeitig hebt der Beitrag einen zweiten Effekt hervor: Jede Autonomiestufe erhöht die potenzielle Schadenshöhe, falls ein Agent manipuliert, kompromittiert oder missverstanden wird. Damit wird der SOC-Agent wie ein neues privilegiertes Identitätsobjekt behandelt: eigene Identität statt geteilte Credentials, Permissions nur bis zum genehmigten Autonomielevel, vollständiges Logging jeder Tool-Interaktion und Überwachung mit denselben Detektionsmustern, die man auch für Administratorzugänge aufsetzt. Genau dort liegt die Brücke zur Marktrealität: Wenn Teams den Sprung von 36% auf 60% Autonomie über 12 Monate schaffen wollen, müssen sie neben Kapazitätsgewinn vor allem die Sicherheitsmechanismen im Agent-Design mitdenken.
Für die nächsten 12 Monate empfiehlt der Text ein Vorgehen, das eher „betrieblich“ als ideologisch wirkt. An erster Stelle steht die Inventarisierung: Welche Aktionen kann der Agent heute schon durchführen – von reinen Leseabfragen bis zu Response Actions – und wie lassen sie sich jeweils im Reversibility/Blast-radius/Receipts-Raster einordnen? Danach folgt eine priorisierte Automatisierung: Evidenzsammlung und Teile der Analyse sind typischerweise der erste Hebel, weil sie Analystenstunden binden, aber die Risiko- und Fehlerkosten meist geringer sind. Disruptive Response bleibt dagegen durch echte Evidenz und verifizierbare Approval-Workflows gating-geschützt. Zusätzlich sollten Teams Graduation- und Demotion-Kriterien vor dem Pilot festschreiben, inklusive Rollback-Plan. Der Beitrag positioniert das Ganze als „trust threshold“: Unterhalb dieser Schwelle unterstützt die KI noch, oberhalb übernimmt sie Ausführung, aber nur dann, wenn Tiefe und Belegkraft ausreichen. In dieser Logik ist die Proof-Last nicht Beiwerk, sondern der Mechanismus, mit dem Autonomie sicher erweitert werden kann – Schritt für Schritt, prüfbar und rückgängig, falls die Evidenzbasis nicht mehr trägt.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "AI-Agenten im SOC: Autonomie richtig dosieren statt „Alles oder nichts“" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "AI-Agenten im SOC: Autonomie richtig dosieren statt „Alles oder nichts“" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »AI-Agenten im SOC: Autonomie richtig dosieren statt „Alles oder nichts“« bei Google Deutschland suchen, bei Bing oder Google News!