
LONDON (IT BOLTWISE) – Ein Selbstversuch mit dem HP OmniBook Ultra zeigt, wie sich KI-Arbeit lokal ausführen lässt, ohne laufende Token-Gebühren. Im Test liefen ein Open-Weights-Modell, llama.cpp als Inferenz-Backend und Cline als KI-Coding-Harness direkt auf dem Gerät. Der wichtigste Effekt: Die Ausgaben waren nicht nur schnell, sondern auch klar nachvollziehbar, weil kein Cloud-Zugriff für Prompt und Dokumente nötig war. Gleichzeitig macht der Aufwand deutlich, warum viele Tools im Abo-Modell an Nutzungsgrenzen und Kostenprognosen scheitern.
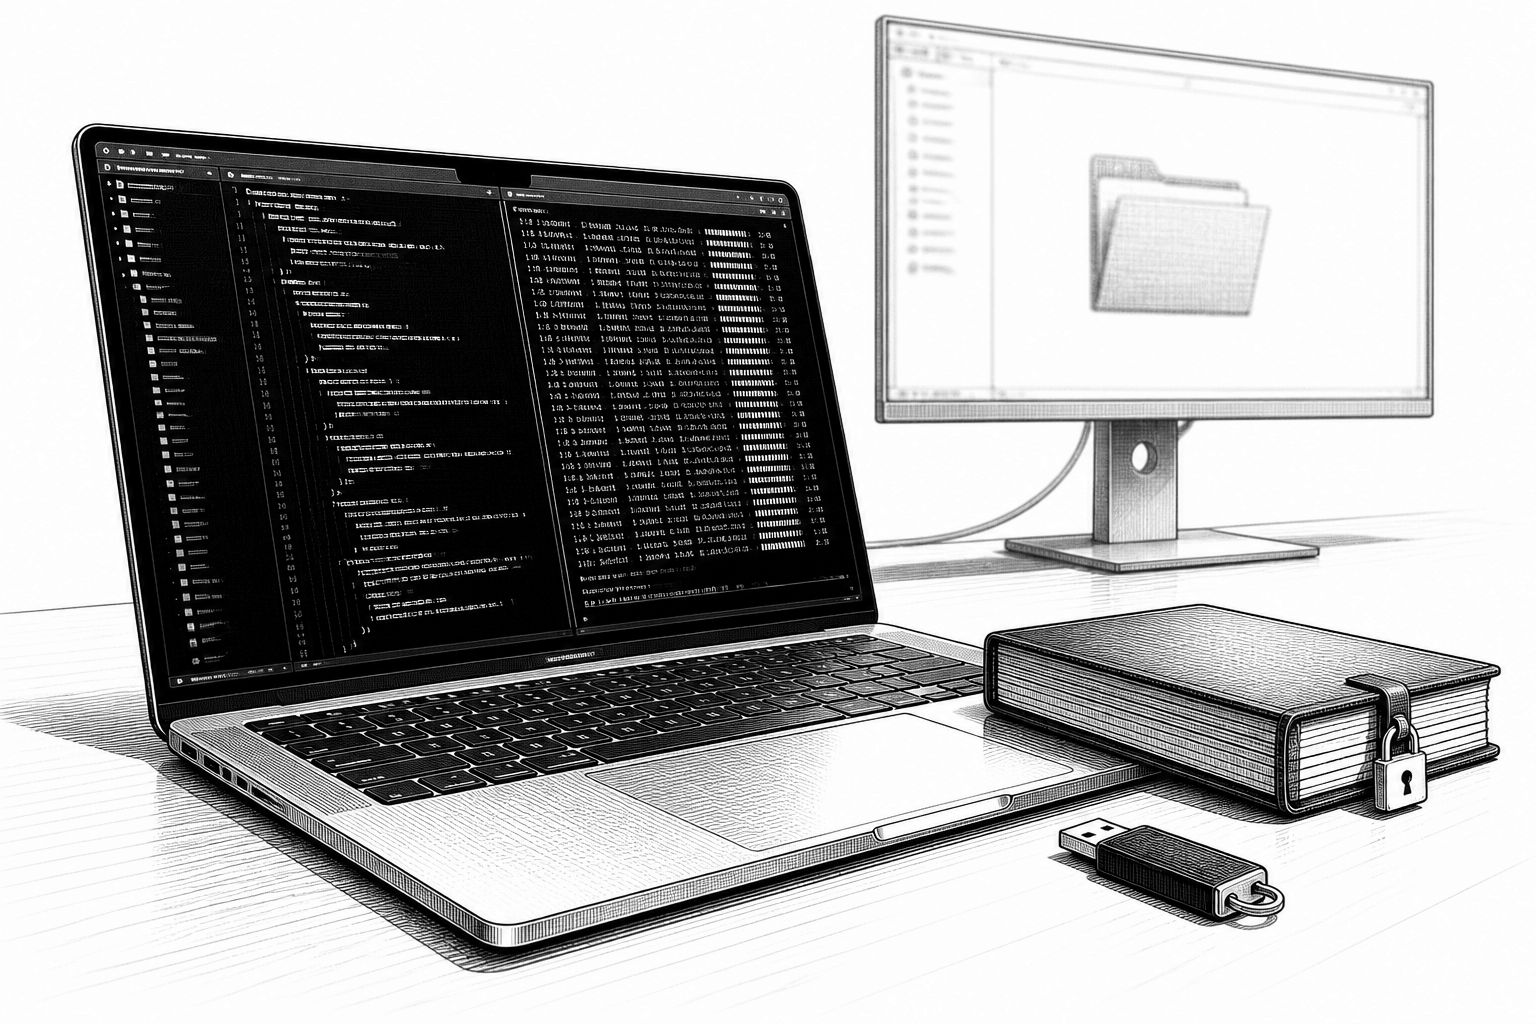
Die große Verlockung an lokalen KI-Setups ist selten die Modellqualität allein, sondern die Kombination aus Kontrolle und Kostenklarheit. Im Selbstversuch mit dem HP OmniBook Ultra fällt vor allem auf, dass der Autor seine KI-gestützte Coding-Workflow-Kette komplett offline steuerte: Er installierte sich ein Open-Source-Inferenz-Backend, lud ein Open-Weights-Language-Model und verband beides mit einer Agenten-Logik, die Code erzeugt und Tests ausführt. Damit entsteht ein „Private-By-Default“-Modell, bei dem Prompts, Dokumente und die eigentliche Inferenz auf der lokalen Hardware bleiben. Gleichzeitig zeigt der Artikel, warum viele Projekte in Abo-Umgebungen schnell an ein Kosten- und Planungsproblem geraten: Niemand kann verlässlich abschätzen, wie viele Tokens die Agentenarbeit tatsächlich verbraucht.
Hardwareseitig ist das OmniBook Ultra als „Laptop als persönlicher Datenzentrums-Ersatz“ inszeniert. Laut Quelle arbeitet es auf NVIDIA-RX-Traffic auf Basis der RTX-Spark-Architektur, mit 128 GB Unified Memory, 2 TB schnellem Gen5-NVMe-Speicher sowie einem 16-Zoll-OLED-Display. Bemerkenswert ist dabei weniger das Display, sondern die Speicher- und Durchsatzbasis: Für lokale KI-Arbeit wird Unified Memory zum praktischen Hebel, weil große Modelle und Zwischendaten weniger „zwischen Welten“ gepackt werden müssen. Der Artikel ordnet das Gerät dabei in Richtung ernsthafter AI-Workloads ein und nennt eine FP4-Performance von 1 Petaflops als zentrale Kennzahl. Dass das System trotz mehrstündiger Agentenläufe akustisch präsent ist, aber laut Test nicht unangenehm heiß wurde, macht klar, wie stark Dauerlast bei lokalen Inferenz-Workloads in der Praxis am Kühlsystem hängt.
Die eigentliche Projektgeschwindigkeit entsteht dann nicht durch „magische“ Modellfähigkeiten, sondern durch die Architektur des Agenten-Setups. Der Autor nutzte zunächst Copilot, um die Arbeitsumgebung initial zu konfigurieren, und setzte anschließend auf llama.cpp als Inferenz-Runtime. Als Modell kam Qwen3.8-27B zum Einsatz; als KI-Coding-Harness diente Cline, eingebettet als Extension in Visual Studio Code. Der Ablauf war dabei bewusst agentisch: Copilot half bei der Tool-Konfiguration, anschließend lieferte der Autor einen detaillierten App-Spec in den Agenten, und Cline übernahm den Kernprozess aus Code schreiben, Tests ausführen, Ergebnisse beobachten, Änderungen vornehmen und wieder testen. Interessant ist, wie „human-in-the-loop“ hier ganz konkret wirkt: In regelmäßigen Abständen musste der Nutzer Freigaben geben, ansonsten lief der Prozess weitgehend autonom, bis die nächsten Entscheidungen anstanden. Dadurch verkürzte sich die Setup-Phase auf etwa eine halbe Stunde, während reine Handarbeit für das gleiche Ziel laut Quelle Wochen verschlungen hätte.
Technisch bekommt die Arbeit eine zweite Ebene, weil der Agent nicht nur Code erstellt, sondern auch Wissens- und Datenbeschaffung übernimmt. Der Autor fütterte dem Modell ein Spreadsheet mit Links zu eigenen Artikeln und ließ es nahezu alle Einträge abrufen. Zusätzlich baute der Agent eine separate Routine, um auch Seiten aus dem Internet Archive’s Wayback Machine zu ziehen, konkret für ungefähr 90 Links, die zuvor 404 lieferten. Für eine weitere Gruppe von rund 90 Seiten, die der Agent nicht zuverlässig abrufen konnte, musste der Nutzer anschließend rund 30 Minuten lang nachbessern und Ursachen klären. Am Ende standen zwei Ergebnisordner mit je 1.951 Dateien bereit: einmal im Rohformat als HTML und einmal im Markdown-Format. Zusätzlich implementierte die lokale KI eine einfache Routine, um später neue Posts automatisch ins Archiv aufzunehmen. Genau dieses „Workflow-Verlängerungsgefühl“ ist ein typischer Vorteil lokaler Agenten: Das Ergebnis wird nicht nur produziert, sondern in wiederholbare Abläufe gegossen.
Kosten und Planbarkeit sind im Artikel der zentrale Kontrast zu Abo-Modellen. Der komplette Projektlauf bestand aus 479 LLM-Inferenzaufrufen und verarbeitete nahezu 50 Millionen logische Tokens; die Netto-Kosten wurden mit exakt 0,00 US-Dollar angegeben, weil die Inferenz lokal lief und damit keine tokenbasierten Cloud-Gebühren anfielen. Gleichzeitig wird ein Problem deutlich, das viele Entwickler aus dem Alltag kennen: Agenten-Tools machen es Nutzern schwer, den Token-Verbrauch im Voraus zu schätzen. Selbst wenn ein kommerzielles Abo die Rechenleistung liefert, bleibt der „Billing-Faktor“ unklar, weil er von Kontextlänge, Iterationszahl, Debugging-Schleifen und Modellwahl abhängt. Der Artikel vergleicht dazu monatliche Einstiegsmodelle wie ChatGPT Plus, Claude Code Pro oder GitHub Copilot (jeweils im Bereich von 10 bis 20 US-Dollar pro Monat) und argumentiert, dass man für größere Agentenarbeiten sehr schnell an Nutzungsgrenzen stößt oder in teurere Tarife wechseln müsste. Der Hinweis auf eine Aussage aus einem Podcast – wonach die Top-Nutzer einer bestimmten Claude-Code-Kategorie im Schnitt 18.000 US-Dollar jährlich ausgeben, während Nicht-Nutzer deutlich darunter liegen – unterstreicht, dass „Abo statt Metering“ in der Praxis kein Freifahrtschein ist, wenn Agenten produktiv und intensiv eingesetzt werden.
Am Ende läuft das Argument auf zwei Kernvorteile hinaus: Experimentierfreiheit ohne laufende Rechnung und ein Datenschutz-„Default“, weil nichts in die Cloud wandert. Der Autor beschreibt, dass sein konkreter Test zwar auf veröffentlichtem Web-Inhalt beruhte, er aber andere Szenarien plant, bei denen eine lokale Ausführung klarer wäre – beispielsweise ein Stapel Finanzdokumente, Kreditkartenabrechnungen und Rechnungen. In so einem Szenario ist nicht nur die technische Latenz relevant, sondern vor allem die Frage, ob sensible Daten das Gerät verlassen. Genau dort verschiebt sich der Nutzen von „lokal“ von einer Spielerei zu einer strategischen Option für Unternehmen, die KI-gestützte Entwicklung nutzen wollen, ohne ihre Datenflüsse permanent neu zu verhandeln. Ob sich die rund 7.000 US-Dollar Investition für das OmniBook Ultra lohnen, bleibt eine ROI-Frage, die der Autor zugespitzt beantwortet: Für gelegentliche Versuche wäre sie schwer zu rechtfertigen, für fortlaufende, größere Coding- und Datenaufbereitungsfälle aber wird sie zumindest plausibler. Die Quelle verweist zudem darauf, dass sich Rechenleistung typischerweise mit der Zeit deutlich günstiger replizieren lässt – und dass das OmniBook Ultra damit eher ein aktueller Hochleistungs-Zwischenschritt ist als eine dauerhaft „perfekte“ Preis-/Leistungsrelation.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "HP OmniBook Ultra im Selbstversuch: Lokale KI ohne Token-Kosten" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "HP OmniBook Ultra im Selbstversuch: Lokale KI ohne Token-Kosten" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »HP OmniBook Ultra im Selbstversuch: Lokale KI ohne Token-Kosten« bei Google Deutschland suchen, bei Bing oder Google News!